
tensorflow用dropout解决over fitting-【老鱼学tensorflow】
在机器学习中可能会存在过拟合的问题,表现为在训练集上表现很好,但在测试集中表现不如训练集中的那么好。
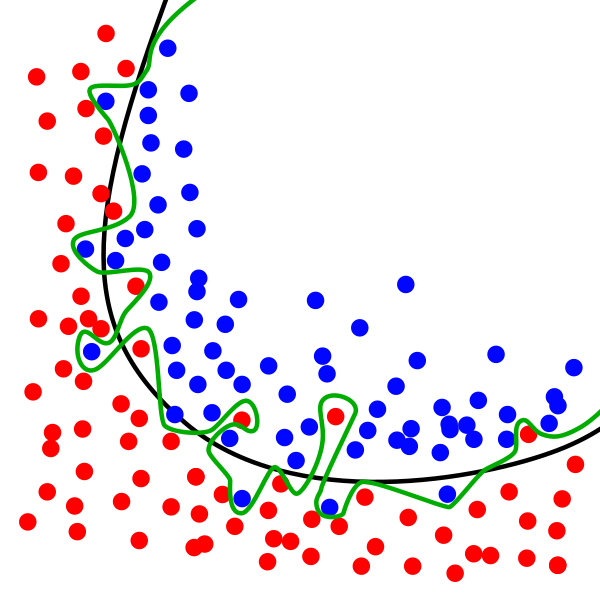
图中黑色曲线是正常模型,绿色曲线就是overfitting模型。尽管绿色曲线很精确的区分了所有的训练数据,但是并没有描述数据的整体特征,对新测试数据的适应性较差。
一般用于解决过拟合的方法有增加权重的惩罚机制,比如L2正规化,但在本处我们使用tensorflow提供的dropout方法,在训练的时候, 我们随机忽略掉一些神经元和神经联结 , 使这个神经网络变得”不完整”. 用一个不完整的神经网络训练一次.
到第二次再随机忽略另一些, 变成另一个不完整的神经网络. 有了这些随机 drop 掉的规则, 我们可以想象其实每次训练的时候, 我们都让每一次预测结果都不会依赖于其中某部分特定的神经元. 像l1, l2正规化一样, 过度依赖的 W , 也就是训练参数的数值会很大, l1, l2会惩罚这些大的 参数. Dropout 的做法是从根本上让神经网络没机会过度依赖.
本次我们使用之前sklearn中手写数字作为例子来进行。
加载数据
from sklearn.datasets import load_digits

from sklearn.preprocessing import LabelBinarizer

digits = load_digits()

X = digits.data

y = digits.target

# 把数值转换成one hot格式,例如:数字4就会被转换成:[0 0 0 0 1 0 0 0 0 0]

y = LabelBinarizer().fit_transform(y)

# 拆分数据集,以总量的30%作为测试集

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3)
添加层
添加层函数如下:
import tensorflow as tf

def add_layer(inputs, in_size, out_size, activation_function=None):

    """

    添加层

    :param inputs: 输入数据

    :param in_size: 输入数据的列数

    :param out_size: 输出数据的列数

    :param activation_function: 激励函数

    :return:

    """

    # 定义权重,初始时使用随机变量,可以简单理解为在进行梯度下降时的随机初始点,这个随机初始点要比0值好,因为如果是0值的话,反复计算就一直是固定在0中,导致可能下降不到其它位置去。

    Weights = tf.Variable(tf.random_normal([in_size, out_size]))

    # 偏置shape为1行out_size列

    biases = tf.Variable(tf.zeros([1, out_size]) + 0.1)

    # 建立神经网络线性公式:inputs * Weights + biases,我们大脑中的神经元的传递基本上也是类似这样的线性公式,这里的权重就是每个神经元传递某信号的强弱系数,偏置值是指这个神经元的原先所拥有的电位高低值

    Wx_plus_b = tf.matmul(inputs, Weights) + biases

    if activation_function is None:

        # 如果没有设置激活函数,则直接就把当前信号原封不动地传递出去

        outputs = Wx_plus_b

    else:

        # 如果设置了激活函数,则会由此激活函数来对信号进行传递或抑制

        outputs = activation_function(Wx_plus_b)

    return outputs
定义placehoder和创建实际的网络结构
# 定义placeholder

# 输入的手写数字大小为8*8单位的数据

xs = tf.placeholder(tf.float32, [None, 8*8])

# 输出值为one hot结构的数据

ys = tf.placeholder(tf.float32, [None, 10])

# 添加层

# 第一层输入为8*8单位的手写输入数字图像,输出设定为100个神经元的层(为了能够看出是overfitting的问题),激活函数一般用tanh比较好

l1 = add_layer(xs, 8*8, 100, activation_function=tf.nn.tanh)

# 输出层因为最终是一个one hot的结构,因此输出的大小为10,激活函数用softmax

prediction = add_layer(l1, 100, 10, activation_function=tf.nn.softmax)
定义损失函数
# 定义损失函数

cross_entropy = tf.reduce_mean(-tf.reduce_sum(ys * tf.log(prediction), axis=1))

# 在tensorboard中记录损失函数值

tf.summary.scalar('loss', cross_entropy)

# 用梯度下降优化器进行训练

train_step = tf.train.GradientDescentOptimizer(0.6).minimize(cross_entropy)
记录损失函数并运行
sess = tf.Session()

merged = tf.summary.merge_all()

# 分别记录训练集的loss和测试集的loss值,目的是为了能够对比训练集和测试集中得拟合情况

train_writer = tf.summary.FileWriter("D:/todel/data/tensorflow/train", sess.graph)

test_writer = tf.summary.FileWriter("D:/todel/data/tensorflow/test", sess.graph)

init = tf.global_variables_initializer()

sess.run(init)

for i in range(500):

    sess.run(train_step, feed_dict={xs:X_train, ys:y_train})

    if i % 50 == 0:

        # 分别用训练集和测试集数据获得损失函数值

        train_result = sess.run(merged, feed_dict={xs:X_train, ys: y_train})

        train_writer.add_summary(train_result, i)

        test_result = sess.run(merged, feed_dict={xs:X_test, ys: y_test})

        test_writer.add_summary(test_result, i)
完整代码
from sklearn.datasets import load_digits

from sklearn.preprocessing import LabelBinarizer

from sklearn.model_selection import train_test_split

digits = load_digits()

X = digits.data

y = digits.target

# 把数值转换成one hot格式,例如:数字4就会被转换成:[0 0 0 0 1 0 0 0 0 0]

y = LabelBinarizer().fit_transform(y)

# 拆分数据集,以总量的30%作为测试集

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3)

import tensorflow as tf

def add_layer(inputs, in_size, out_size, activation_function=None):

    """

    添加层

    :param inputs: 输入数据

    :param in_size: 输入数据的列数

    :param out_size: 输出数据的列数

    :param activation_function: 激励函数

    :return:

    """

    # 定义权重,初始时使用随机变量,可以简单理解为在进行梯度下降时的随机初始点,这个随机初始点要比0值好,因为如果是0值的话,反复计算就一直是固定在0中,导致可能下降不到其它位置去。

    Weights = tf.Variable(tf.random_normal([in_size, out_size]))

    # 偏置shape为1行out_size列

    biases = tf.Variable(tf.zeros([1, out_size]) + 0.1)

    # 建立神经网络线性公式:inputs * Weights + biases,我们大脑中的神经元的传递基本上也是类似这样的线性公式,这里的权重就是每个神经元传递某信号的强弱系数,偏置值是指这个神经元的原先所拥有的电位高低值

    Wx_plus_b = tf.matmul(inputs, Weights) + biases

    if activation_function is None:

        # 如果没有设置激活函数,则直接就把当前信号原封不动地传递出去

        outputs = Wx_plus_b

    else:

        # 如果设置了激活函数,则会由此激活函数来对信号进行传递或抑制

        outputs = activation_function(Wx_plus_b)

    return outputs

# 定义placeholder

# 输入的手写数字大小为8*8单位的数据

xs = tf.placeholder(tf.float32, [None, 8*8])

# 输出值为one hot结构的数据

ys = tf.placeholder(tf.float32, [None, 10])

# 添加层

# 第一层输入为8*8单位的手写输入数字图像,输出设定为100个神经元的层(为了能够看出是overfitting的问题),激活函数一般用tanh比较好

l1 = add_layer(xs, 8*8, 100, activation_function=tf.nn.tanh)

# 输出层因为最终是一个one hot的结构,因此输出的大小为10,激活函数用softmax

prediction = add_layer(l1, 100, 10, activation_function=tf.nn.softmax)

# 定义损失函数

cross_entropy = tf.reduce_mean(-tf.reduce_sum(ys * tf.log(prediction), axis=1))

# 在tensorboard中记录损失函数值

tf.summary.scalar('loss', cross_entropy)

# 用梯度下降优化器进行训练

train_step = tf.train.GradientDescentOptimizer(0.6).minimize(cross_entropy)

sess = tf.Session()

merged = tf.summary.merge_all()

# 分别记录训练集的loss和测试集的loss值,目的是为了能够对比训练集和测试集中得拟合情况

train_writer = tf.summary.FileWriter("D:/todel/data/tensorflow/train", sess.graph)

test_writer = tf.summary.FileWriter("D:/todel/data/tensorflow/test", sess.graph)

init = tf.global_variables_initializer()

sess.run(init)

for i in range(500):

    sess.run(train_step, feed_dict={xs:X_train, ys:y_train})

    if i % 50 == 0:

        # 分别用训练集和测试集数据获得损失函数值

        train_result = sess.run(merged, feed_dict={xs:X_train, ys: y_train})

        train_writer.add_summary(train_result, i)

        test_result = sess.run(merged, feed_dict={xs:X_test, ys: y_test})

        test_writer.add_summary(test_result, i)
输出结果
当我们运行了上面的代码后,会在D:/todel/data/tensorflow/目录下生成tensorboard收集的日志文件,我们可以在那个目录下输入:
最终在tensorboard中显示的图形为:
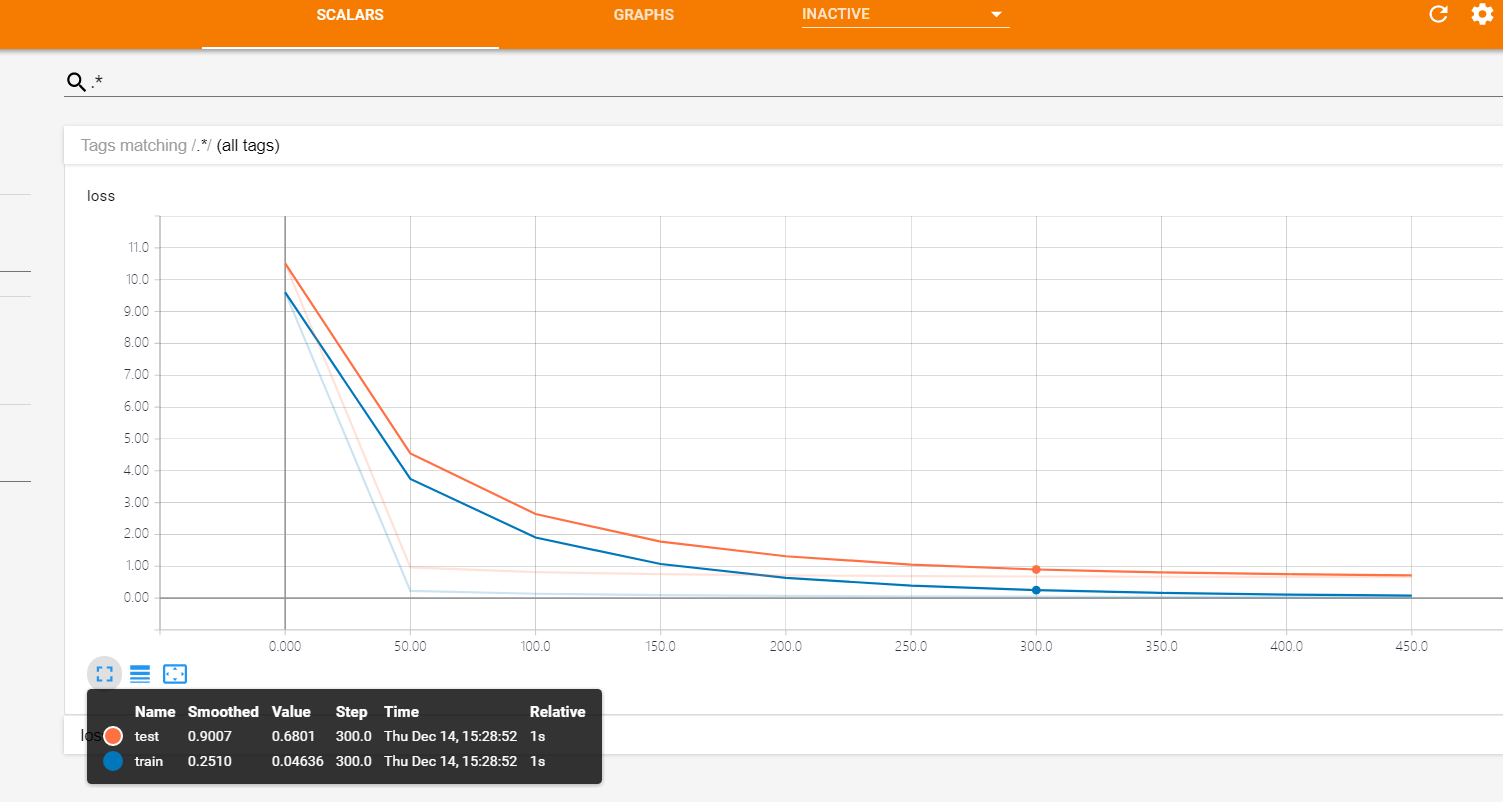
我们发现,训练集(蓝色的那条曲线)损失值要比测试集(黄色的那条曲线)小,这样就存在过拟合的情况。
消除过拟合
为了消除过拟合,我们采用dropout方式来进行。
首先设置一个保留概率的placeholder,这样在运行时可以通过参数来进行设置
# 设置保留概率,即我们要保留的结果所占比例,它作为一个placeholder,在run时传入, 当keep_prob=1的时候,相当于100%保留,也就是dropout没有起作用。

keep_prob = tf.placeholder(tf.float32)
然后在add_layer函数中调用dropout功能:
    # 调用dropout功能

    Wx_plus_b = tf.nn.dropout(Wx_plus_b, keep_prob)
最后在训练时设置保留的概率,但在获得损失值时用全部的数据来进行获取:
for i in range(500):

    sess.run(train_step, feed_dict={xs:X_train, ys:y_train, keep_prob: 0.7})

    if i % 50 == 0:

        # 分别用训练集和测试集数据获得损失函数值

        train_result = sess.run(merged, feed_dict={xs:X_train, ys: y_train, keep_prob:1})

        train_writer.add_summary(train_result, i)

        test_result = sess.run(merged, feed_dict={xs:X_test, ys: y_test, keep_prob:1})

        test_writer.add_summary(test_result, i)
这样全部代码为:
from sklearn.datasets import load_digits

from sklearn.preprocessing import LabelBinarizer

from sklearn.model_selection import train_test_split

digits = load_digits()

X = digits.data

y = digits.target

# 把数值转换成one hot格式,例如:数字4就会被转换成:[0 0 0 0 1 0 0 0 0 0]

y = LabelBinarizer().fit_transform(y)

# 拆分数据集,以总量的30%作为测试集

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3)

import tensorflow as tf

def add_layer(inputs, in_size, out_size, activation_function=None):

    """

    添加层

    :param inputs: 输入数据

    :param in_size: 输入数据的列数

    :param out_size: 输出数据的列数

    :param activation_function: 激励函数

    :return:

    """

    # 定义权重,初始时使用随机变量,可以简单理解为在进行梯度下降时的随机初始点,这个随机初始点要比0值好,因为如果是0值的话,反复计算就一直是固定在0中,导致可能下降不到其它位置去。

    Weights = tf.Variable(tf.random_normal([in_size, out_size]))

    # 偏置shape为1行out_size列

    biases = tf.Variable(tf.zeros([1, out_size]) + 0.1)

    # 建立神经网络线性公式:inputs * Weights + biases,我们大脑中的神经元的传递基本上也是类似这样的线性公式,这里的权重就是每个神经元传递某信号的强弱系数,偏置值是指这个神经元的原先所拥有的电位高低值

    Wx_plus_b = tf.matmul(inputs, Weights) + biases

    # 调用dropout功能

    Wx_plus_b = tf.nn.dropout(Wx_plus_b, keep_prob)

    if activation_function is None:

        # 如果没有设置激活函数,则直接就把当前信号原封不动地传递出去

        outputs = Wx_plus_b

    else:

        # 如果设置了激活函数,则会由此激活函数来对信号进行传递或抑制

        outputs = activation_function(Wx_plus_b)

    return outputs

# 定义placeholder

# 输入的手写数字大小为8*8单位的数据

xs = tf.placeholder(tf.float32, [None, 8*8])

# 输出值为one hot结构的数据

ys = tf.placeholder(tf.float32, [None, 10])

# 设置保留概率,即我们要保留的结果所占比例,它作为一个placeholder,在run时传入, 当keep_prob=1的时候,相当于100%保留,也就是dropout没有起作用。

keep_prob = tf.placeholder(tf.float32)

# 添加层

# 第一层输入为8*8单位的手写输入数字图像,输出设定为100个神经元的层(为了能够看出是overfitting的问题),激活函数一般用tanh比较好

l1 = add_layer(xs, 8*8, 100, activation_function=tf.nn.tanh)

# 输出层因为最终是一个one hot的结构,因此输出的大小为10,激活函数用softmax

prediction = add_layer(l1, 100, 10, activation_function=tf.nn.softmax)

# 定义损失函数

cross_entropy = tf.reduce_mean(-tf.reduce_sum(ys * tf.log(prediction), axis=1))

# 在tensorboard中记录损失函数值

tf.summary.scalar('loss', cross_entropy)

# 用梯度下降优化器进行训练

train_step = tf.train.GradientDescentOptimizer(0.6).minimize(cross_entropy)

sess = tf.Session()

merged = tf.summary.merge_all()

# 分别记录训练集的loss和测试集的loss值,目的是为了能够对比训练集和测试集中得拟合情况

train_writer = tf.summary.FileWriter("D:/todel/data/tensorflow/train", sess.graph)

test_writer = tf.summary.FileWriter("D:/todel/data/tensorflow/test", sess.graph)

init = tf.global_variables_initializer()

sess.run(init)

for i in range(500):

    sess.run(train_step, feed_dict={xs:X_train, ys:y_train, keep_prob: 0.7})

    if i % 50 == 0:

        # 分别用训练集和测试集数据获得损失函数值

        train_result = sess.run(merged, feed_dict={xs:X_train, ys: y_train, keep_prob:1})

        train_writer.add_summary(train_result, i)

        test_result = sess.run(merged, feed_dict={xs:X_test, ys: y_test, keep_prob:1})

        test_writer.add_summary(test_result, i)
运行后输出tensorboard图形为(记得把之前的文件或目录进行删除并运行tensorboard进行显示图形):
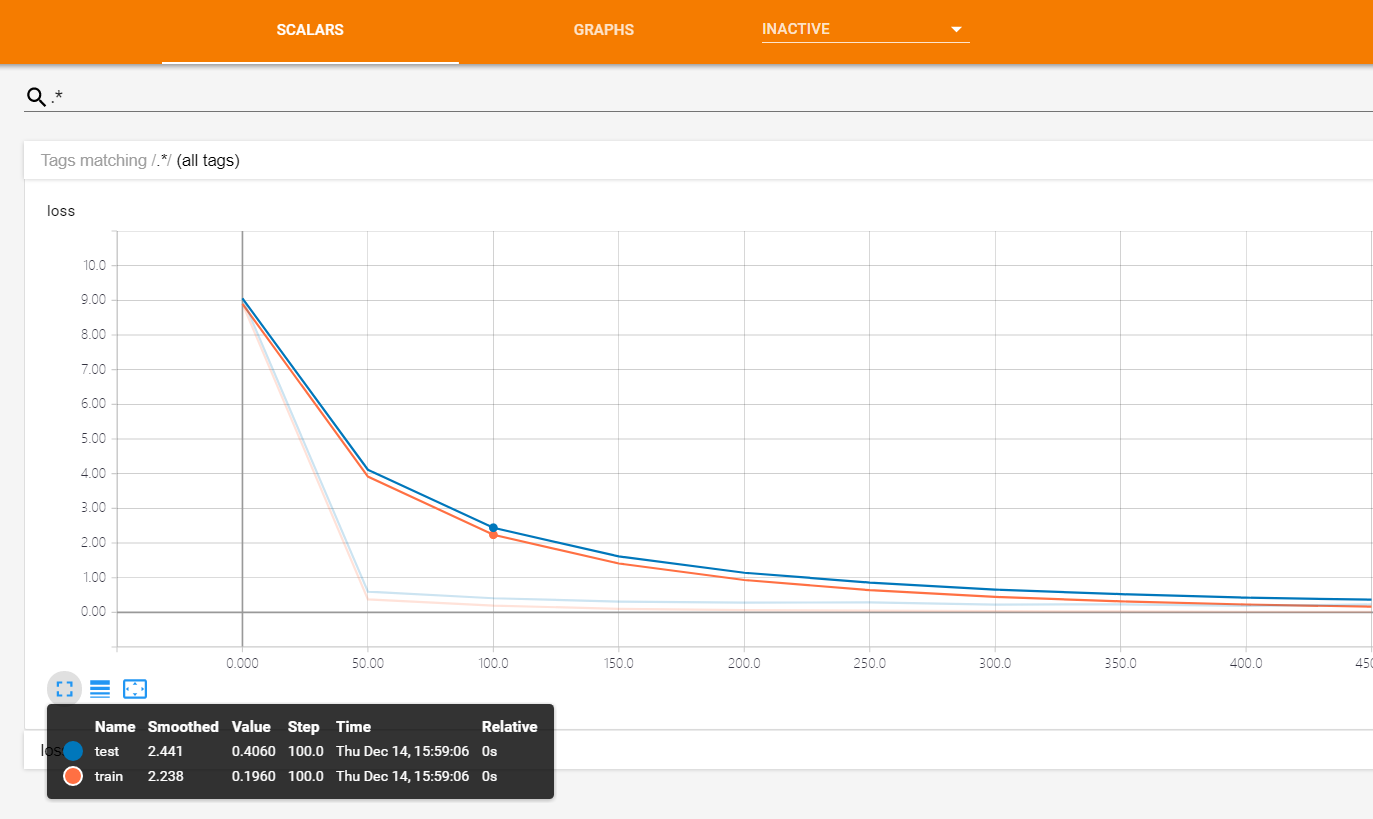
这样训练集和测试集的损失值就比较接近了。
tensorflow用dropout解决over fitting-【老鱼学tensorflow】的更多相关文章
- tensorflow卷积神经网络-【老鱼学tensorflow】
前面我们曾有篇文章中提到过关于用tensorflow训练手写2828像素点的数字的识别,在那篇文章中我们把手写数字图像直接碾压成了一个784列的数据进行识别,但实际上,这个图像是2828长宽结构的,我 ...
- tensorflow分类-【老鱼学tensorflow】
前面我们学习过回归问题,比如对于房价的预测,因为其预测值是个连续的值,因此属于回归问题. 但还有一类问题属于分类的问题,比如我们根据一张图片来辨别它是一只猫还是一只狗.某篇文章的内容是属于体育新闻还是 ...
- tensorflow Tensorboard可视化-【老鱼学tensorflow】
tensorflow自带了可视化的工具:Tensorboard.有了这个可视化工具,可以让我们在调整各项参数时有了可视化的依据. 本次我们先用Tensorboard来可视化Tensorflow的结构. ...
- tensorflow 传入值-【老鱼学tensorflow】
上个文章中讲述了tensorflow中如何定义变量以及如何读取变量的方式,本节主要讲述关于传入值. 变量主要用于在tensorflow系统中经常会被改变的值,而对于传入值,它只是当tensorflow ...
- tensorflow用dropout解决over fitting
在机器学习中可能会存在过拟合的问题,表现为在训练集上表现很好,但在测试集中表现不如训练集中的那么好. 图中黑色曲线是正常模型,绿色曲线就是overfitting模型.尽管绿色曲线很精确的区分了所有的训 ...
- tensorflow RNN循环神经网络 (分类例子)-【老鱼学tensorflow】
之前我们学习过用CNN(卷积神经网络)来识别手写字,在CNN中是把图片看成了二维矩阵,然后在二维矩阵中堆叠高度值来进行识别. 而在RNN中增添了时间的维度,因为我们会发现有些图片或者语言或语音等会在时 ...
- tensorflow保存读取-【老鱼学tensorflow】
当我们对模型进行了训练后,就需要把模型保存起来,便于在预测时直接用已经训练好的模型进行预测. 保存模型的权重和偏置值 假设我们已经训练好了模型,其中有关于weights和biases的值,例如: im ...
- tensorflow Tensorboard2-【老鱼学tensorflow】
前面我们用Tensorboard显示了tensorflow的程序结构,本节主要用Tensorboard显示各个参数值的变化以及损失函数的值的变化. 这里的核心函数有: histogram 例如: tf ...
- tensorflow优化器-【老鱼学tensorflow】
tensorflow中的优化器主要是各种求解方程的方法,我们知道求解非线性方程有各种方法,比如二分法.牛顿法.割线法等,类似的,tensorflow中的优化器也只是在求解方程时的各种方法. 比较常用的 ...
随机推荐
- Linux-系统调用理解
系统调用即为Linux内核中设置的一组用于实现各种系统功能的子程序,操作系统通过系统调用为运行在其上的进程提供服务. 由于进程一般不能访问内核所占内存空间以及调用内核函数,为了与用户态进程进行交互,内 ...
- 20175209 《Java程序设计》第九周学习总结
20175209 <Java程序设计>第九周学习总结 一.教材知识点总结 有关数据库下载中存在可能出现的问题已经在博客<数据库安装和使用过程中出现的一些问题>给出了相应的解决办 ...
- CentOS安装glibc-2.14
CentOS安装glibc-2.14 到http://ftp.gnu.org/gnu/glibc/下载glibc-2.14.tar.gz wget https://ftp.gnu.org/gnu/ ...
- Redis非关系型数据库
1.简介 Redis是一个基于内存的Key-Value非关系型数据库,由C语言进行编写. Redis一般作为分布式缓存框架.分布式下的SESSION分离.分布式锁的实现等等. Redis速度快的原因: ...
- Turtle库的学习积累
1.什么是turtle库 Python的Turtle库是一个直观有趣的图形绘制函数库,Turtle英文翻译过来是乌龟的意思,在绘图时可以想象成一只乌龟在移动. 2.绘图坐标体系 海龟的移动方向 3.绘 ...
- Aras SP9前端传递参数给后端方法使用
//前端JSvar doc = top.aras.createXMLDocument(); doc.loadXML("<body/>"); doc.documentEl ...
- go语言圣经练习
练习 3.10: 编写一个非递归版本的comma函数,使用bytes.Buffer代替字符串链接操作. package main import ( "fmt" "os&q ...
- windows 下启动运行 jar 包程序
windows 下 运行 jar 包 java -jar XXX.jar java -server -Xms1024m -Xmx20480m -jar $JAR_NAME.jar windows 后台 ...
- 如何识别Studio 5000程序开发版本号
前言:中.大型AB PLC的编程软件从以前的RSLogix 5000到目前的Studio 5000,都是有版本号的,如RSLogix 5000 V19.0.Studio 5000 V32.高版本的软件 ...
- 查看变更(git diff)
git diff命令 如果想要知道变更的具体内容,可以使用git diff命令.它被用来解决两个问题: 哪些变更还没有被暂存? 那些已暂存的变更正待提价? git diff在git status基础上 ...