
python统计喜欢的小说主角出场次数
这周老师布置了一项作业,让我们回去将自己喜欢的小说里面的主角出场次数统计出来,我对这个充满了兴趣,但我遇到了三个问题:
(1)一开始选了一部超长的小说(最爱之一),但是运行时老是不行,老是显示下图错误:

(2)我一开始是像书本那样直接把txt文件名打上去,类似于open(‘two.txt’,'r').read(),但总是出现一下一行字:

(3)三个字的人名总是会有几个人只打了两个字
一、撇开这些问题,开始写代码:
我刚开始以为是小说太长了,运行不了,就找了一部短一些的小说,我最爱的小说——《我和你差之微毫的世界》
结果成功了
代码如下:
import jieba

txt=open("d:\\《我和你差之微毫的世界》北倾.txt","r").read()

others={'有些','自己','已经','知道','时候','刚刚','一下','看着','没有','像是','一个','一眼','好像','什么','声音','这样','起来','这么','回来','就是','微微','一声',

        '这个','这才','目光','看见','觉得','过来','不是','怎么','现在','突然','一会','还是','几分','一起','顿时','回去','眼神','安然','只是','原本','出去','似乎',

        '眼睛','下来','整个','手指','两个','因为','一直','电话','语气','问道','出来','心里','开始','门口','这里','那么','房间','那个','格外','灯光','时间','回答','一般','转身',

        '几乎','事情','坐在','说话','表情'}

words= jieba.lcut(txt)   #jieba将txt分成多个分词

counts={}    #建立一个空字典

for word in words:    #这里的word是指遍历从txt的第一个分词到最后一个分词

    if len(word)==1:

        continue

    elif word=="小叔" or word=='温少远'or word=='温少':

        rword="小叔"

    else:

        rword=word

    counts[rword]=counts.get(rword,0)+1

for word in others:

    del(counts[word])

items=list(counts.items())

items.sort(key=lambda x:x[1],reverse=True)

for i in range(5):

    word,count=items[i]

    print("{0:<10}{1:>5}".format(word,count))
结果:
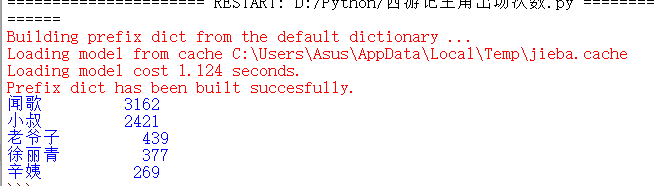
实在是太开心啦啦啦啦,虽然others那里耗费了很长时间,做出来还是很开心的。
二、解决问题(1)
我还是对第一篇小说百思不得其解,上网百度了后才知道,原来是我第一篇小说另存为是选择编码方式不是utf-8,只要改成utf-8就可以了
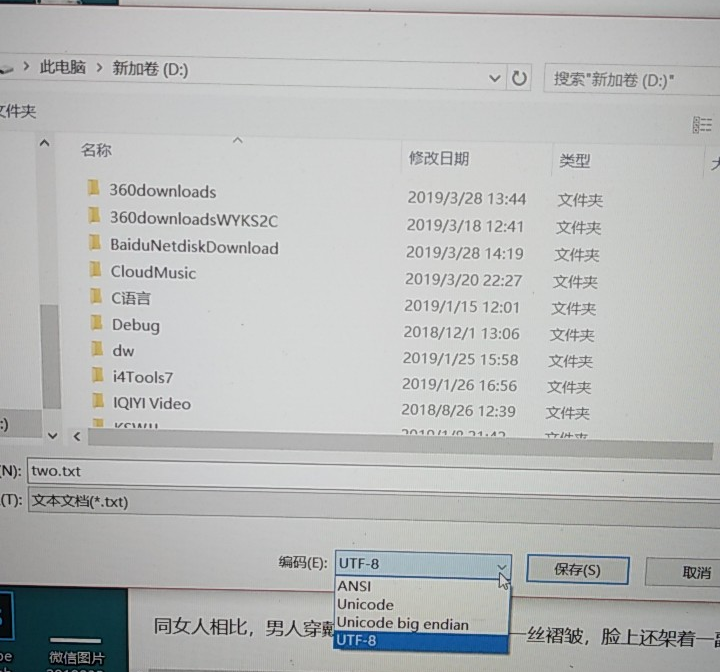
我改了一下代码,换成了第一部超长小说的统计,代码就不贴了,类似的,但不知道为什么厉爵风只出现了厉爵(有待考证???):
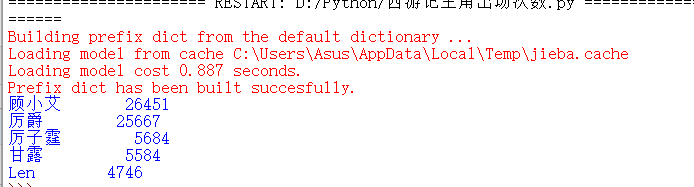
三、解决问题(2)
上百度搜一下,找到了一个解决方法:把命令改为txt=open(‘d:\\two.txt’,'r').read()就可以了
原因:在python中‘\’为转义字符,要想输出‘\’,要么多加一个"\",写成\\,要么在字符串前加r,txt=open(r'd:\\two.txt','r').read()
四、解决问题(3)
只要在程序里添加一个jieba.add_word()就可以自定义一个新的分词了,但该新的分词只对该程序有效,并不是永久添加
import jieba

jieba.add_word('厉爵风')

txt=open("d://two.txt","r",encoding='utf-8').read()

others={'有些','自己','已经','知道','时候','刚刚','一下','看着','没有','像是','一个','一眼','好像','什么','声音','这样','起来','这么','回来','就是','微微','一声','说道',

        '这个','这才','目光','看见','觉得','过来','不是','怎么','现在','突然','一会','还是','几分','一起','顿时','回去','眼神','安然','只是','原本','出去','似乎',

        '眼睛','下来','整个','手指','两个','因为','一直','电话','语气','问道','出来','心里','开始','门口','这里','那么','房间','那个','格外','灯光','时间','回答','一般','转身',

        '几乎','事情','坐在','说话','表情'}

words= jieba.lcut(txt)   #jieba将txt分成多个分词

counts={}    #建立一个空字典

for word in words:    #这里的word是指遍历从txt的第一个分词到最后一个分词

    if len(word)==1:

        continue

    elif word=="厉子霆" or word=='Len'or word=='LG':

        rword="LG"

    else:

        rword=word

    counts[rword]=counts.get(rword,0)+1

for word in others:

    del(counts[word])

items=list(counts.items())

items.sort(key=lambda x:x[1],reverse=True)

for i in range(5):

    word,count=items[i]

    print("{0:<10}{1:>5}".format(word,count))
结果如图:
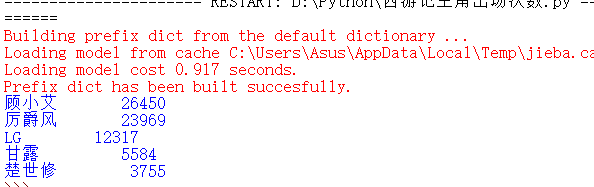
小结:问题都解决啦,超级开心的
python统计喜欢的小说主角出场次数的更多相关文章
- Python统计日志中每个IP出现次数
介绍了Python统计日志中每个IP出现次数的方法,实例分析了Python基于正则表达式解析日志文件的相关技巧,需要的朋友可以参考下 本脚本可用于多种日志类型 #-*- coding:utf-8 -* ...
- python 统计字符串中指定字符出现次数的方法
python 统计字符串中指定字符出现次数的方法: strs = "They look good and stick good!" count_set = ['look','goo ...
- python统计英文首字母出现的次数
使用python解析有道词典导出的xml格式单词,统计各个首字母出现的次数,并按次数由多到少进行排序 相关实现 导出的xml格式如下 <wordbook> <item> < ...
- python统计字符串里每个字符的次数
方法一: 推导式 dd="ewq4aewtaSDDSFDTFDSWQrtewtyufashas" print {i:dd.count(i) for i in dd} 方法二: co ...
- 使用python统计《三国演义》小说里人物出现次数前十名,并实现可视化。
一.安装所需要的第三方库 jieba (jieba是优秀的中文分词第三分库) pyecharts (一个优秀的数据可视化库) <三国演义>.txt下载地址(提取码:kist ) 使用pyc ...
- 如何用Python统计《论语》中每个字的出现次数?10行代码搞定--用计算机学国学
编者按: 上学时听过山师王志民先生一场讲座,说每个人不论干什么,都应该学习国学(原谅我学了计算机专业)!王先生讲得很是吸引我这个工科男,可能比我的后来的那些同学听课还要认真些,当然一方面是兴趣.一方面 ...
- python统计元素重复次数
python统计元素重复次数 # !/usr/bin/python3.4 # -*- coding: utf-8 -*- from collections import Counter arr = [ ...
- Python统计列表中的重复项出现的次数的方法
本文实例展示了Python统计列表中的重复项出现的次数的方法,是一个很实用的功能,适合Python初学者学习借鉴.具体方法如下:对一个列表,比如[1,2,2,2,2,3,3,3,4,4,4,4],现在 ...
- python统计文本中每个单词出现的次数
.python统计文本中每个单词出现的次数: #coding=utf-8 __author__ = 'zcg' import collections import os with open('abc. ...
随机推荐
- 白盒测试实践-任务进度-Day05
所使用静态代码检查工具 阿里巴巴Java开发代码检测IDE插件 小组成员 华同学.郭同学.覃同学.刘同学.穆同学.沈同学 任务进度 任务已经进入收官阶段,为了对大家各自任务完成情况进行确认,保证任务能 ...
- sql返回前N行
场景:返回每个客户最近的3个订单. 假设我们已经有一个POC索引(详情见http://www.cnblogs.com/xiaopotian/p/6821502.html),有两种策略来完成该任务:一种 ...
- java中Integer常量池
我们先看一个关于Integer的例子 public static void main(String[] args) { // TeODO Auto-generated method stu Integ ...
- 【小梅哥FPGA进阶教程】串口发送图片数据到SRAM在TFT屏上显示
十五.串口发送图片数据到SRAM在TFT屏上显示 之前分享过rom存储图片数据在TFT屏上显示,该方法只能显示小点的图片,如果想显示TFT屏幕大小的图片上述方法rom内存大小不够.小梅哥给了个方案,利 ...
- Freemark与spring整合
SpringMVC环境的搭建在这里就不多说了,我们这节主要是FreeMarker与SpringMVC整合 首先,在springmvc的配置文件普通视图之前,加入freemarker的视图 fre-se ...
- opencv——设置ROI区域
#include "stdafx.h" #include<opencv2\opencv.hpp> #include<opencv\cv.h> #includ ...
- c3p0-数据库连接池原理
一直用c3p0很久了,但也没时间或没主动去研究过,直到最近频频在出现一些莫名其妙的问题,觉得还是有必要了解和研究一下. c3p0是什么 c3p0的出现,是为了大大提高应用程序和数据库之间访问效率的. ...
- Replication--修改复制代理配置来查看代理运行情况
1>在复制监视器中选中订阅右键 2>选择代理配置文件 3>将代理配置文件设置为”详细历史记录代理配置文件“,确定以保存 4>重启代理 5>代理运行一段时间后,重启代理 6 ...
- Win7 家庭普通版开启超级管理员
将以下内容copy保存为admin.reg文件 Windows Registry Editor Version 5.00 [HKEY_LOCAL_MACHINE\SOFTWARE\Microsoft\ ...
- List<object>进行Distinct()去重
有时我们会对一个list<T>集合里的数据进行去重,C#提供了一个Distinct()方法直接可以点得出来.如果list<T>中的T是个自定义对象时直接对集合Distinct是 ...