Batched Key Access Join
Index Nested-Loop Join虽好,但是通过辅助索引进行链接后需要回表,这里需要大量的随机I/O操作。若能优化随机I/O,那么就能极大的提升Join的性能。为此,My
SQL 5.6推出了Batched Key Access Join,该
算法通过常见的空间换时间,随机I/O转顺序I/O,以此来极大的提升Join的性能。
MRR
在说明Batched Key Access Join前,首先介绍下MySQL 5.6的新特性mrr——multi range read。这个特性根据rowid顺序地,批量地读取记录,从而提升数据库的整体性能。看下面的SQL语句的执行计划:
mysql> explain select * from orders
-> where o_orderdate >= '1993-08-01'
-> and o_orderdate < date_add( '1993-08-01' ,interval '3' month)\G
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: orders
partitions: NULL
type: range
possible_keys: i_o_orderdate
key: i_o_orderdate
key_len: 4
ref: NULL
rows: 143210
filtered: 100.00
Extra: Using index condition
1 row in set, 1 warning (0.00 sec)
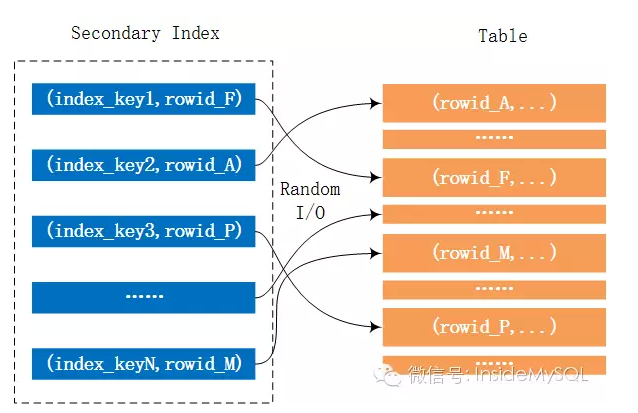
上述的SQL语句需要根据辅助索引i_o_orderdate进行查询,但是由于要求得到的是表中所有的列,因此需要回表进行读取。而这里就可能伴随着大量的随机I/O。这个过程如下图所示:
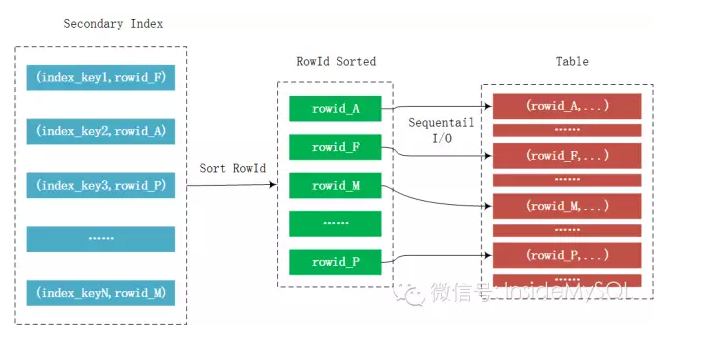
而mrr的优化在于,并不是每次通过辅助索引读取到数据就回表去取记录,而是将其rowid给缓存起来,然后对rowid进行排序后,再去访问记录,这样就能将随机I/O转化为顺序I/O,从而大幅地提升性能。这个过程如下所示:
从上图可以发现mrr通过一个额外的内存来对rowid进行排序,然后再顺序地,批量地访问表。这个进行rowid排序的内存大小由参数read_rnd_buffer_size控制,默认256K。
要开启mrr还有一个比较重的参数是在变量optimizer_switch中的mrr和mrr_cost_based选项。mrr选项默认为on,mrr_cost_based选项默认为off。mrr_cost_based选项表示通过基于成本的算法来确定是否需要开启mrr特性。然而,在MySQL当前版本中,基于成本的算法过于保守,导致大部分情况下优化器都不会选择mrr特性。为了确保优化器使用mrr特性,请执行下面的SQL语句:
mysql>set optimizer_switch='mrr=on,mrr_cost_based=off';
同样执行前面的SQL语句,可以发现这时优化的执行计划为:
mysql> explain select * from orders where
-> o_orderdate >= '1993-08-01'
-> and o_orderdate < date_add('1993-08-01' ,interval '3' month)\G
*************************** 1. row***************************
id: 1
select_type: SIMPLE
table: orders
partitions: NULL
type: range
possible_keys: i_o_orderdate
key: i_o_orderdate
key_len: 4
ref: NULL
rows: 143210
filtered: 100.00
Extra: Using index condition; Using MRR
1row in set, 1 warning (0.00 sec)
最后来对比一下关闭和开启mrr特性后上述SQL的执行时间:
在讲述完mrr特性后,再来看BKA Join就非常清晰明了了。通过mrr特性优化Join的回表操作,从而提升Join的性能。这时BKA Join的整个过程如下所示:
然而,这么好的特性,却是在MySQL中默认关闭的!!!这可能是导致用户认为MySQL Join性能比较差的一个原因。若要使用BKA Join,务必执行下列的SQL语句:
mysql> SET optimizer_switch='mrr=on,mrr_cost_based=off,batched_key_access=on';
Query OK, 0 rows affected (0.00 sec)
若开启了BKA Join,则通过EXPLAIN命令,可以发现优化器的执行结果选项会有Using join buffer (Batched Key Access)的提示,如:
mysql> explain SELECT
-> COUNT(*)
-> FROM
-> part,
-> lineitem
-> WHERE
-> l_partkey, = p_partkey
-> AND p_retailprice > 2050 AND p_size < 100
-> AND l_discount > 0.04\G
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: part
partitions: NULL
type: ALL
possible_keys: PRIMARY
key: NULL
key_len: NULL
ref: NULL
rows: 196810
filtered: 11.11
Extra: Using where
*************************** 2. row ***************************
id: 1
select_type: SIMPLE
table: lineitem
partitions: NULL
type: ref
possible_keys: i_l_suppkey_partkey,i_l_partkey
key: i_l_suppkey_partkey
key_len: 5
ref: dbt3_s1.part.p_partkey
rows: 28
filtered: 33.33
Extra: Using where; Using join buffer (Batched Key Access)
2 rows in set, 1 warning (0.00 sec)
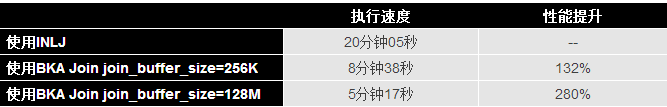
最后来看下执行速度,可以发现BKA的提升非常明显:
未完待续
- MySQL Join算法与调优白皮书(一)
正文 Inside君发现很少有人能够完成讲明白MySQL的Join类型与算法,网上流传着的要提升Join性能,加大变量join_buffer_size的谬论更是随处可见.当然,也有一些无知的PGer攻 ...
- MySQL Join算法与调优白皮书(二)
Index Nested-Loop Join (接上篇)由于访问的是辅助索引,如果查询需要访问聚集索引上的列,那么必要需要进行回表取数据,看似每条记录只是多了一次回表操作,但这才是INLJ算法最大 ...
- mysql监控、性能调优及三范式理解
原文:mysql监控.性能调优及三范式理解 1监控 工具:sp on mysql sp系列可监控各种数据库 2调优 2.1 DB层操作与调优 2.1.1.开启慢查询 在My.cnf文件中添加如 ...
- 【叶问】 MySQL常用的sql调优手段或工具有哪些
MySQL常用的sql调优手段或工具有哪些1.根据执行计划优化 通常使用desc或explain,另外可以添加format=json来输出更详细的json格式的执行计划,主要注意点如下: ...
- MySQL性能诊断与调优 转
http://www.cnblogs.com/preftest/ http://www.highperfmysql.com/ BOOK LAMP 系统性能调优,第 3 部分: MySQL 服务 ...
- MySQL插入数据性能调优
插入数据性能调优总结: 1.SQL插入语句调优 2.如果是InnoDB引擎的话,尝试开启事务,批量提交 3.调整MySQl数据库配置 参考: 百度空间 - MySQL插入数据性能调优 CSDN ...
- MySQL性能诊断与调优
LAMP 系统性能调优,第 3 部分: MySQL 服务器调优http://www.ibm.com/developerworks/cn/linux/l-tune-lamp-3.html LoadRun ...
- JVM调优(三)——基于Btrace的监控调试
JVM调优(三)--基于Btrace的监控调试 简介 Btrace可以动态地向目标应用程序的字节码注入追踪代码 用到的技术: JavaComplierApi.JVMTI.Agent.Instrumen ...
- MySQL索引和SQL调优手册
MySQL索引 MySQL支持诸多存储引擎,而各种存储引擎对索引的支持也各不相同,因此MySQL数据库支持多种索引类型,如BTree索引,哈希索引,全文索引等等.为了避免混乱,本文将只关注于BTree ...
随机推荐
- zoj1654
题解: 对于每一联通的x,y 检点 然后交叉的连边 然后二分图 代码: #include<cstdio> #include<cstring> #include<cmath ...
- String.Remove
String.Remove方法注意事项: 1.该方法不改变元字符串: 2.str = ‘’: str.Remove(str.Length-3);明显超限,但是不报错,返回值为''; str = '1 ...
- ElasticSearch6.0 索引模板
我们在做es搜索的场合,每次创建索引的时候,都需要为每个索引设置mapping的字段映射,现在我们可以为通用的索引创建一个模板 每次创建索引时候,如果匹配到相应的模板 索引的mapping会被自动设置 ...
- 各排序算法的Java实现及简单分析
一,直接插入排序 //直接插入排序的算法时间复杂度分析: //如果输入为正序,则每次比较一次就可以找到元素最终位置,复杂度为O(n) //如果输入为反序,则每次要比较i个元素,复杂度为O(n2) // ...
- APUE学习笔记——5缓冲Buffering、流、文件对象
缓冲的几个基本概念 缓冲的作用:减少系统read和write的次数. 全缓冲 系统标准I/O缓冲区被写满时才进行真正的I/O操作. 磁盘文件一般使用全缓冲 ...
- css 中相对定位和绝对定位
1. css中定位机制有三种: 标准文档流, 浮动, 绝对定位 2. 绝对定位就属于第三种定位, 用到position属性, 下面就是具体设置 相对定位: 相对于自身原有位置(就是普通流的时候)进行偏 ...
- 实现DQN算法玩CartPole
先安装tensorflow 1.2版本和python 3.6, 接着安装: numpy-1.13.1+mkl-cp36-cp36m-win_amd64.whl 的版本,这个是windows下的,如果l ...
- softmax的多分类
关于多分类 我们常见的逻辑回归.SVM等常用于解决二分类问题,对于多分类问题,比如识别手写数字,它就需要10个分类,同样也可以用逻辑回归或SVM,只是需要多个二分类来组成多分类,但这里讨论另外一种方式 ...
- Vim技能修炼教程(8) - 多窗口
多窗口 如果一个vim只能开一个窗口,那肯定是有点low.尤其是写代码的时候,打开多个文件是经常的需求. 速成教程 横着切成两个 :split 文件名 上下切换窗口 Ctrl-W加上上下键,可以实现上 ...
- ss-libev 源码解析local篇(4): server_recv_cb之STAGE_STREAM
继续探索server_recv_cb,我们已经来到了STAGE_STREAM状态.如果在0.05秒的timer来之前客户端就有数据过来,server_recv_cb被调用,此时已经在stream状态就 ...