
通过BlukLoad的方式快速导入海量数据
http://www.cnblogs.com/MOBIN/p/5559575.html
摘要
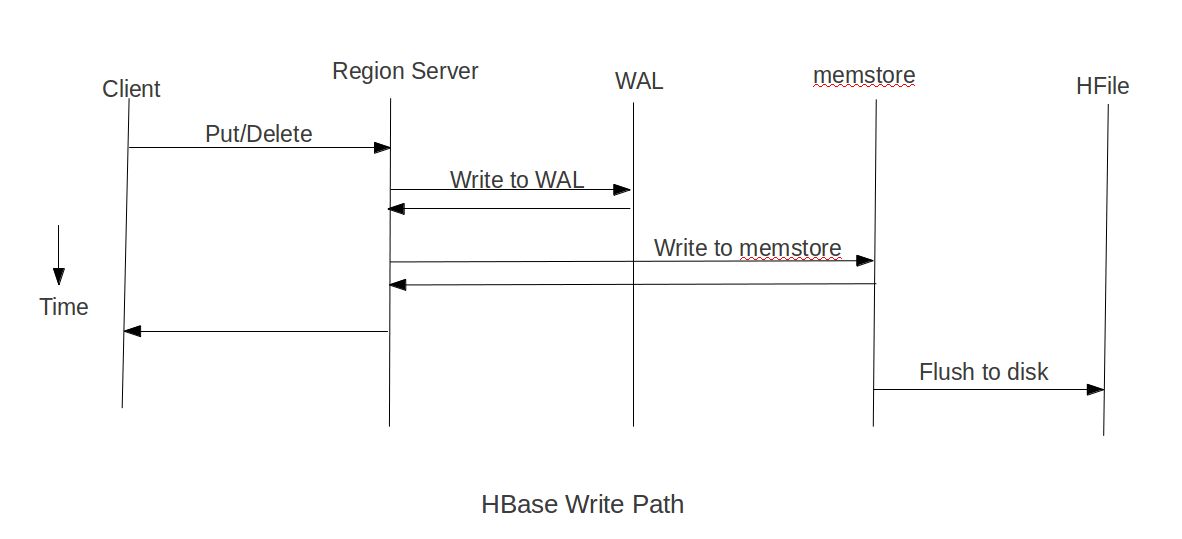

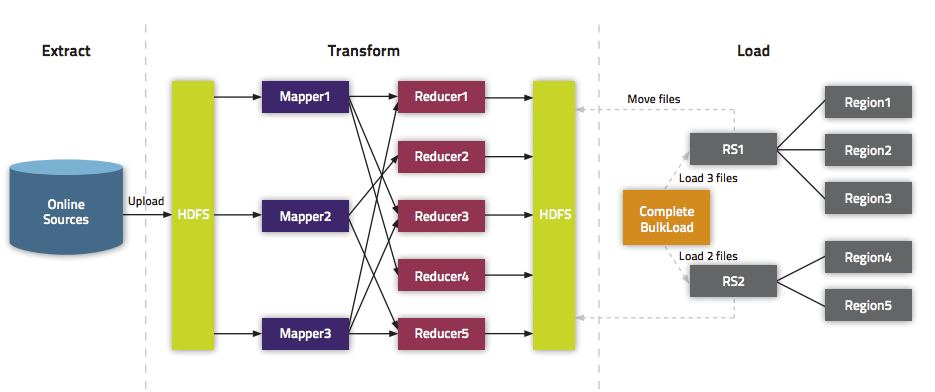

|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
|
public class GenerateHFile extends Mapper<LongWritable, Text, ImmutableBytesWritable, Put>{ protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { String line = value.toString(); String[] items = line.split("\t"); String ROWKEY = items[1] + items[2] + items[3]; ImmutableBytesWritable rowkey = new ImmutableBytesWritable(ROWKEY.getBytes()); Put put = new Put(ROWKEY.getBytes()); //ROWKEY put.addColumn("INFO".getBytes(), "URL".getBytes(), items[0].getBytes()); put.addColumn("INFO".getBytes(), "SP".getBytes(), items[1].getBytes()); //出发点 put.addColumn("INFO".getBytes(), "EP".getBytes(), items[2].getBytes()); //目的地 put.addColumn("INFO".getBytes(), "ST".getBytes(), items[3].getBytes()); //出发时间 put.addColumn("INFO".getBytes(), "PRICE".getBytes(), Bytes.toBytes(Integer.valueOf(items[4]))); //价格 put.addColumn("INFO".getBytes(), "TRAFFIC".getBytes(), items[5].getBytes());//交通方式 put.addColumn("INFO".getBytes(), "HOTEL".getBytes(), items[6].getBytes()); //酒店 context.write(rowkey, put); }} |
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
|
public class GenerateHFileMain { public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException { final String INPUT_PATH= "hdfs://master:9000/INFO/Input"; final String OUTPUT_PATH= "hdfs://master:9000/HFILE/Output"; Configuration conf = HBaseConfiguration.create(); HTable table = new HTable(conf,"TRAVEL"); Job job=Job.getInstance(conf); job.getConfiguration().set("mapred.jar", "/home/hadoop/TravelProject/out/artifacts/Travel/Travel.jar"); //预先将程序打包再将jar分发到集群上 job.setJarByClass(GenerateHFileMain.class); job.setMapperClass(GenerateHFile.class); job.setMapOutputKeyClass(ImmutableBytesWritable.class); job.setMapOutputValueClass(Put.class); job.setOutputFormatClass(HFileOutputFormat2.class); HFileOutputFormat2.configureIncrementalLoad(job,table,table.getRegionLocator()); FileInputFormat.addInputPath(job,new Path(INPUT_PATH)); FileOutputFormat.setOutputPath(job,new Path(OUTPUT_PATH)); System.exit(job.waitForCompletion(true)?0:1); }} |
|
1
2
3
4
5
6
7
8
|
public class LoadIncrementalHFileToHBase { public static void main(String[] args) throws Exception { Configuration conf = HBaseConfiguration.create(); Connection connection = ConnectionFactory.createConnection(configuration); LoadIncrementalHFiles loder = new LoadIncrementalHFiles(configuration); loder.doBulkLoad(new Path("hdfs://master:9000/HFILE/OutPut"),new HTable(conf,"TRAVEL")); }} |
通过BlukLoad的方式快速导入海量数据的更多相关文章
- 通过BulkLoad的方式快速导入海量数据
摘要 加载数据到HBase的方式有多种,通过HBase API导入或命令行导入或使用第三方(如sqoop)来导入或使用MR来批量导入(耗费磁盘I/O,容易在导入的过程使节点宕机),但是这些方式不是慢就 ...
- 通过BulkLoad快速将海量数据导入到Hbase
在第一次建立Hbase表的时候,我们可能需要往里面一次性导入大量的初始化数据.我们很自然地想到将数据一条条插入到Hbase中,或者通过MR方式等. 但是这些方式不是慢就是在导入的过程的占用Region ...
- 在Spark上通过BulkLoad快速将海量数据导入到Hbase
我们在<通过BulkLoad快速将海量数据导入到Hbase[Hadoop篇]>文中介绍了一种快速将海量数据导入Hbase的一种方法,而本文将介绍如何在Spark上使用Scala编写快速导入 ...
- mysql快速导入5000万条数据过程记录(LOAD DATA INFILE方式)
mysql快速导入5000万条数据过程记录(LOAD DATA INFILE方式) 首先将要导入的数据文件top5000W.txt放入到数据库数据目录/var/local/mysql/data/${d ...
- MySQL 快速导入大量数据 资料收集
一.LOAD DATA INFILE http://dev.mysql.com/doc/refman/5.5/en/load-data.html 二. 当数据量较大时,如上百万甚至上千万记录时,向My ...
- 在Ubuntu上使用离线方式快速安装K8S v1.11.1
在Ubuntu上使用离线方式快速安装K8S v1.11.1 0.安装包文件下载 https://pan.baidu.com/s/1nmC94Uh-lIl0slLFeA1-qw v1.11.1 文件大小 ...
- 8、组件注册-@Import-给容器中快速导入一个组件
8.组件注册-@Import-给容器中快速导入一个组件 8.1 给容器中注册组建的方式 包扫描+组建标注注解(@Controller.@Service.@Repository.@Component)[ ...
- Mysql百万数据量级数据快速导入Redis
前言 随着系统的运行,数据量变得越来越大,单纯的将数据存储在mysql中,已然不能满足查询要求了,此时我们引入Redis作为查询的缓存层,将业务中的热数据保存到Redis,扩展传统关系型数据库的服务能 ...
- 【Spring注解驱动开发】使用@Import注解给容器中快速导入一个组件
写在前面 我们可以将一些bean组件交由Spring管理,并且Spring支持单实例bean和多实例bean.我们自己写的类,可以通过包扫描+标注注解(@Controller.@Servcie.@Re ...
随机推荐
- layui表格监听开关并获取改行id
,{field:'sex', title:'性别', width:85, templet: '#switchTpl', unresize: true} <script type="te ...
- 13_springmvc拦截器应用
一.实现登录认证 1.需求: 用户请求url,拦截器进行拦截校验 如果请求的url是公开地址(无需登陆即可访问的url),让放行 如果用户session 不存在跳转到登陆页面 如果用户session存 ...
- <数据可视化>Matplotlib(2D+3D)
1.Matplotlib介绍(2D) Matplotlib 是 Python 2D-绘图领域使用最广泛的套件.它能让使用者很轻松地将数据图形化,并且提供多样化的输出格式. pylab 是 matplo ...
- 面试系列26 如何基于dubbo进行服务治理、服务降级、失败重试以及超时重试
(1)服务治理 1)调用链路自动生成 一个大型的分布式系统,或者说是用现在流行的微服务架构来说吧,分布式系统由大量的服务组成.那么这些服务之间互相是如何调用的?调用链路是啥?说实话,几乎到后面没人搞的 ...
- netty http 服务器
HttpFileServer package com.zhaowb.netty.ch10_1; import io.netty.bootstrap.ServerBootstrap; import io ...
- windows 内核下获取进程路径
windows 内核下获取进程路径 思路:1):在EPROCESS结构中获取.此时要用到一个导出函数:PsGetProcessImageFileName,申明如下: NTSYSAPI UCHAR * ...
- CentOS7配置Docker镜像加速器
1. 将默认的配置文件复制出来 cp -n /lib/systemd/system/docker.service /etc/systemd/system/docker.service 2. 将加速器地 ...
- AMPQ
AMPQ AMQP,即Advanced Message Queuing Protocol,高级消息队列协议, 是`应用层协议的一个开放标准,为面向消息的中间件设计`. 由于AMQP是一个网络协议,所以 ...
- Config程序配置文件(configSections)操作实践及代码详注
所有与配置文件相关的类:(粗体为一般情况下使用到的类,其它类功能可能在很复杂的情况下才使用到.) 1.ConfigurationManager,这个提供用于打开客户端应用程序集的Configurati ...
- pandas的使用方法
一.基本使用方法 # pandas引入约定 import pandas as pd from pandas import Series,DataFrame import numpy as np imp ...