
Google earth爬取卫星影像数据并进行标注路网的方法
一、下载goole earth 和GetScreen:
试了很多,找了可以使用的上传到百度网盘,链接如下所示:
链接:https://pan.baidu.com/s/1fp-W8u68iRsJ0xcu-pJWhg
提取码:zrsw
使用方法:
1、首先打开Google earth,并将球锁定到要截取影像的位置
2、打开GetScreen插件,定位到要截取的区域,选择“两点定位”;
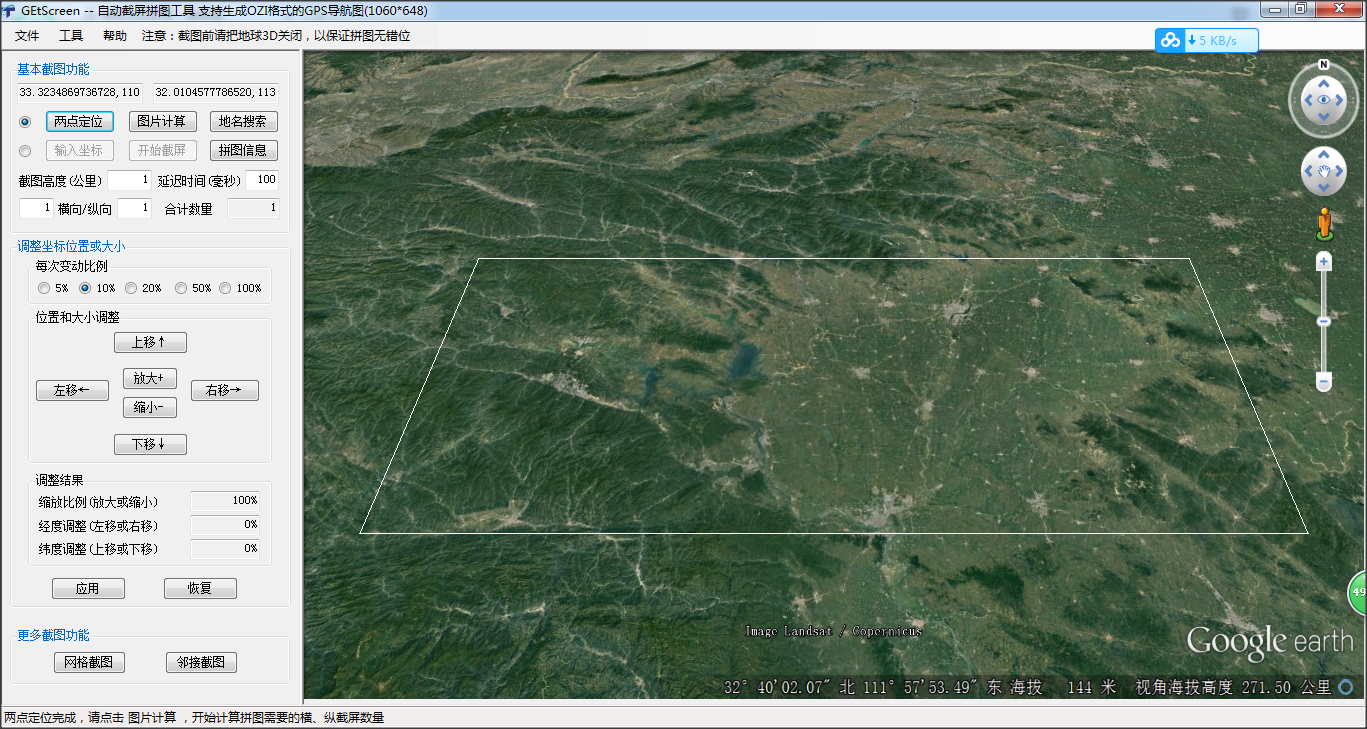
3、在右侧的影像中右键单击,输入两点(两点连成的直线是框选区域的对角线)
4、点击“图片计算”,待计算完成后,进行下一步操作;
5、点击“开始截图”,会截取选中的区域,在截图过程中,保持GetScreen不变,也不要进行其他任何操作。
6、点击“拼图信息”,可查看截取的影像图片
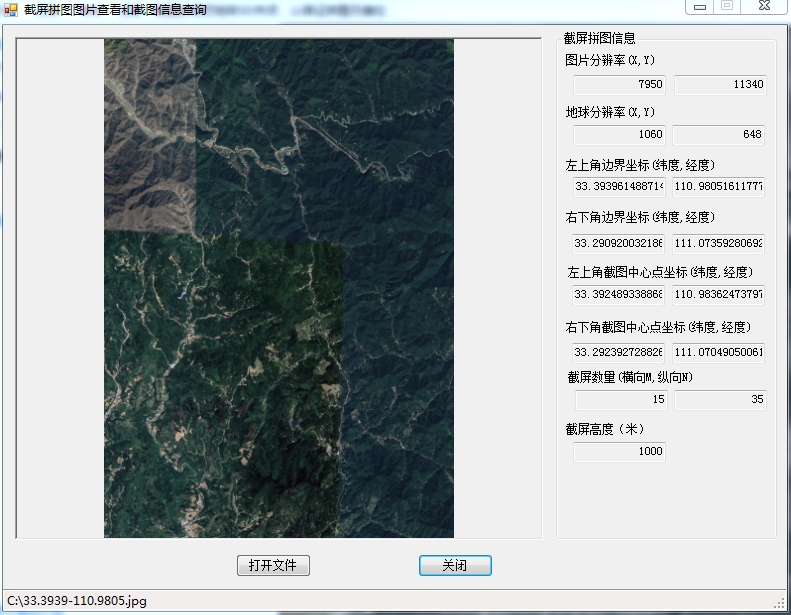
7、根据上图中的拼图信息,可以给截取的图片添加位置信息:
参考:https://blog.csdn.net/llw01/article/details/8918514
假设:左上角坐标(minX,maxY),右上角坐标(maxX,maxY),右下角坐标(maxX,minY),左下角坐标(minX,minY)
步骤:
(1)在放图片的目录下新建TXT文本文档,将文件名改为与图片相同,扩展名改为jgw(JPG图片),(TIF要改为tfw)。
(2)用记事本打开扩展名为*.jgw或*.tfw的文件,在其中输入下列五行数字:
A=X方向上的象素分辨率
D=旋转系统
B=旋转系统
E=Y方向上的象素分辨素
C=栅格地图左上角象素中心X坐标
F=栅格地图左上角象素中心Y坐标
其中:A=(maxX – minX)/numX;D、B一般默认为0;E=(minY – maxY)/numY;C=minX;F=maxY;注意X指经度,y指纬度
(3)最终jgw或tfw文件如下:
-0.0000082078209126102292
0
0
0.0000129611895
110.9805161177790
33.3939614887145
用ArcGIS加载图片,该图片就具有了地理坐标。
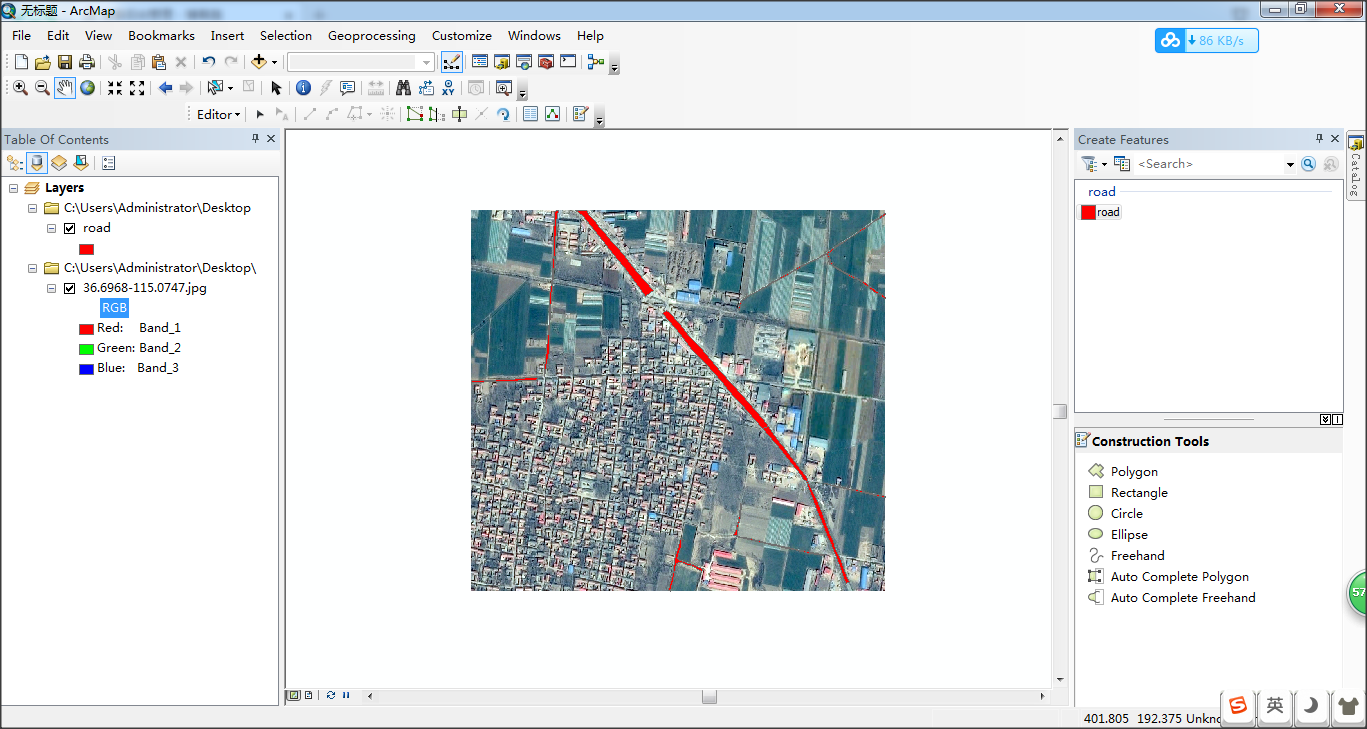
二、在arcmap中绘制路网,制作路网提取的样本
参考:https://blog.csdn.net/DoctorCuiLab/article/details/83060095
Google earth爬取卫星影像数据并进行标注路网的方法的更多相关文章
- xpath爬取网页评论,网址的的调用方法,数据库特殊字符的替换
# -*- coding:utf-8-*-from lxml import etreeimport urllibimport jsonimport requestsimport MySQLdbid=0 ...
- Google Earth数据存储、管理、表现及开发机制
Google Earth数据存储.管理.表现及开发机制 一. Google Earth(Map)介绍 1.1 Google Earth介绍 在众多的地理信息服务提供商中,Google是较早 ...
- [python爬虫] Selenium定向爬取海量精美图片及搜索引擎杂谈
我自认为这是自己写过博客中一篇比较优秀的文章,同时也是在深夜凌晨2点满怀着激情和愉悦之心完成的.首先通过这篇文章,你能学到以下几点: 1.可以了解Python简单爬取图片的一些思路和方法 ...
- Scrapy Learning笔记(四)- Scrapy双向爬取
摘要:介绍了使用Scrapy进行双向爬取(对付分类信息网站)的方法. 所谓的双向爬取是指以下这种情况,我要对某个生活分类信息的网站进行数据爬取,譬如要爬取租房信息栏目,我在该栏目的索引页看到如下页面, ...
- 用WebCollector制作一个爬取《知乎》并进行问题精准抽取的爬虫(JAVA)
简单介绍: WebCollector是一个无须配置.便于二次开发的JAVA爬虫框架(内核),它提供精简的的API.仅仅需少量代码就可以实现一个功能强大的爬虫. 怎样将WebCollector导入项目请 ...
- python网络爬虫之使用scrapy自动爬取多个网页
前面介绍的scrapy爬虫只能爬取单个网页.如果我们想爬取多个网页.比如网上的小说该如何如何操作呢.比如下面的这样的结构.是小说的第一篇.可以点击返回目录还是下一页 对应的网页代码: 我们再看进入后面 ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
- Crawlspider的自动爬取
引子 : 如果想要爬取 糗事百科 的全栈数据的方法 ? 方法一 : 基于scrapy框架中的scrapy的递归爬取进行实现(requests模块递归回调parse方法) . 方法二 : 基于Crawl ...
- scrapy(2)——scrapy爬取新浪微博(单机版)
Sina爬虫教程 Scrapy环境搭建 环境:window10 + python2.7(包含scrapy)+ mongoDB 1.1 安装集成了python2.7的anaconda ana ...
随机推荐
- mysql emoji存储问题
偶然存储一条用户记录的时候,发现mysql一直报错 mysql_real_query failed:Incorrect stringvalue: '\xF0\x9F\x98\x8E T...' for ...
- python3.6.4安装错误0x80072efd
是因为翻不了墙,请求URL错误,所以报错那么去掉Download debug sysbom选项
- Quick BI 的模型设计与生成SQL原理剖析
一.摘要 随着物联网的告诉发展,数据量呈现井喷式的增长,如何来分析和使用这些数据,使数据产生商业价值,已经变得越来越重要.值得高兴的是,当前越来越多的人已经意识到了用数据分析决定商业策略的重要性,也都 ...
- ROS 日志消息(C++)
1.日志级别 日志消息分为五个不同的严重级别宏,与Android的Log定义的严重级别类似,如下基础宏: ROS_DEBUG_STREAM.ROS_INFO_STREAM.ROS_WARN_STREA ...
- dubbo入门学习(六)-----dubbo原理
RPC原理 一次完整的RPC调用流程(同步调用,异步另说)如下: 1)服务消费方(client)调用以本地调用方式调用服务: 2)client stub接收到调用后负责将方法.参数等组装成能够进行网络 ...
- windows2008解决必须使用角色管理工具安装或配置 NET3.5 sp1问题
win2008系统安装网站环境系统的时候常常提示:必须使用角色管理工具 安装或配置microsoft.net framework 3.5 sp1 ,导致安装不成功. 原因在于windows2008系统 ...
- Django-rest Framework(五)
把十大接口做完了才能更好的了解后面的视图类 1.(重点)二次封装Response;自定义APIResponse继承Response,重写 ____init____方法 from rest_framew ...
- 二、深入asyncio协程(任务对象,协程调用原理,协程并发)
由于才开始写博客,之前都是写笔记自己看,所以可能会存在表述不清,过于啰嗦等各种各样的问题,有什么疑问或者批评欢迎在评论区留言. 如果你初次接触协程,请先阅读上一篇文章初识asyncio协程对asy ...
- Simple implementation and results of genetic algorithm.
This experiment was done for the final assignment of my Professional English class. This part has be ...
- 第02章 Python快速入门
007.快速入门,边学边用 008.变量类型 print(type(变量)) 查看变量的了类型 现在常用的变量的类型有整型.浮点型.字符型 009.List基础模块 类型转换:str(8 ...