
通过脚本同时运行几个spider
# 通过脚本同时运行几个spider
目录结构:
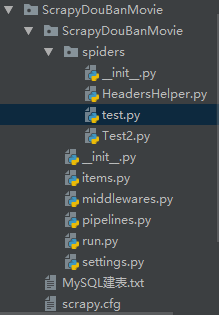
1.在命令行能通过的情况下创建两个spider如
TestSpider
Test2Spider
2.在items.py的同级目录创建run.py文件,有三种方式,任选其一,其代码如下:
方式一: 通过CrawlerProcess同时运行几个spider
run_by_CrawlerProcess.py源代码:
 # 通过CrawlerProcess同时运行几个spider

 from scrapy.crawler import CrawlerProcess

 # 导入获取项目配置的模块

 from scrapy.utils.project import get_project_settings

 # 导入蜘蛛模块(即自己创建的spider)

 from spiders.test import TestSpider

 from spiders.test2 import Test2Spider

 # get_project_settings() 必须得有,不然"HTTP status code is not handled or not allowed"

 process = CrawlerProcess(get_project_settings())

 process.crawl(TestSpider) # 注意引入

 #process.crawl(Test2Spider) # 注意引入

 process.start()
方式二:通过CrawlerRunner同时运行几个spider
run_by_CrawlerRunner.py源代码:
 # 通过CrawlerRunner同时运行几个spider

 from twisted.internet import reactor

 from scrapy.crawler import CrawlerRunner

 from scrapy.utils.log import configure_logging

 # 导入获取项目配置的模块

 from scrapy.utils.project import get_project_settings

 # 导入蜘蛛模块(即自己创建的spider)

 from spiders.test import TestSpider

 from spiders.test2 import Test2Spider

 configure_logging()

 # get_project_settings() 必须得有,不然"HTTP status code is not handled or not allowed"

 runner = CrawlerRunner(get_project_settings())

 runner.crawl(TestSpider)

 #runner.crawl(Test2Spider)

 d = runner.join()

 d.addBoth(lambda _: reactor.stop())

 reactor.run() # the script will block here until all crawling jobs are finished
方式三:通过CrawlerRunner和链接(chaining) deferred来线性运行来同时运行几个spider
run_by_CrawlerRunner_and_Deferred.py源代码:
 # 通过CrawlerRunner和链接(chaining) deferred来线性运行来同时运行几个spider

 from twisted.internet import reactor, defer

 from scrapy.crawler import CrawlerRunner

 from scrapy.utils.log import configure_logging

 # 导入获取项目配置的模块

 from scrapy.utils.project import get_project_settings

 # 导入蜘蛛模块(即自己创建的spider)

 from spiders.test import TestSpider

 from spiders.test2 import Test2Spider

 configure_logging()

 # get_project_settings() 必须得有,不然"HTTP status code is not handled or not allowed"

 runner = CrawlerRunner(get_project_settings())

 @defer.inlineCallbacks

 def crawl():

     yield runner.crawl(TestSpider)

     #yield runner.crawl(Test2Spider)

     reactor.stop()

 crawl()

 reactor.run() # the script will block here until the last crawl call is finished
3.修改两个spider文件引入items,和外部类的如(HeadersHelper.py)的引入模式(以run.py所在目录为中心)
原导入模式:
from ..items import ScrapydoubanmovieItem

from .HeadersHelper import HeadersHelper
注释:这种导入能够在命令行scrapy crawl Test正常运行
修改为:
from items import ScrapydoubanmovieItem

from .HeadersHelper import HeadersHelper
注释:修改后这种导入在命令行scrapy crawl Test会报错,但通过运行run.py文件,能够同时运行两个spider
4.按照运行python文件的方式运行run.py,可以得到结果
通过脚本同时运行几个spider的更多相关文章
- Chrome扩展开发之二——Chrome扩展中脚本的运行机制和通信方式
目录: 0.Chrome扩展开发(Gmail附件管理助手)系列之〇——概述 1.Chrome扩展开发之一——Chrome扩展的文件结构 2.Chrome扩展开发之二——Chrome扩展中脚本的运行机制 ...
- Linux服务器Jboss运行环境搭建步骤和开机自动启动脚本编写运行
Jboss运行环境:Linux+Jdk+Jboss+jsp系统 Jboss软件说明:类似于Tomcat,就是一个跑Jsp系统的环境,他的站点路径跟Tomcat类似,Tomcat存放站点文件到webap ...
- windows下perl的安装和脚本的运行
参考 1.windows下perl的安装和脚本的运行: 2.fddb测试fddb的评估方法: 3.gunplot5.2.4-download: 完
- 【Linux学习】python脚本直接运行与nohup运行结果不同
之前遇到问题,在云主机上运行python脚本直接运行与nohup运行结果不同,甚至nohup根本运行不出来. 后来参考下别人的博客,终于知道问题了. nohup 使用的python版本问题. 而且no ...
- IDEA中编写脚本并运行shell脚本
IDEA中编写脚本并运行shell脚本 来自 <https://blog.csdn.net/u012443641/article/details/81295999>
- LoadRunner11脚本关联+运行负载+分析结果
一.脚本创建关联和插入检查点 脚本录制完成后,首先需运行脚本回放,验证是否可回放成功,然后找出各事务请求中的关联点! 如本例子中,录制的场景为:打开综合窗口收件-->查询事项-->窗口登记 ...
- python脚本后台运行
问题描述: 环境: CentOS6.4 一个用python写的监控脚本test1.py,用while True方式一直运行,在ssh远程(使用putty终端)时通过以下命令启动脚本: python t ...
- 由于Windows和Linux行尾标识引起脚本无法运行的解决
在所有的操作系统中,文本文件的结束或者换行都是有行尾符来标识的,C语言中经常使用\n作为换行,\r作为跳格TAB:实际上在计算机还没有真正出现之前,有种电传打字机的设备,每秒钟可以打印10个字符,但是 ...
- linux脚本后台运行
一般情况下,linux运行脚本是随着终端的关闭而关闭的,那么怎么让脚本能够在后台运行并且不随终端关闭而关闭呢? 这时用到的是nohup命令 格式: nohup 脚本路径 & 例: nohup ...
随机推荐
- Laravel建站03--建立前台文章列表和文章详情
经过了前面的开发环境搭建和数据库配置.git配置的准备工作以后,现在可以开始动作做点什么了. 先从简单的开始,那就先来个文章列表和详情页吧. 这期间可以学习到路由.建立model.controller ...
- [svc]caffe安装笔记-显卡购买
caffe,这是是数据组需要做一些大数据模型的训练(深度学习), 要求 服务器+显卡(运算卡), 刚开始老板让买的牌子是泰坦的(这是2年前的事情了). 后来买不到这个牌子的,(jd,tb)看过丽台的, ...
- PHP获得数组的交集与差集
PHP获得数组的交集与差集 作者:简明现代魔法图书馆 发布时间:-- :: 次阅读 服务器君一共花费了218. ms进行了6次数据库查询,努力地为您提供了提供了这个页面. 数组的交集 array_in ...
- java大数模板
java 大数计算 这几天做了几道用大数的题,发现java来做大数运算十分方便.对acmer来说是十分实用的 1.valueOf(parament); 将参数转换为制定的类型 比如 int a=3 ...
- ES6快速入门使用
https://www.jianshu.com/p/061304806bda Babel-webpack的配置 Bebal官方文档 前段项目我想使用ES6的语法我应该怎么做呢?我们可以查看Babel的 ...
- 我的第十个java程序--(其实是修改别人的web代码{springmvc+mybatis},知道了原理后其实一切都变的很简单)
先是效果图,提高学习的兴趣 springmvc+mybatis+easyui 这几个东西让我一点一点的啃,刚开始的时候真的跑不起几个程序 1.下载tomcat 2.导入程序 3.项目报错,但不指出具体 ...
- 第二百一十节,jQuery EasyUI,SearchBox(搜索框)组件
jQuery EasyUI,SearchBox(搜索框)组件 学习要点: 1.加载方式 2.属性列表 3.方法列表 本节课重点了解 EasyUI 中 SearchBox(搜索框)组件的使用方法,这个组 ...
- 【BZOJ】3433: [Usaco2014 Jan]Recording the Moolympics (贪心)
http://www.lydsy.com/JudgeOnline/problem.php?id=3433 想了好久啊....... 想不出dp啊......sad 后来看到一英文题解......... ...
- js 判断数组
这么基础的东西实在不应该再记录了,不过嘛,温故知新~就先从数据类型开始吧 js六大数据类型:number.string.object.Boolean.null.undefined string: 由单 ...
- python3----练习题(过滑块验证)
# 导入模块 from selenium import webdriver from selenium.webdriver import ActionChains from selenium.webd ...