
sparkML原始数据转换成label-features方法
数据1:kaggle-旧金山犯罪分类数据

格式如下:

Dates,Category,Descript,DayOfWeek,PdDistrict,Resolution,Address,X,Y

-- ::,WARRANTS,WARRANT ARREST,Wednesday,NORTHERN,"ARREST, BOOKED",OAK ST / LAGUNA ST,-122.425891675136,37.7745985956747

-- ::,OTHER OFFENSES,TRAFFIC VIOLATION ARREST,Wednesday,NORTHERN,"ARREST, BOOKED",OAK ST / LAGUNA ST,-122.425891675136,37.7745985956747

-- ::,OTHER OFFENSES,TRAFFIC VIOLATION ARREST,Wednesday,NORTHERN,"ARREST, BOOKED",VANNESS AV / GREENWICH ST,-122.42436302145,37.8004143219856

-- ::,LARCENY/THEFT,GRAND THEFT FROM LOCKED AUTO,Wednesday,NORTHERN,NONE, Block of LOMBARD ST,-122.42699532676599,37.80087263276921

-- ::,LARCENY/THEFT,GRAND THEFT FROM LOCKED AUTO,Wednesday,PARK,NONE, Block of BRODERICK ST,-122.438737622757,37.771541172057795

-- ::,LARCENY/THEFT,GRAND THEFT FROM UNLOCKED AUTO,Wednesday,INGLESIDE,NONE, Block of TEDDY AV,-122.40325236121201,37.713430704116

-- ::,VEHICLE THEFT,STOLEN AUTOMOBILE,Wednesday,INGLESIDE,NONE,AVALON AV / PERU AV,-122.423326976668,37.7251380403778

-- ::,VEHICLE THEFT,STOLEN AUTOMOBILE,Wednesday,BAYVIEW,NONE,KIRKWOOD AV / DONAHUE ST,-122.371274317441,37.7275640719518

-- ::,LARCENY/THEFT,GRAND THEFT FROM LOCKED AUTO,Wednesday,RICHMOND,NONE, Block of 47TH AV,-122.508194031117,37.776601260681204

测试代码:

    public static void main(String[] args) {

        SparkSession spark = SparkSession.builder().enableHiveSupport()

                .getOrCreate();

        Dataset<Row> dataset = spark

                .read()

                .format("org.apache.spark.sql.execution.datasources.csv.CSVFileFormat")

                .option("header", true)

                .option("inferSchema", true)

                .option("delimiter", ",")

                .load("file:///E:/git/bigdata_sparkIDE/spark-ide/workspace/test/SparkMLTest/SanFranciscoCrime/document/kaggle-旧金山犯罪分类/train-new.csv")

                .persist();

        DataPreProcess(dataset);

    }

   //此函数包含StringIndexer,OneHotEncoder,VectorAssembler,VectorIndexer数据转换方法

    public static Dataset<Row> DataPreProcess(Dataset<Row> data) {

        //Dataset<Row> df = data.selectExpr("cast(Dates as String) ,DayOfWeek,PdDistrict,Category".split(","));

        Dataset<Row> df = data.select(data.col("Dates").cast("String").alias("Dates"),data.col("DayOfWeek").alias("DayOfWeek"),data.col("PdDistrict"),data.col("Category"));

        df.printSchema();

        // 重新索引标签值

        SparkLog.info(data.select("Category").distinct().count());

        //将非数字类型标签转换成数字类型,按照标签去重的个数n,编号0~n,相同标签的多行记录转换后的数字标签编号相同

        //这个适合所有非数字且不连续的有限类别数据编号,不仅仅是只能编号标签

        StringIndexerModel labelIndexer = new StringIndexer()

                .setInputCol("Category").setOutputCol("label").fit(df);

        StringIndexerModel DateIndexer = new StringIndexer()

                .setInputCol("Dates").setOutputCol("DatesNum").fit(df);

        StringIndexerModel DayOfWeekIndexer = new StringIndexer()

                .setInputCol("DayOfWeek").setOutputCol("dfNum").fit(df);

        StringIndexerModel PdDistrictIndexer = new StringIndexer()

                .setInputCol("PdDistrict").setOutputCol("pdNum").fit(df);

        /*独热编码将类别特征(离散的,已经转换为数字编号形式(这个是必须的,否则会报错),

        映射成独热编码,生成的是一个稀疏向量

        比如字符串"abcab"的映射规则:去重后的特征个数n即为稀疏向量的维数,而数字编号代

        表该特征对应的向量中非0值的下标,最后生成0-1编码的向量

        a  1 0 0

        b  0 1 0

        c  0 0 1

        a  1 0 0

        b  0 1 0

        */

        //OneHotEncoder不需要fit

        OneHotEncoder encoder = new OneHotEncoder().setInputCol("dfNum")

                .setOutputCol("dfvec")

                .setDropLast(false);  // 设置最后一个是否包含

        OneHotEncoder encoder1 = new OneHotEncoder().setInputCol("pdNum")

                .setOutputCol("pdvec")

                .setDropLast(false);// 设置最后一个是否包含

        OneHotEncoder encoder2 = new OneHotEncoder().setInputCol("DatesNum")

                .setOutputCol("Datesvec")

                .setDropLast(false);// 设置最后一个是否包含

        //将多个列拼接成一个向量,列的类型可以是向量

        VectorAssembler assembler = new VectorAssembler().setInputCols(

                "Datesvec,dfvec,pdvec".split(",")).setOutputCol("features");

        // Dataset<Row> assembledFeatures = assembler.transform(df);

        Pipeline pipeline = new Pipeline().setStages(new PipelineStage[] {

                DateIndexer, DayOfWeekIndexer, PdDistrictIndexer, encoder,

                encoder1, encoder2, labelIndexer, assembler });

        // Train model. This also runs the indexers.

        PipelineModel model = pipeline.fit(df);

        // Make predictions.

        Dataset<Row> predictions = model.transform(df);

        predictions.describe("label").show();

        predictions.show(, false);

        return predictions;

    }

+-------------------+---------+----------+--------------+--------+-----+-----+-------------+--------------+-----------------------+-----+---------------------------------------------+

|Dates |DayOfWeek|PdDistrict|Category |DatesNum|dfNum|pdNum|dfvec |pdvec |Datesvec |label|features |

+-------------------+---------+----------+--------------+--------+-----+-----+-------------+--------------+-----------------------+-----+---------------------------------------------+

|-- ::|Wednesday|NORTHERN |WARRANTS |172231.0|1.0 |2.0 |(,[],[1.0])|(,[],[1.0])|(,[],[1.0])|7.0 |(,[,,],[1.0,1.0,1.0])|

|-- ::|Wednesday|NORTHERN |OTHER OFFENSES|172231.0|1.0 |2.0 |(,[],[1.0])|(,[],[1.0])|(,[],[1.0])|1.0 |(,[,,],[1.0,1.0,1.0])|

|-- ::|Wednesday|BAYVIEW |LARCENY/THEFT |330092.0|1.0 |3.0 |(,[],[1.0])|(,[],[1.0])|(,[],[1.0])|0.0 |(,[,,],[1.0,1.0,1.0])|

|-- ::|Wednesday|MISSION |OTHER OFFENSES|387792.0|1.0 |1.0 |(,[],[1.0])|(,[],[1.0])|(,[],[1.0])|1.0 |(,[,,],[1.0,1.0,1.0])|

|-- ::|Wednesday|SOUTHERN |BURGLARY |32607.0 |1.0 |0.0 |(,[],[1.0])|(,[],[1.0])|(,[],[1.0]) |8.0 |(,[,,],[1.0,1.0,1.0]) |

|-- ::|Wednesday|BAYVIEW |LARCENY/THEFT |32607.0 |1.0 |3.0 |(,[],[1.0])|(,[],[1.0])|(,[],[1.0]) |0.0 |(,[,,],[1.0,1.0,1.0]) |

|-- ::|Wednesday|PARK |LARCENY/THEFT |32607.0 |1.0 |8.0 |(,[],[1.0])|(,[],[1.0])|(,[],[1.0]) |0.0 |(,[,,],[1.0,1.0,1.0]) |

+-------------------+---------+----------+--------------+--------+-----+-----+-------------+--------------+-----------------------+-----+---------------------------------------------+

only showing top  rows
*******************************************************************************************************************

数据2:

id,name,age,sex,rate

,lyy,,F,0.6

,rdd,,M,0.4

,nyc,,M,0.55

,mzy,,M,0.21
 //Binarizer二值化: 将该列数据二值化,大于阈值的为1.0,否则为0.0  spark源码:udf { in: Double => if (in > td) 1.0 else 0.0 }

 Dataset<Row> result = new Binarizer()

                 .setInputCol("rate")

                 .setOutputCol("flag")

                 .setThreshold(0.5).transform(data);

                 result.show(, false);
+---+----+---+---+----+----+

|id |name|age|sex|rate|flag|

+---+----+---+---+----+----+

| |lyy | |F |0.6 |1.0 |

| |rdd | |M |0.4 |0.0 |

| |nyc | |M |0.55|1.0 |

| |mzy | |M |0.21|0.0 |

+---+----+---+---+----+----+
 //IndexToString将stringindexder转换的数据转回到原始的数据

  StringIndexer labelIndexer = new StringIndexer()

                  .setInputCol("sex")

                  .setOutputCol("label");

                  IndexToString IndexToSex = new  IndexToString()

                              .setInputCol("label")

                              .setOutputCol("orisex");

                  Pipeline pipeline = new Pipeline().setStages(new PipelineStage[] {    labelIndexer,    IndexToSex});

                  PipelineModel model = pipeline.fit(data);

                  // Make predictions.

                  Dataset<Row> result = model.transform(data);

                  result.show(, false);

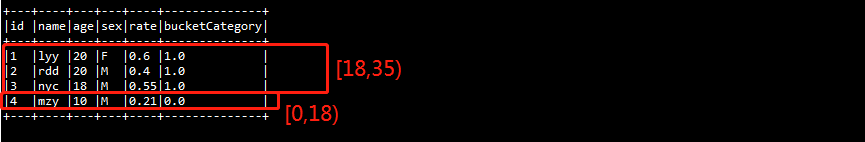
                 //Bucketizer 分箱(分段处理):将连续数值转换为离散类别

                 //比如特征是年龄,是一个连续数值,需要将其转换为离散类别(未成年人、青年人、中年人、老年人),就要用到Bucketizer了

                 //如age > 55 老年人

                 double[] splits={,,,,Double.POSITIVE_INFINITY};//[0,18),[18,35),[35,55),[55,正无穷)

                 Dataset<Row> result=new Bucketizer()

                  .setInputCol("age")

                  .setOutputCol("bucketCategory")

                  .setSplits(splits)//设置分段标准

                  .transform(data);

                 result.show(, false);
sparkML原始数据转换成label-features方法的更多相关文章
- C#部分---arraylist集合、arraylist集合中的object数据转换成int类string类等;间隔时间的表示方法;
ArrayList和Array的区别: 相同点:1.两者都实现了IList.ICollection.IEnumerable接口: 2.两者都可以使用证书索引访问集合中的元素,包括读取和赋值 ...
- [数据库] SQL查询语句表行列转换及一行数据转换成两列
原文来自:http://blog.csdn.net/Eastmount/article/details/50559008 本文主要讲述了SQL查询语句表之间的行列转换,同时也包括如何将一行数据转换成两 ...
- ASP.Net中实现上传过程中将文本文件转换成PDF的方法
iTextSharp是一个常用的PDF库,我们可以使用它来创建.修改PDF文件或对PDF文件进行一些其他额外的操作.本文讲述了如何在上传过程中将文本文件转换成PDF的方法. 基本工作 在开始之前,我们 ...
- 【转】C#中将JSon数据转换成实体类,将实体类转换成Json
http://wo13145219.iteye.com/blog/2022667 http://json2csharp.chahuo.com/ using System; using System.C ...
- OC中如何把数组中字典的数据转换成URL?
在使用objective-c语言开发iOS应用中,会向服务器通过URL请求一些数据,因此对URL的拼接肯定少不了.而在iOS中,我们一般是通过将字典中的数据拼接成我们要请求的URL字符串,那这个是怎么 ...
- 利用JAVA反射机制将JSON数据转换成JAVA对象
net.sf.json.JSONObject为我们提供了toBean方法用来转换为JAVA对象, 功能更为强大, 这里借鉴采用JDK的反射机制, 作为简单的辅助工具使用, 有些数据类型需要进行转 ...
- 用JavaScript将Canvas内容转化成图片的方法
上周我们花了半天时间开发下一个准备放进Mozilla Marketplace的应用.有一个应用现在非常的火热,那就是Instagram,Facebook花了100万美元收购了它.我们也想有100万美元 ...
- 第一百二十七节,JavaScript,JSON数据类型转换,数据转换成字符串,字符串转换成数据
第一百二十七节,JavaScript,JSON数据类型转换,数据转换成字符串,字符串转换成数据 学习要点: 1.JSON语法 2.解析和序列化 前两章我们探讨了XML的结构化数据,但开发人员还是觉得这 ...
- 将undefault和null的数据转换成bool类型的数据 使用!!
<script> var o={}; var a=null; console.info(!!o.name); </script> 输出false 此方法是将undefault和 ...
随机推荐
- 基于uIP和uC/OS-II嵌入式网络开发
基于uIP和uC/OS-II嵌入式网络开发 ——uIP主动发送数据分析 摘要:uIP协议栈简单易用,可以为16位单片机或者是更低级的处理器使用,占用的资源很少,相关移植网上有详细介绍,本文主要讨论uI ...
- qt+vs2005新建配置不自动加载Generated Files进工程(个人备份)
工程右键Qt Project Settings 的Moc Directory路径删除 确定,再进入将删除路径加上
- EF Core中怎么实现自动更新实体的属性值到数据库
我们在开发系统的时候,经常会遇到这种需求数据库表中的行被更新时需要自动更新某些列. 数据库 比如下面的Person表有一列UpdateTime,这列数据要求在行被更新后自动更新为系统的当前时间. Pe ...
- JAVA格式化解析日期
- 大数据框架-YARN
YARN(Yet Another Resource Negotiator): 是一种新的 Hadoop 资源管理器 [ResourceManager:纯粹的调度器,基于应用程序对资源的需求进行调度的, ...
- #leetcode刷题之路12-整数转罗马数字
罗马数字包含以下七种字符: I, V, X, L,C,D 和 M. 字符 数值I 1V 5X 10L 50C 100D 500M 1000 例如, 罗马数字 2 写做 II ,即为两个并列的 1.12 ...
- javascript最常用的对象创建方式
//第一种 function Demo(){ var obj=new Object(); obj.name="Yubaba"; obj.age=12; obj.firstF=fun ...
- div盒子水平垂直居中的方法推荐
父盒子是position:relative 方法一:(宽高确定) div绝对定位水平垂直居中[margin 负间距], 方法二: (宽高确定) div绝对定位水平垂直居中[margin:auto实现绝 ...
- thinkPHP5.0框架验证码调用及点击图片刷新简单实现方法
这篇文章主要介绍了thinkPHP5.0框架验证码调用及点击图片刷新简单实现方法,结合简单示例形式分析了thinkPHP5框架验证码相关配置.后台验证.前台刷新等操作技巧,学习thinkphp源码的朋 ...
- hadoop生态搭建(3节点)-11.storm配置
# http://archive.apache.org/dist/storm/apache-storm-1.1.0/ # ======================================= ...