
SparkStreaming直连方式读取kafka数据,使用MySQL保存偏移量
SparkStreaming直连方式读取kafka数据,使用MySQL保存偏移量
通过MySQL保存kafka的偏移量,完成直连方式读取数据
使用scalikeJDBC,访问数据库。
1. ScalikeJDBC
ScalikeJDBC 是一款Scala 开发者使用的简洁 DB 访问类库,它是基于 SQL 的,使用者只需要关注 SQL 逻辑的编写,所有的数据库操作都交给 ScalikeJDBC。这个类库内置包含了JDBC API,并且给用户提供了简单易用并且非常灵活的 API。并且,QueryDSL(通用查询查询框架)使你的代码类型安全的并且可重复使用。我们可以在生产环境大胆地使用这款 DB 访问类库。
2.配置文件
//配置数据库信息

//使用IDEA,在resources文件夹下新建文件File文件名为application.conf

db.default.driver="com.mysql.jdbc.Driver"

db.default.url="jdbc:mysql://hadoop01:3306/kafkaOffset?characterEncodeing=utf-8"

db.default.user="root"

db.default.password="root"
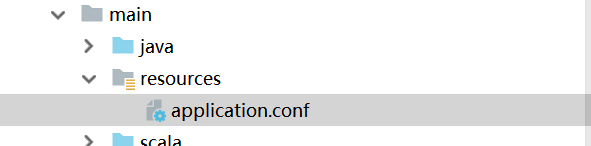
3.导入依赖的jar包
<!--Maven依赖-->

<!--通过mysql保存偏移量-->

        <dependency>

            <groupId>com.typesafe</groupId>

            <artifactId>config</artifactId>

            <version>1.3.1</version>

        </dependency>

        <dependency>

            <groupId>org.scalikejdbc</groupId>

            <artifactId>scalikejdbc_2.11</artifactId>

            <version>2.5.0</version>

        </dependency>

        <dependency>

            <groupId>org.scalikejdbc</groupId>

            <artifactId>scalikejdbc-core_2.11</artifactId>

            <version>2.5.0</version>

        </dependency>

        <dependency>

            <groupId>org.scalikejdbc</groupId>

            <artifactId>scalikejdbc-config_2.11</artifactId>

            <version>2.5.0</version>

        </dependency>
4.源码测试
import kafka.common.TopicAndPartition

import kafka.message.MessageAndMetadata

import kafka.serializer.StringDecoder

import org.apache.spark.SparkConf

import org.apache.spark.rdd.RDD

import org.apache.spark.streaming.dstream.InputDStream

import org.apache.spark.streaming.kafka.KafkaCluster.Err

import org.apache.spark.streaming.kafka.{HasOffsetRanges, KafkaCluster, KafkaUtils, OffsetRange}

import org.apache.spark.streaming.{Duration, StreamingContext}

import scalikejdbc.{DB, SQL}

import scalikejdbc.config.DBs

/*

将偏移量保存到MySQL中

 */

object SparkStreamingOffsetMySql {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setAppName("medd").setMaster("local[2]")

    val ssc = new StreamingContext(conf,Duration(5000))

    //配置一系列基本配置

    val groupid = "GPMMCC"

    val topic = "mysqlDemo"

    val brokerList = "hadoop01:9092,hadoop02:9092,hadoop03:9092"

   // val zkQuorum = "hadoop01:2181,hadoop02:2181,hadoop03:2181"

    val topics = Set(topic)

    //设置kafka的参数

    val kafkaParams = Map(

      "metadata.broker.list"->brokerList,

      "group.id"->groupid,

      "auto.offset.reset"->kafka.api.OffsetRequest.SmallestTimeString

    )

    //加载配置 application.conf

    DBs.setup()

    //不需要查询zk中的offset啦,直接查询MySQL中的offset

    val fromdbOffset:Map[TopicAndPartition,Long]=

      DB.readOnly{

        implicit  session=>{

          //查询每个分组下面的所有消息

          SQL(s"select * from offset where groupId = '${groupid}'" +

           //将MySQL中的数据赋值给元组

            s"").map(m=>(TopicAndPartition(m.string("topic"),m.string("partitions").toInt),m.string("untilOffset").toLong))

            .toList().apply()

        }.toMap  //最后toMap ,应为前面的返回值已经给定

      }

    //创建一个DStream,用来获取数据

    var kafkaDStream : InputDStream[(String,String)] = null

    //从MySql中获取数据进行判断

    if(fromdbOffset.isEmpty){

      kafkaDStream = KafkaUtils.createDirectStream[String,String,StringDecoder,

        StringDecoder](ssc,kafkaParams,topics)

    }else{

      //1\ 不能重复消费

      //2\ 保证偏移量

      var checkOffset = Map[TopicAndPartition,Long]()

      //加载kafka的配置

      val kafkaCluster = new KafkaCluster(kafkaParams)

      //首先获得kafka中的所有的topic和partition Offset

      val earliesOffset: Either[Err, Map[TopicAndPartition, KafkaCluster.LeaderOffset]

        ] = kafkaCluster.getEarliestLeaderOffsets(fromdbOffset.keySet)

      //然后开始比较大小,用mysql中的offset和kafka中的offset进行比较

      if(earliesOffset.isRight){

        //去到需要的 大Map

        //物取值

        val tap: Map[TopicAndPartition, KafkaCluster.LeaderOffset] =

        earliesOffset.right.get

        //比较,直接进行比较大小

        val checkOffset = fromdbOffset.map(f => {

          //取kafka中的offset

          //进行比较,不需要重复消费,取最大的

          val KafkatopicOffset = tap.get(f._1).get.offset

          if (f._2 > KafkatopicOffset) {

            f

          } else {

            (f._1, KafkatopicOffset)

          }

        })

        checkOffset

      }

      val messageHandler=(mmd:MessageAndMetadata[String,String])=>{

        (mmd.key(),mmd.message())

      }

      //不是第一次启动的话 ,按照之前的偏移量取数据的偏移量

      kafkaDStream = KafkaUtils.createDirectStream[String,String,StringDecoder

        ,StringDecoder,(String,String)](ssc,kafkaParams,checkOffset

      ,messageHandler)

    }

    var offsetRanges = Array[OffsetRange]()

    kafkaDStream.foreachRDD(kafkaRDD=>{

     offsetRanges = kafkaRDD.asInstanceOf[HasOffsetRanges].offsetRanges

      val map: RDD[String] = kafkaRDD.map(_._2)

      map.foreach(println)

      //更新偏移量

        DB.localTx(implicit session =>{

          //去到所有的topic partition offset

          for (o<- offsetRanges){

            /*SQL("update offset set groupId=? topic=?,partition=?," +

              "untilsOffset=?").bind(groupid,o.topic,o.partition,o.untilOffset).update().apply()*/

            SQL("replace into offset(groupId,topic,partitions,untilOffset) values(?,?,?,?)").bind(

              groupid,o.topic,o.partition.toString,o.untilOffset.toString

            ).update().apply()

          }

        })

    })

    ssc.start()

    ssc.awaitTermination()

  }

}
SparkStreaming直连方式读取kafka数据,使用MySQL保存偏移量的更多相关文章
- Java基础知识强化之网络编程笔记16:Android网络通信之 使用Http的Get方式读取网络数据(基于HTTP通信技术)
使用Http的Get方式读取网络数据,使用Get方式与网络通信是最常见的Http通信,建立链接之后就可以通过输入流读取网络数据. 详见:Android(java)学习笔记209:采用get请求提交数据 ...
- flume 读取kafka 数据
本文介绍flume读取kafka数据的方法 代码: /************************************************************************* ...
- spark读取kafka数据 createStream和createDirectStream的区别
1.KafkaUtils.createDstream 构造函数为KafkaUtils.createDstream(ssc, [zk], [consumer group id], [per-topic, ...
- 使用 Http 的 Get 方式读取网络数据
作为移动平台的应用,一定避免不了与网络交换数据,不论是读取网页数据,还是调用API接口,都必须掌握Http通信技术 代码如下: package zw1; import java.io.Buffered ...
- flink 读取kafka 数据,partition分配
每个并发有个编号,只会读取kafka partition % 总并发数 == 编号 的分区 如: 6 分区, 4个并发 分区: p0 p1 p2 p3 p4 p5 并发: 0 1 2 3 ...
- jxl读写excel, poi读写excel,word, 读取Excel数据到MySQL
这篇blog是介绍: 1. java中的poi技术读取Excel数据,然后保存到MySQL数据中. 2. jxl读写excel 你也可以在 : java的poi技术读取和导入Excel了解到写入Exc ...
- 关于mapreducer 读取hbase数据 存入mysql的实现过程
mapreducer编程模型是一种八股文的代码逻辑,就以用户行为分析求流存率的作为例子 1.map端来说:必须继承hadoop规定好的mapper类:在读取hbase数据时,已经有现成的接口 Tabl ...
- java的poi技术读取Excel数据到MySQL
这篇blog是介绍java中的poi技术读取Excel数据,然后保存到MySQL数据中. 你也可以在 : java的poi技术读取和导入Excel了解到写入Excel的方法信息 使用JXL技术可以在 ...
- php+phpspreadsheet读取Excel数据存入mysql
先生成Excel模板,然后导入Excel数据到mysql,每条数据对应图片上传到阿里云 <?php /** * Created by PhpStorm. * User: Administrato ...
随机推荐
- 知乎上看到的一篇讲解Epoll的文章,较形象生动
作者:蓝形参链接:https://www.zhihu.com/question/20122137/answer/14049112来源:知乎著作权归作者所有.商业转载请联系作者获得授权,非商业转载请注明 ...
- 笔记本使用网线连接可以进行ftp下载,但是通过wifi连接只能登陆不能下载的问题。
环境: (1)服务器为阿里云服务器,有公网ip,有内网ip,公网和内网已经做了相关端口的映射,ftp服务器为FileZilla,ftp服务器被动模式已开启,防火墙已关闭 (2)ftp客户端为java写 ...
- spark进行相同列的join时,只留下A与B关系,不要B与A
一.问题需求: 近期需要做一个商品集合的相关性计算,需要将所有商品进行两两组合笛卡尔积,但spark自带的笛卡尔积会造成过多重复,而且增加join量 假如商品集合里面有: aa aa bb b ...
- 一次 Nginx proxy_set_header 故障问题解析和延升
目录 一.问题和排查步骤 1.1 问题基本信息 1.2 问题解析 1.3.解决办法 二.扩展-各种情况对比 默认两项 proxy_set_header 其他项等 总结 三.扩展 ->脚本 pro ...
- Java中定时器Timer致命缺点(附学习方法)
简介 这篇文章我一直在纠结到底要不要写,不想写一来因为定时器用法比较简单,二来是面试中也不常问.后来还是决定写了主要是想把自己分析问题思路分享给大家,让大家在学习过程中能够参考,学习态度我相信大部分人 ...
- sql server 用触发器记录增删改操作(转载)
数据库结构: CREATE TABLE [dbo].[cg_tz_log] ( [logid] int NOT NULL IDENTITY(1,1) , operate varchar(10), -- ...
- 【Java基础】异常处理
异常处理 异常概述 在 Java 语言中,将程序执行中发生的不正常情况称为"异常",但是开发过程中的语法错误和逻辑错误不是异常. 在执行过程中所发生的异常事件可分为两类: Erro ...
- 网络之HTTPS
文章目录 HTTPS的基本概念 HTTP和HTTPS的区别 HTTPS的优点 对称加密和非对称加密 对称加密 非对称加密 HTTPS采用的加密方式 认证 证书的组成 使用openssl怎么制造证书 H ...
- 关于软件架构中的b/s
**B/S架构 b/s只需要一个浏览器,用户就可以通过不同的网址访问不同的服务器程序. 优点:开发,安装,部署,维护简单 缺点:对硬件要求过高,用户的体验会受到影响 首先是资源分类:**可以分为静态资 ...
- nginx: [emerg] bind() to 0.0.0.0:80 failed (10013:
问题出现 今天在win10安装nginx时候,启动nginx.exe时在dos窗口出现了这个错误,特此记录一下. 解决方法 上面报错信息的意思大概是:0.0.0:80地址访问不被允许.可能是80端口号 ...