
xgboost安装与原理
1、xgboost库的安装
先在网址https://www.lfd.uci.edu/~gohlke/pythonlibs/#xgboost 中下载whl文件,注意一定要下载跟自己当前安装Python版本一致的whl文件
比如我是Python3.6,64位操作系统,所以要安装xgboost-0.72-cp36-cp36m-win_amd64.whl。
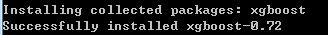
然后将它放到conda文件夹下,用anaconda prompt切换到该路径下,使用pip install xgboost-0.72-cp36-cp36m-win_amd64.whl安装文件就可以了。
2、原理说明
说明:监督学习与非监督学习
监督学习是根据带标签的数据进行数据学习。所谓监督学习,就是两步,一是定出模型确定参数,二是根据训练数据找出最佳的参数值,所谓最佳,从应用角度看,就是最大程度地吸收了10万条训练数据中的知识。
如何寻找最佳参数?
确定目标函数,根据目标函数的值确定预测模型的好坏,但是存在的问题是:1)预测样本中有错误值;2)样本中可能含有极端值。比如说我们对60岁以上年纪的人的数据预测模型去预测6岁孩子的数据,结果自然是不具有参考性的。那么,如何使得参数最优呢?
那就是正则化。
所谓正则化就是对参数施加一定的控制,防止参数走向极端。以上面的例子来说,假如10万条数据中,得癌症的病人都是60岁以上老人,没得癌症的病人都是30岁以下年轻人,检查结果中有一项是骨质密度,通常,老人骨质密度低,年轻人骨质密度高。那么我们学习到的模型很可能是这样的,对骨质密度这项对应的参数θ_j设的非常大,其他的参数都非常小,简单讲,模型倾向于就用这一项检查结果去判断病人是否得癌症,因为这样会让目标函数最小。
常用的正则化就是L2正则,也就是所有参数的平方和。我们希望这个和尽可能小的同时,模型对训练数据有尽可能好的预测。
最后,我们将L2正则项加到最初的目标函数上,就得出了最终的目标函数:
obj = ∑_i(sigmoid(∑_j θ_j*x_ij) - y_i)^2 + ∑_j(θ_j^2)
能使这个函数值最小的那组参数就是我们要找的最佳参数。这个obj包含的两项分别称为损失函数和正则项。
这里的正则项,本质上是用来控制模型的复杂度。
其中L是损失函数,度量模型预测与真实值的误差。常用的损失函数:
预测问题的平方损失函数:
logistic 损失:
ΩΩ是正则化项,度量模型的复杂度,避免过拟合,常用的正则化有L1 和L2正则化。
假设有两颗回归树,则两棵树融合后的预测结果如上图。
用公式表示为:
其中, K 是树的个数, fk(xi)fk(xi)是第k棵树对于输入 xixi 输出的得分, fkfk是相应函数, FF 是相应函数空间。
则目标函数为:
函数ll描述yiyi , yi^yi^之间的距离。
常用的模型融合方法是Random Foreast和Boosting Tree,这两种方法构造树的方式不同。Tree Ensemble中,模型的参数是什么呢?其实就是指树的结构和叶子节点上面分数的预测。如何求参数?定义目标函数,通过优化目标函数进行求解。
xgboost进一步理解
传统GBDT以CART作为基分类器,xgboost还支持线性分类器,这个时候xgboost相当于带L1和L2正则化项的逻辑斯蒂回归(分类问题)或者线性回归(回归问题)。
传统GBDT在优化时只用到一阶导数信息,xgboost则对代价函数进行了二阶泰勒展开,同时用到了一阶和二阶导数。顺便提一下,xgboost工具支持自定义代价函数,只要函数可一阶和二阶求导。
xgboost在代价函数里加入了正则项,用于控制模型的复杂度。正则项里包含了树的叶子节点个数、每个叶子节点上输出的score的L2模的平方和。从Bias-variance tradeoff角度来讲,正则项降低了模型的variance,使学习出来的模型更加简单,防止过拟合,这也是xgboost优于传统GBDT的一个特性。
Shrinkage(缩减),相当于学习速率(xgboost中的eta)。xgboost在进行完一次迭代后,会将叶子节点的权重乘上该系数,主要是为了削弱每棵树的影响,让后面有更大的学习空间。实际应用中,一般把eta设置得小一点,然后迭代次数设置得大一点。(补充:传统GBDT的实现也有学习速率)
列抽样(column subsampling)。xgboost借鉴了随机森林的做法,支持列抽样,不仅能降低过拟合,还能减少计算,这也是xgboost异于传统gbdt的一个特性。
对缺失值的处理。对于特征的值有缺失的样本,xgboost可以自动学习出它的分裂方向。XGBoost对于确实值能预先学习一个默认的分裂方向
xgboost工具支持并行。boosting不是一种串行的结构吗?怎么并行的?注意xgboost的并行不是tree粒度的并行,xgboost也是一次迭代完才能进行下一次迭代的(第t次迭代的代价函数里包含了前面t-1次迭代的预测值)。xgboost的并行是在特征粒度上的。我们知道,决策树的学习最耗时的一个步骤就是对特征的值进行排序(因为要确定最佳分割点),xgboost在训练之前,预先对数据进行了排序,然后保存为block结构,后面的迭代中重复地使用这个结构,大大减小计算量。这个block结构也使得并行成为了可能,在进行节点的分裂时,需要计算每个特征的增益,最终选增益最大的那个特征去做分裂,那么各个特征的增益计算就可以开多线程进行。
我:
可并行的近似直方图算法。树节点在进行分裂时,我们需要计算每个特征的每个分割点对应的增益,即用贪心法枚举所有可能的分割点。当数据无法一次载入内存或者在分布式情况下,贪心算法效率就会变得很低,所以xgboost还提出了一种可并行的近似直方图算法,用于高效地生成候选的分割点。
xgboost安装与原理的更多相关文章
- pxe网络安装操作系统 原理与详细过程
摘要:在实际工作中,我们经常会遇到这样的情况:想要安装Linux但是计算机不带光驱或软驱,或者是笔记本配置的非标准的软驱和光驱,如1394接口,USB接口等,在Linux安装时所引导的Linux内核一 ...
- win7 64 python2 xgboost安装
综述: 首先,关于xgboost是啥,可以看这一篇:机器学习(四)--- 从gbdt到xgboost 安装Python3 环境下的xgboost 可以通过pip install , 在网址中下载对应版 ...
- hadoop高可用安装和原理详解
本篇主要从hdfs的namenode和resourcemanager的高可用进行安装和原理的阐述. 一.HA安装 1.基本环境准备 1.1.1.centos7虚拟机安装,详情见VMware安装Cent ...
- oozie配置安装与原理
概述 当前开源的hadoop任务工作流管理主要有oozie和Azkaban,本文先介绍oozie的配置安装与基本运行原理. 配置安装 (参考https://segmentfault.com/a/11 ...
- mydumper安装、原理介绍
一.安装 安装依赖包: yum install glib2-devel mysql-devel zlib-devel pcre-devel openssl-devel cmake 下载二进制包: ...
- xgboost安装
安装连接:https://www.zhihu.com/question/46377605 软件连接:https://www.lfd.uci.edu/~gohlke/pythonlibs/#xgboos ...
- Cobbler实现自动化安装(上)--原理篇
了解Cobbler之前,我们需要先对PXE及KickStart有一定的认识. PXE PXE(Pre-bootExecution Environment),预启动执行环境,通过网络接口启动计算机,支持 ...
- xgboost 安装
git clone --recursive https://github.com/dmlc/xgboostcd xgboost/make -j4 cd python-package/ python s ...
- [Python Debug] How to install external python package? MAC系统下的xgboost安装
从昨天晚上开始安装xgboost,经历了各种稀奇古怪的错误,终于现在程序可以跑起来了.整个过程对python编译环境,路径设置,package安装方法有了一定了解,当然还有一些疑惑,所以姑且做个记录. ...
随机推荐
- HTML img标签的width height ismap usemap title alt 属性
前言 img 元素向网页中嵌入一幅图像 今天特地对 img 的几个属性做了一下测试,在这里做一个笔记. 1. img 元素的width属性和height属性. (1)不设置 width 和 和 hei ...
- 说一说 HTML 中的 script 标签
我们在 <Javascript简史>这遍文章中说过,「Javascript」这门语言是由 Netscape开发而来,当初开发的时候为了能让 「Javascript」这门语言能与 HTML ...
- XCTF---easyjni的WriteUp
一.题目来源 题目来源:XCTF的mobile区的easyjni题目. 题目下载地址:题目链接地址 二.解题过程 1.下载好题目后,安装到夜神模拟器中,发现有一个输入框和一个按 ...
- JavaScript(js)函数声明与函数表达式的区别
在JavaScript中,函数是经常用到的,在实际开发的时候,我想很多人都没有太在意函数的声明与函数表达式的区别,但是呢,这种细节的东西对于学好js是非常重要的. 函数声明与函数表达式用代码写出来是这 ...
- yolo3各部分代码详解(超详细)
0.摘要 最近一段时间在学习yolo3,看了很多博客,理解了一些理论知识,但是学起来还是有些吃力,之后看了源码,才有了更进一步的理解.在这里,我不在赘述网络方面的代码,网络方面的代码比较容易理解,下面 ...
- AX2012/D365 SSRS报表开发
大家好,好久没有做SSRS报表了,近期刚好有做2张,就整理起来供初学者参考. AX中SSRS报表开发的框架,父类非常多,这里跟大家简单分享2种比较常用的场景供大家使用. 1.简单的过滤字段,无特殊过滤 ...
- Simulink仿真入门到精通(七) Simulink的回调函数
7.1 什么是回调函数 Callback functions(回调函数)是因某种操作而除法对其调用的函数,如按下按钮或双击操作等. 常用的Simulink回调函数可应用在以下场合: 打开Simulin ...
- 新手学黑客攻防-黑客攻击电脑方式和认识IP地址
听说过黑客,没见过黑客,从最基础的开始学习,让我能在互联网中保护自己的隐私安全和信息安全. 黑客攻击电脑方式 黑客攻击的方式多种多样,但常见的只有以下几种,基本上每个黑客都会用到: 网络报文嗅探 网络 ...
- 你会无聊到把Administrator用户禁用,并且自己创建的用户搞到消失掉还有Administrator用户被禁吗。。。。。
2020年3月17日20:07:00 如文章标题哈,就是这么任性,无奈 事件起因:因为要部署项目,并且需要将线上的Oracle数据库导入到本地Oracle数据库中突然发现使用 sqlplus 连接数据 ...
- python之 filter
filter的语法:filter(函数名字,可迭代的变量) 其实filter就是一个“过滤器”:把[可迭代的变量]中的值,挨个地传给函数进行处理,那些使得函数的返回值为True的变量组成的迭代器对象就 ...