
NULL在oracle和mysql索引上的区别
一、问题
oracle的btree索引不存储NULL值,所以用is null或is not null都不会用到索引范围扫描,但是在mysql中也是这样吗?
二、实验
先看看NULL在oracle(11g)中的情况
准备测试数据
SQL> create table t1 as select * from dba_objects;

SQL> update t1 set object_id = null where object_id > 17840;

SQL> update t1 set data_object_id = null where data_object_id > 60;

SQL> commit;

SQL> create index idx1_id on t1(object_id);

SQL> create index idx2_data on t1(data_object_id);
搜集统计信息
SQL> begin

dbms_stats.gather_table_stats(ownname => 'SCOTT',

tabname => 'T1',

estimate_percent => 100,

cascade => true,

method_opt => 'for all indexed columns size auto',

no_invalidate => false,

degree => 4);

end;

/
查看数据分布
SQL> select count(*) "总行数",

  2         count(distinct object_id) "object_id非空不同值",

  3         count(decode(object_id,null,1,null)) "object_id空值总数",

  4         count(distinct data_object_id) "data_object_id非空不同值",

  5         count(decode(data_object_id,null,1,null)) "data_object_id空值总数"

  6    from t1;

    总行数 object_id非空不同值 object_id空值总数 data_object_id非空不同值 data_object_id空值总数

---------- ------------------- ----------------- ------------------------ ----------------------

     13582               13578                 4                       47                  13510
执行sql,并查看执行计划
第1条sql:is null返回行数少
SQL> select * from t1 where object_id is null;

--------------------------------------------------------------------------

| Id  | Operation         | Name | Rows  | Bytes | Cost (%CPU)| Time     |

--------------------------------------------------------------------------

|   0 | SELECT STATEMENT  |      |       |       |    50 (100)|          |

|*  1 |  TABLE ACCESS FULL| T1   |     4 |   352 |    50   (0)| 00:00:01 |

--------------------------------------------------------------------------
第2条sql:is not null返回行数多
SQL> select * from t1 where object_id is not null;

--------------------------------------------------------------------------

| Id  | Operation         | Name | Rows  | Bytes | Cost (%CPU)| Time     |

--------------------------------------------------------------------------

|   0 | SELECT STATEMENT  |      |       |       |    50 (100)|          |

|*  1 |  TABLE ACCESS FULL| T1   | 13578 |  1166K|    50   (0)| 00:00:01 |

--------------------------------------------------------------------------
第3条sql:is null返回行数多
SQL> select * from t1 where data_object_id is null;

--------------------------------------------------------------------------

| Id  | Operation         | Name | Rows  | Bytes | Cost (%CPU)| Time     |

--------------------------------------------------------------------------

|   0 | SELECT STATEMENT  |      |       |       |    50 (100)|          |

|*  1 |  TABLE ACCESS FULL| T1   | 13510 |  1161K|    50   (0)| 00:00:01 |

--------------------------------------------------------------------------
第4条sql:is not null返回行数少
SQL> select * from t1 where data_object_id is not null;

-----------------------------------------------------------------------------------------

| Id  | Operation                   | Name      | Rows  | Bytes | Cost (%CPU)| Time     |

-----------------------------------------------------------------------------------------

|   0 | SELECT STATEMENT            |           |       |       |     7 (100)|          |

|   1 |  TABLE ACCESS BY INDEX ROWID| T1        |    72 |  6336 |     7   (0)| 00:00:01 |

|*  2 |   INDEX FULL SCAN           | IDX2_DATA |    72 |       |     1   (0)| 00:00:01 |

-----------------------------------------------------------------------------------------
可以看到第1条和第3条sql不会用到索引,这是由于oracle的btree索引并不存储NULL,所以用is null作为条件在索引中找不到任何结果,只能全表扫。
第2条sql也没有用到索引,因为返回的行数多。第4条sql用到了索引,但用的是索引全扫描,原理其实还是由于索引不存储NULL,is not null正好跟索引特性相同。
接下来我们看看在mysql(8.0)中又会是什么情形,通过工具把上面的表导入到mysql中
更新t1表的统计信息
analyze table t1;
查看执行计划
第5条sql:is null返回行数少
(scott@localhost)[hello]> explain select * from t1 where object_id is null;

+----+-------------+-------+------------+------+---------------+---------+---------+-------+------+----------+-----------------------+

| id | select_type | table | partitions | type | possible_keys | key     | key_len | ref   | rows | filtered | Extra                 |

+----+-------------+-------+------------+------+---------------+---------+---------+-------+------+----------+-----------------------+

|  1 | SIMPLE      | t1    | NULL       | ref  | IDX1_ID       | IDX1_ID | 5       | const |    4 |   100.00 | Using index condition |

+----+-------------+-------+------------+------+---------------+---------+---------+-------+------+----------+-----------------------+
第6条sql:is not null返回行数多
(scott@localhost)[hello]> explain select * from t1 where object_id is not null;

+----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+-------------+

| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref  | rows  | filtered | Extra       |

+----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+-------------+

|  1 | SIMPLE      | t1    | NULL       | ALL  | IDX1_ID       | NULL | NULL    | NULL | 13541 |    50.00 | Using where |

+----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+-------------+
第7条sql:is null返回行数多
(scott@localhost)[hello]> explain select * from t1 where data_object_id is null;

+----+-------------+-------+------------+------+---------------+-----------+---------+-------+------+----------+-----------------------+

| id | select_type | table | partitions | type | possible_keys | key       | key_len | ref   | rows | filtered | Extra                 |

+----+-------------+-------+------------+------+---------------+-----------+---------+-------+------+----------+-----------------------+

|  1 | SIMPLE      | t1    | NULL       | ref  | IDX2_DATA     | IDX2_DATA | 5       | const | 6770 |   100.00 | Using index condition |

+----+-------------+-------+------------+------+---------------+-----------+---------+-------+------+----------+-----------------------+
第8条sql:is not null返回行数少
(scott@localhost)[hello]> explain select * from t1 where data_object_id is not null;

+----+-------------+-------+------------+-------+---------------+-----------+---------+------+------+----------+-----------------------+

| id | select_type | table | partitions | type  | possible_keys | key       | key_len | ref  | rows | filtered | Extra                 |

+----+-------------+-------+------------+-------+---------------+-----------+---------+------+------+----------+-----------------------+

|  1 | SIMPLE      | t1    | NULL       | range | IDX2_DATA     | IDX2_DATA | 5       | NULL |   72 |   100.00 | Using index condition |

+----+-------------+-------+------------+-------+---------------+-----------+---------+------+------+----------+-----------------------+
可以看到在mysql中,is not null会根据返回的行数来决定用不用索引,返回行数多不用索引,返回行数少用索引,这一点跟oracle相同。但is null都会用到索引,不管你返回的行数是多少,这点的确是出乎我的意料。既然is null用到索引,那么难道是mysql的btree索引中包含NULL值?
查看索引的信息
(scott@localhost)[hello]> select * from mysql.innodb_index_stats where database_name='hello' and table_name='t1' and index_name in ('IDX1_ID', 'IDX2_DATA');
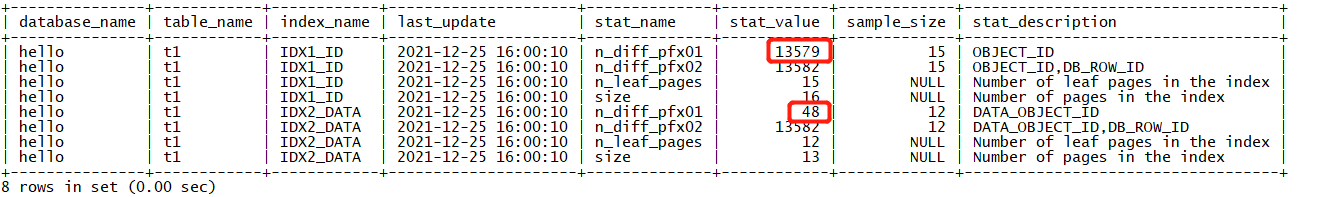
从索引的统计信息中可以看到,mysql认为t1表的OBJECT_ID,DATA_OBJECT_ID的不同值分别是13579,48。而前面我们知道object_id非空不同值和data_object_id非空不同值分别为13578和47。两者都相差1,那也就是说索引的确是含NULL值。
三、总结
- mysql中btree索引含NULL,这点跟oracle不一样。
- mysql中用is null都会用到索引,不管返回的行数多少,我认为这是一个bug。
水平有限,如果有误,恳请大家指正!
NULL在oracle和mysql索引上的区别的更多相关文章
- Oracle和MySql的分页查询区别和PL/SQL的基本概念
Oracle和MySql的分页查询区别: Oracle的分析查询,之前Oracle的分页是使用伪列 ROWNUM 结合子查询实现,mysql的分页更简单,直接使用 LIMIT 关键字就可以实现 ...
- 图解MySQL索引(上)—MySQL有中“8种”索引?
关于MySQL索引相关的内容,一直是一个让人头疼的问题,尤其是对于初学者来说.笔者曾在很长一段时间内深陷其中,无法分清"覆盖索引,辅助索引,唯一索引,Hash索引,B-Tree索引--&qu ...
- Oracle与MySQL的几点区别
Oracle数据库与MySQL数据库的区别是本文我们主要介绍的内容,希望能够对您有所帮助. 1.组函数用法规则 mysql中组函数在select语句中可以随意使用,但在oracle中如果查询语句中有组 ...
- 深入浅出之mysql索引--上
当着小萌新之际,最近工作中遇到了mysql优化的相关问题,然后既然提到了优化,很多像我这样的小萌新不容置喙,肯定张口就是 建立索引 之类的. 那么说到底,索引到底是什么,它是怎么工作的?接下来就让我和 ...
- 深入理解MySQL索引(上)
简单来说,索引的出现就是为了提高数据查询的效率,就像字典的目录一样.如果你想快速找一个不认识的字,在不借助目录的情况下,那我估计你的找好长时间.索引其实就相当于目录. 几种常见的索引模型 索引的出现是 ...
- Oracle与MySQL的SQL语句区别
2 表 2.1 创建表(同) create table tableName( columnName1 int, columnName2 int ) 2.2 删除表(异) MySQL: drop tab ...
- Oracle中和mysql中函数的区别
oracle --> mysqlto_char(sysdate,'yyyy-mm-dd')-->date_format(s ...
- Oracle与MySQL的区别
1. Oracle是大型数据库而Mysql是中小型数据库,Oracle市场占有率达40%,Mysql只有20%左右,同时Mysql是开源的而Oracle价格非常高. 2. Oracle支持大并发,大访 ...
- SQL Server 和 Oracle 以及 MySQL 数据库
推荐:https://www.zhihu.com/question/19866767 三者是目前市场占有率最高(依安装量而非收入)的关系数据库,而且很有代表性.排行第四的DB2(属IBM公司),与Or ...
随机推荐
- 洛谷 P5249 - [LnOI2019]加特林轮盘赌(期望 dp+高斯消元)
题面传送门 期望真 nm 有意思,所以蒟蒻又来颓期望辣 先特判掉 \(P_0=0\) 的情况,下面假设 \(P_0\ne 0\). 首先注意到我们每次将加特林对准一个人,如果这个人被毙掉了,那么相当于 ...
- jupyter 远程访问
Jupyter 远程访问 jupyter 远程访问的工作方法是,在本地通过浏览器打开jupyter,但是代码和服务运行在远程集群中. 集群设置 首先需要确保集群中安装有python和jupyter. ...
- R 语言实战-Part 3 笔记
R 语言实战(第二版) part 3 中级方法 -------------第8章 回归------------------ #概念:用一个或多个自变量(预测变量)来预测因变量(响应变量)的方法 #最常 ...
- Bedtools genomecov 计算覆盖度
简单说明: 从2.28.0版开始,bedtools使用htslib库支持CRAM格式 除了BAM文件,bedtools默认所有的输入文件都以TAB键分割 除非使用-sorted选项,bedtools默 ...
- R连接mysql数据库方法详解
Warning messages: 1: In odbcDriverConnect("DSN=Rdata;UID=root") : [RODBC] ERROR: state IM0 ...
- Spring Cloud 2021.0.0 正式发布,第一个支持Spring Boot 2.6的版本!
美国时间12月2日,Spring Cloud 正式发布了第一个支持 Spring Boot 2.6 的版本,版本号为:2021.0.0,codename 为 Jubilee. 在了解具体更新内容之前, ...
- day13 cookie与session和中间件
day13 cookie与session和中间件 今日内容概要 cookie与session简介 django操作cookie与session django中间件简介 如何自定义中间件 csrf跨站请 ...
- Linux学习 - 条件判断
一.判断格式 test -e /root/install.log 或 [ -e /root/install.log ] 使用echo $?查看是否正确,当返回0时表示返回正确 1 按照文件类型进行判断 ...
- Java中特殊的类——包装类
Java中特殊的类--包装类 包装类就是将基本数据类型封装在类中. 1.包装类 (1)自定义包装类 将基本数据类型包装成一个类对象的本质就是使用Object进行接收处理. 此时IntDemo类就是in ...
- Android 高级UI组件(一)GridView与ListView
1.GridView 1.GridView学习 GridView和ListView都是比较常用的多控件布局,而GridView更是实现九宫图的首选 main.xml: <?xml version ...