
SparseArray
使用SparseArray更加节省内存空间的使用,SparseArray也是以key和value对数据进行保存的.使用的时候只需要指定value的类型即可.并且key不需要封装成对象类型.
HashMap是数组和链表的结合体,被称为链表散列.
SparseArray是单纯数组的结合.被称为稀疏数组,对数据保存的时候,不会有额外的开销.结构如下:
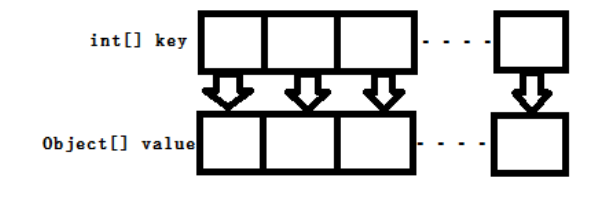
这就是二者的结构,我们需要看一下二者到底有什么差异...
首先是插入:
HashMap的正序插入:
HashMap<Integer, String>map = new HashMap<Integer, String>();

 long start_map = System.currentTimeMillis();

 for(int i=0;i<MAX;i++){

     map.put(i, String.valueOf(i));

 }

 long map_memory = Runtime.getRuntime().totalMemory();

 long end_map = System.currentTimeMillis()-start_map;

 System.out.println("<---Map的插入时间--->"+end_map+"<---Map占用的内存--->"+map_memory);

 执行后的结果:

 <---Map的插入时间--->914

 <---Map占用的内存--->28598272
SparseArray的正序插入:
SparseArray<String>sparse = new SparseArray<String>();

 long start_sparse = System.currentTimeMillis();

 for(int i=0;i<MAX;i++){

        sparse.put(i, String.valueOf(i));

 }

 long sparse_memory = Runtime.getRuntime().totalMemory();

 long end_sparse = System.currentTimeMillis()-start_sparse;

 System.out.println("<---Sparse的插入时间--->"+end_sparse+"<---Sparse占用的内存--->"+sparse_memory);

//执行后的结果:

<---Sparse的插入时间--->611

<---Sparse占用的内存--->23281664
我们可以看到100000条数据量正序插入时SparseArray的效率要比HashMap的效率要高.并且占用的内存也比HashMap要小一些..这里的正序插入表示的是i的值是从小到大进行的一个递增..序列取决于i的值,而不是for循环内部如何执行...
通过运行后的结果我们可以发现,SparseArray在正序插入的时候,效率要比HashMap要快得多,并且还节省了一部分内存。网上有很多的说法关于二者的效率问题,很多人都会误认为SparseArray要比HashMap的插入和查找的效率要快,还有人则是认为Hash查找当然要比SparseArray中的二分查找要快得多.
其实我认为Android中在保存<Integer,Value>的时候推荐使用SparseArray的本质目的不是由于效率的原因,而是内存的原因.我们确实看到了插入的时候SparseArray要比HashMap要快.但是这仅仅是正序插入.我们来看看倒序插入的情况.
HashMap倒序插入:
System.out.println("<------------- 数据量100000 散列程度小 Map 倒序插入--------------->");

  HashMap<Integer, String>map_2 = new HashMap<Integer, String>();

  long start_map_2 = System.currentTimeMillis();

  for(int i=MAX-1;i>=0;i--){

      map_2.put(MAX-i-1, String.valueOf(MAX-i-1));

  }

  long map_memory_2 = Runtime.getRuntime().totalMemory();

  long end_map_2 = System.currentTimeMillis()-start_map_2;

  System.out.println("<---Map的插入时间--->"+end_map_2+"<---Map占用的内存--->"+map_memory_2);

  //执行后的结果:

  <------------- 数据量100000 Map 倒序插入--------------->

  <---Map的插入时间--->836<---Map占用的内存--->28598272
SparseArray倒序插入:
System.out.println("<------------- 数据量100000 散列程度小 SparseArray 倒序插入--------------->");

SparseArray<String>sparse_2 = new SparseArray<String>();

long start_sparse_2 = System.currentTimeMillis();

for(int i=MAX-1;i>=0;i--){

    sparse_2.put(i, String.valueOf(MAX-i-1));

}

long sparse_memory_2 = Runtime.getRuntime().totalMemory();

long end_sparse_2 = System.currentTimeMillis()-start_sparse_2;

System.out.println("<---Sparse的插入时间--->"+end_sparse_2+"<---Sparse占用的内存--->"+sparse_memory_2);

//执行后的结果

<------------- 数据量100000 SparseArray 倒序插入--------------->

<---Sparse的插入时间--->20222<---Sparse占用的内存--->23281664
通过上面的运行结果,我们仍然可以看到,SparseArray与HashMap无论是怎样进行插入,数据量相同时,前者都要比后者要省下一部分内存,但是效率呢?我们可以看到,在倒序插入的时候,SparseArray的插入时间和HashMap的插入时间远远不是一个数量级.由于SparseArray每次在插入的时候都要使用二分查找判断是否有相同的值被插入.因此这种倒序的情况是SparseArray效率最差的时候.
SparseArray的插入源码我们简单的看一下..
public void put(int key, E value) {

        int i = ContainerHelpers.binarySearch(mKeys, mSize, key); //二分查找.

        if (i >= 0) {  //如果当前这个i在数组中存在,那么表示插入了相同的key值,只需要将value的值进行覆盖..

            mValues[i] = value;

        } else {  //如果数组内部不存在的话,那么返回的数值必然是负数.

            i = ~i;  //因此需要取i的相反数.

            //i值小于mSize表示在这之前. mKey和mValue数组已经被申请了空间.只是键值被删除了.那么当再次保存新的值的时候.不需要额外的开辟新的内存空间.直接对数组进行赋值即可.

            if (i < mSize && mValues[i] == DELETED) {

                mKeys[i] = key;

                mValues[i] = value;

                return;

            }

            //当需要的空间要超出,但是mKey中存在无用的数值,那么需要调用gc()函数.

            if (mGarbage && mSize >= mKeys.length) {

                gc();

                // Search again because indices may have changed.

                i = ~ContainerHelpers.binarySearch(mKeys, mSize, key);

            }

            //如果需要的空间大于了原来申请的控件,那么需要为key和value数组开辟新的空间.

            if (mSize >= mKeys.length) {

                int n = ArrayUtils.idealIntArraySize(mSize + 1);

                //定义了一个新的key和value数组.需要大于mSize

                int[] nkeys = new int[n];

                Object[] nvalues = new Object[n];

                // Log.e("SparseArray", "grow " + mKeys.length + " to " + n);

                //对数组进行赋值也就是copy操作.将原来的mKey数组和mValue数组的值赋给新开辟的空间的数组.目的是为了添加新的键值对.

                System.arraycopy(mKeys, 0, nkeys, 0, mKeys.length);

                System.arraycopy(mValues, 0, nvalues, 0, mValues.length);

                //将数组赋值..这里只是将数组的大小进行扩大..放入键值对的操作不在这里完成.

                mKeys = nkeys;

                mValues = nvalues;

            }

            //如果i的值没有超过mSize的值.只需要扩大mKey的长度即可.

            if (mSize - i != 0) {

                // Log.e("SparseArray", "move " + (mSize - i));

                System.arraycopy(mKeys, i, mKeys, i + 1, mSize - i);

                System.arraycopy(mValues, i, mValues, i + 1, mSize - i);

            }

            //这里是用来完成放入操作的过程.

            mKeys[i] = key;

            mValues[i] = value;

            mSize++;

        }

    }
这就是SparseArray插入函数的源码.每次的插入方式都需要调用二分查找.因此这样在倒序插入的时候会导致情况非常的糟糕,效率上绝对输给了HashMap学过数据结构的大家都知道.Map在插入的时候会对冲突因子做出相应的决策.有非常好的处理冲突的方式.不需要遍历每一个值.因此无论是倒序还是正序插入的效率取决于处理冲突的方式,因此插入时牺牲的时间基本是相同的.
通过插入.我们还是可以看出二者的差异的.
我们再来看一下查找首先是HashMap的查找.

  System.out.println("<------------- 数据量100000 Map查找--------------->");

  HashMap<Integer, String>map = new HashMap<Integer, String>();

  for(int i=0;i<MAX;i++){

        map.put(i, String.valueOf(i));

  }

  long start_time =System.currentTimeMillis();

  for(int i=0;i<MAX;i+=100){

           map.get(i);

  }

  long end_time =System.currentTimeMillis()-start_time;

  System.out.println(end_time);

  //执行后的结果

  <!---------查找的时间:175------------>
SparseArray的查找:
  System.out.println("<------------- 数据量100000  SparseArray 查找--------------->");

  SparseArray<String>sparse = new SparseArray<String>();

  for(int i=0;i<10000;i++){

        sparse.put(i, String.valueOf(i));

  }

  long start_time =System.currentTimeMillis();

  for(int i=0;i<MAX;i+=10){

        sparse.get(i);

  }

  long end_time =System.currentTimeMillis()-start_time;

  System.out.println(end_time);

  //执行后的结果

  <!-----------查找的时间:239---------------->
我这里也简单的对查找的效率进行了测试.对一个数据或者是几个数据的查询.二者的差异还是非常小的.当数据量是100000条.查100000条的效率还是Map要快一点.数据量为10000的时候.这就差异性就更小.但是Map的查找的效率确实还是赢了一筹.
其实在我看来.在保存<Integer,E>时使用SparseArray去替换HashMap的主要原因还是因为内存的关系.我们可以看到.保存的数据量无论是大还是小,Map所占用的内存始终是大于SparseArray的.数据量100000条时SparseArray要比HashMap要节约27%的内存.也就是以牺牲效率的代价去节约内存空间.我们知道Android对内存的使用是极为苛刻的.堆区允许使用的最大内存仅仅16M.很容易出现OOM现象的发生.因此在Android中内存的使用是非常的重要的.因此官方才推荐去使用SparseArray<E>去替换HashMap<Integer,E>.官方也确实声明这种差异性不会超过50%.所以牺牲了部分效率换来内存其实在Android中也算是一种很好的选择吧.
SparseArray的更多相关文章
- HashMap和SparseArray的性能比较。
HashMap和SparseArray可以实现相似的功能. 但SparseArray是Android定义的,在键是整数时,他比HashMap的性能更高,因为HashMap使用的是Integer对象, ...
- 关于Android中ArrayMap/SparseArray比HashMap性能好的深入研究
由于网上有朋友对于这个问题已经有了很详细的研究,所以我就不班门弄斧了: 转载于:http://android-performance.com/android/2014/02/10/android-sp ...
- 73.Android之SparseArray替代HashMap
转载:https://liuzhichao.com/p/832.html HashMap是java里比较常用的一个集合类,我比较习惯用来缓存一些处理后的结果.最近在做一个Android项目,在代码中定 ...
- Android学习笔记之性能优化SparseArray
PS:终于考完试了.来一发.微机原理充满了危机.不过好在数据库89分,还是非常欣慰的. 学习内容: 1.Android中SparseArray的使用.. 昨天研究完横向二级菜单,发现其中使用了Sp ...
- SparseArray<E>详解
SparseArray<E> 是官方推荐的用来替代 HashMap<Integer, E> 的一个工具类,相比来说有着更好的性能(其核心是折半查找函数(binarySearch ...
- Android源码分析之SparseArray
本来接下来应该分析MessageQueue了,可是我这几天正好在实际开发中又再次用到了SparseArray(之前有用到过一次,那次只是 大概浏览了下源码,没做深入研究),于是在兴趣的推动下,花了些时 ...
- Android应用性能优化之使用SparseArray替代HashMap
HashMap是java里比较常用的一个集合类,我比较习惯用来缓存一些处理后的结果.最近在做一个Android项目,在代码中定义这样一个变量,实例化时,Eclipse却给出了一个 performanc ...
- SparseArray,dip & px
SparseArray-用Array的方式实现Integer-Object的map 优:节约内存,因为避免了装箱/拆箱,数据结构不依赖Entry 劣:速度不及HashMap dip.px dip(de ...
- Android内存优化(使用SparseArray和ArrayMap代替HashMap)
在Android开发时,我们使用的大部分都是Java的api,比如HashMap这个api,使用率非常高,但是对于Android这种对内存非常敏感的移动平台,很多时候使用一些java的api并不能达到 ...
- Android 开发性能优化之SparseArray(三)
SparseArray是android里为<Interger,Object>这样的Hashmap而专门写的class,目的是提高效率,其核心是折半查找函数(binarySearch) pr ...
随机推荐
- 浅谈分布式消息技术 Kafka(转)
一只神秘的程序猿. Kafka的基本介绍 Kafka是最初由Linkedin公司开发,是一个分布式.分区的.多副本的.多订阅者,基于zookeeper协调的分布式日志系统(也可以当做MQ系统),常见可 ...
- linux thread_info 与thread_struct
有个同事看3.10代码中,看着两个结构,会混淆,所以我简单答复了一下. thread_info是和内核栈放一块的,网上到处都是thread_info的资料,但thread_struct的资料比较少,在 ...
- PHP面向对象(抽象类与抽象方法、接口的实现)
一.抽象类与抽象方法 1,任何一个类,如果它里面至少有一个方法是被声明为抽象的,那么这个类就必须被声明为抽象的. 2,定义为抽象的类不能被实例化. 3, 被定义为抽象的方法只是声明了其调用方式(参数) ...
- 计算平面面积和斜面面积-ArcGIS案例学习笔记
计算平面面积和斜面面积-ArcGIS案例学习笔记 联系方式:谢老师,135_4855_4328,xiexiaokui#139.com 数据:实验数据\Chp8\Ex5\demTif.tif 平面面积= ...
- android资讯类软件框架《IT蓝豹》
android资讯类软件框架 android资讯类软件框架,支持侧滑,并且首页viewpager切换tab,tab滑动到最右侧的时候提示滑动结束, 滑动到最左侧的时候切换滑动侧滑menu.左滑和侧滑处 ...
- zabbix 分布式zabbix_proxy
Zabbix是一个分布式监控系统,它可以以一个中心点.多个分节点的模式运行,使用Proxy能大大的降低Zabbix Server的压力,Zabbix Proxy可以运行在独立的服务器上 1)下载zab ...
- Java编译时多态和运行时多态
来源:https://blog.csdn.net/wendizhou/article/details/73733061 编译时多态:主要是方法的重载,通过参数列表的不同来区分不同的方法. 运行时多态: ...
- SQL server 基本语法
文字摘自https://www.cnblogs.com/chaoa/articles/3894311.html 一.定义变量 --简单赋值 declare @a intset @a=5 print @ ...
- SAP 费用
SAP在华真相:天价收费与用户之灾 SAP真的是企业实施ERP系统的最佳选择吗? 画皮SAP-世界管理软件公司的中国真相 你知道SAP吗?哦,知道,满大街都是嘛,S-P-A,SPA.做出上述回答的是一 ...
- 03_java基础(七)之面向对象
16.封装查询结果对象 封装简单粗暴的理解就是:假设你在超市买苹果,买一个你可以一个手拿走,买两个你可以用两只手拿走,但是如果买了20个勒,咋办勒,那就用一个袋子装起来!这就 封装思想. 1.封装一个 ...