
Flink 集群安装配置
以下操作均在主节点进行
1.环境变量
添加FLINK_HOME以及path的内容:
export FLINK_HOME=/bigdata/flink-1.6.

export PATH=$PATH:$JAVA_HOME/bin:$ZOOKEEPER_HOME/bin:$KAFKA_HOME/bin:${FLINK_HOME}/bin
2.修改conf/flink-conf.yaml
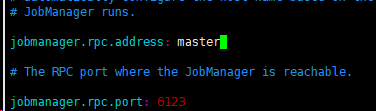
这几乎是最简单的配置方式了,主要注意要修改jobmanager.rpc.address为集群中jobManager的IP或hostname。检查点以及HA的参数都没有配置。
jobmanager.rpc.address: master
3.修改slaves文件
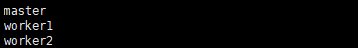
这个文件中存放的信息是taskmanager的hostname。
4.复制flink目录到集群中其他的机器
[root@master ~]# scp -r /bigdata/flink-1.6.1/ root@192.168.36.27:/bigdata/

[root@master ~]# scp -r /bigdata/flink-1.6.1/ root@192.168.36.28:/bigdata/
5.启动Flink集群
先启动zookeeper、kafka、HDfS。
启动Flink:[root@master ~]# start-cluster.sh
master:
[root@master ~]# jps

 Kafka

 QuorumPeerMain

 ResourceManager

 StandaloneSessionClusterEntrypoint

 SecondaryNameNode

 TaskManagerRunner

 NameNode

 DataNode

 Jps
worker1:
[root@worker1 ~]# jps

 StandaloneSessionClusterEntrypoint

 Kafka

 QuorumPeerMain

 Jps

 NodeManager

 DataNode

 TaskManagerRunner
worker2:
[root@worker2 ~]# jps

 TaskManagerRunner

 NodeManager

 QuorumPeerMain

 DataNode

 StandaloneSessionClusterEntrypoint

 Jps

 Kafka
关闭Flink:[root@master ~]# stop-cluster.sh
Flink 集群安装配置的更多相关文章
- 第06讲:Flink 集群安装部署和 HA 配置
Flink系列文章 第01讲:Flink 的应用场景和架构模型 第02讲:Flink 入门程序 WordCount 和 SQL 实现 第03讲:Flink 的编程模型与其他框架比较 第04讲:Flin ...
- CentOS下Hadoop-2.2.0集群安装配置
对于一个刚开始学习Spark的人来说,当然首先需要把环境搭建好,再跑几个例子,目前比较流行的部署是Spark On Yarn,作为新手,我觉得有必要走一遍Hadoop的集群安装配置,而不仅仅停留在本地 ...
- hbase单机环境的搭建和完全分布式Hbase集群安装配置
HBase 是一个开源的非关系(NoSQL)的可伸缩性分布式数据库.它是面向列的,并适合于存储超大型松散数据.HBase适合于实时,随机对Big数据进行读写操作的业务环境. @hbase单机环境的搭建 ...
- hive集群安装配置
hive 是JAVA写的的一个数据仓库,依赖hadoop.没有安装hadoop的,请参考http://blog.csdn.net/lovemelovemycode/article/details/91 ...
- 集群安装配置Hadoop具体图解
集群安装配置Hadoop 集群节点:node4.node5.node6.node7.node8. 详细架构: node4 Namenode,secondnamenode,jobtracker node ...
- spark集群安装配置
spark集群安装配置 一. Spark简介 Spark是一个通用的并行计算框架,由UCBerkeley的AMP实验室开发.Spark基于map reduce 算法模式实现的分布式计算,拥有Hadoo ...
- 原创:centos7.1下 ZooKeeper 集群安装配置+Python实战范例
centos7.1下 ZooKeeper 集群安装配置+Python实战范例 下载:http://apache.fayea.com/zookeeper/zookeeper-3.4.9/zookeepe ...
- hbase和ZooKeeper集群安装配置
一:ZooKeeper集群安装配置 1:解压zookeeper-3.3.2.tar.gz并重命名为zookeeper. 2:进入~/zookeeper/conf目录: 拷贝zoo_sample.cfg ...
- RabbitMQ集群安装配置+HAproxy+Keepalived高可用
RabbitMQ集群安装配置+HAproxy+Keepalived高可用 转自:https://www.linuxidc.com/Linux/2016-10/136492.htm rabbitmq 集 ...
随机推荐
- awk 相关的复习
1. awk 引用外部变量: aa=666 echo "." | awk -v GET_A=$aa '{print GET_A}' . sort -n fuxi.awk |awk ...
- linux 用户配制文件 用户增加及删除 以及用户属于的更改
1.用户密码文件 /etc/passwd root : x : 0 : 0 : root : /root : / ...
- (12)模板语言-with
with的用处 当一个变量特别特别长,可以用with给这个变量重命名 views.py from django.shortcuts import render,HttpResponse def ind ...
- sudo安装软件的时候出现Could not get lock /var/lib/dpkg/lock - open (11: Resource temporarily unavailable)
最近在安装软件的时候经常出现下面提示: E: Could not get lock /var/lib/dpkg/lock - open (11: Resource temporarily unavai ...
- 《DSP using MATLAB》Problem 6.5
代码: %% ++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++ %% Output In ...
- NDK: GCC 4.6 crashes
used version: NDK r9b, arm-linux-androideabi-4.6 GCC, with "-O2 -finline-limit=24". got t ...
- 如何安装psutil以及提示缺少python.h头文件
下载psutil 下载地址https://pypi.python.org/packages/57/93/47a2e3befaf194ccc3d05ffbcba2cdcdd22a231100ef7e4c ...
- MySQL 5.7--多源复制(非GTID模式)
==================================================== 在MYSQL5.7版本中引入多源复制,一个从库允许复制多个主库的数据,每个主库被配置为一个单独 ...
- Singer 学习十三 发现模式
发现模式 发现模式提供了一种描述tap 支持数据流的方式,使用了json schema 做为描述数据的结构以及每个数据流的 类型,发现模式的实现依赖tap 的数据源,有些taps 将硬编码每个流的模式 ...
- 一个License的所带来问题
在维护一个老产品时发现一个License的问题.产品是用Z80 Z8F6423, compiler用的是ZDS II Z8 Encode! 4.9.0. 由于有一个Bug要修复,所以我重新检查了一下它 ...