
【Python开发】【神经网络与深度学习】如何利用Python写简单网络爬虫
平时没事喜欢看看freebuf的文章,今天在看文章的时候,无线网总是时断时续,于是自己心血来潮就动手写了这个网络爬虫,将页面保存下来方便查看
先分析网站内容,红色部分即是网站文章内容div,可以看到,每一页有15篇文章

随便打开一个div来看,可以看到,蓝色部分除了一个文章标题以外没有什么有用的信息,而注意红色部分我勾画出的地方,可以知道,它是指向文章的地址的超链接,那么爬虫只要捕捉到这个地址就可以了。

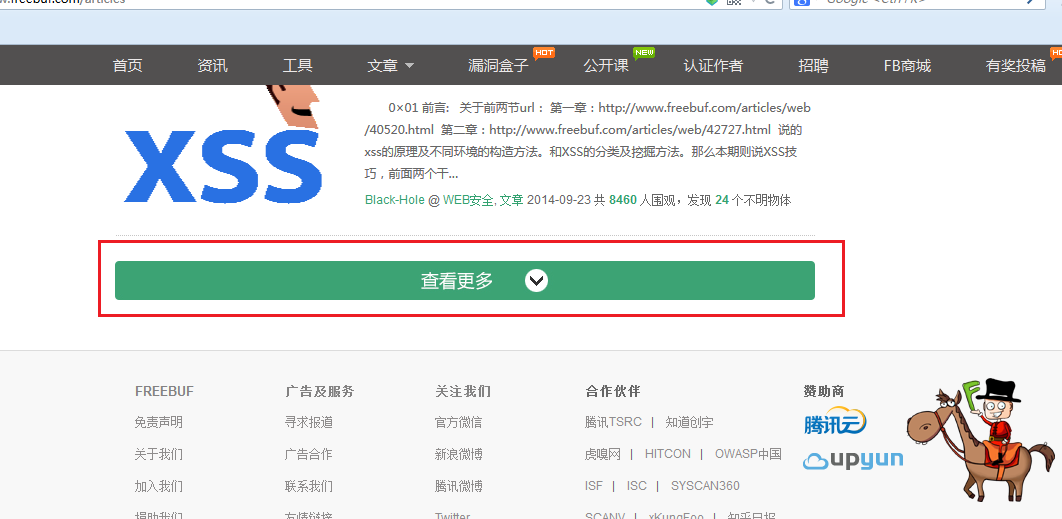
接下来在一个问题就是翻页问题,可以看到,这和大多数网站不同,底部没有页数标签,而是查看更多,这里让我当时突然有点无从下手。
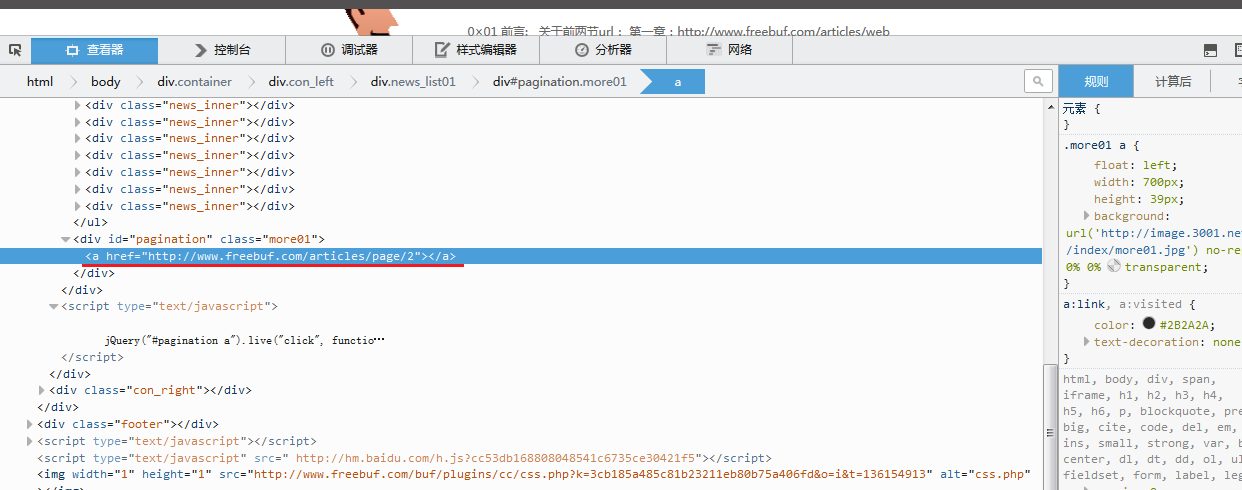
不过在查看源文件时我发现了如下图所示的一个超链接,经测试它指向下一页,那么通过改变其最后的数值,就可以定位到相应的页数上。
那么由以上信息,就可以对爬虫的步骤有一个相应的解决方案
1.抓取每一页上的所有文章的位置
2.捕捉每一页文章的URL
3.处理捕捉到的URL
那么问题又来了,我该如何定位每一篇文章在其源代码中的位置呢?
以第一篇文章为例,在源代码中查询”<dt><a href=”这个字符串,为什么要查询这个字符串呢?因为每一篇文章的url都以它开头,那么我只要找到这个字符串就定位了每一篇文章的开始位置,定位到文章的开始位置后,还必须定位文章的结束位置,才能提取出中间的url,如下图所示

代码:
import urllib

import string

#定义要抓取的页面

url = 'http://www.freebuf.com/articles'

#读取要抓取的页面

globalcontent = urllib.urlopen(url).read()

#捕捉文章列表

#这里在源码中查询"<dt><a href="这个字符串

new_inner01_h = globalcontent.find('<dt>a href=')

print news_inner01_h
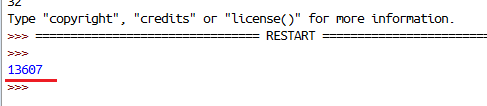
运行结果:可以看到,查到第一篇文章的字符串位置在整个源代码中的第13607个字符,接下来继续查找该文章的url尾部
代码:
import urllib

import string

#定义要抓取的页面

url = 'http://www.freebuf.com/articles'

#读取要抓取的页面

globalcontent = urllib.urlopen(url).read()

#捕捉文章列表

#这里在源码中查询"<dt><a href="这个字符串

new_inner01_h = globalcontent.find('<dt>a href=')

print news_inner01_h

#这里在源码中查询".html"这个字符串

new_inner01_l = globalcontent.find('.html')

print news_inner01_l
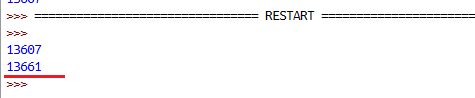
运行结果:可以看到,url的结尾位置在第13661个字符上,那么接下来就可以把我想要的真实的文章url地址提取出来
代码:
import urllib

import string

#定义要抓取的页面

url = 'http://www.freebuf.com/articles'

#读取要抓取的页面

globalcontent = urllib.urlopen(url).read()

#捕捉文章列表

#这里在源码中查询"<dt><a href="这个字符串

new_inner01_h = globalcontent.find('<dt>a href=')

print news_inner01_h

#这里在源码中查询".html"这个字符串

new_inner01_l = globalcontent.find('.html')

print news_inner01_l

#这里对文档流进行分片,从查找到的第一篇文章的头部开始,到尾部结束给提取出来

#注意,头部我进行加13,尾部加5,那是因为查找到的指针处于该字符串的开始,如果不做处理那么结果就不是我想要的数据,所以要把指针向前移动

news_inner01 = globalcontent[news_inner01_h+13:news_inner01_l+5]

print news_inner01
运行结果:
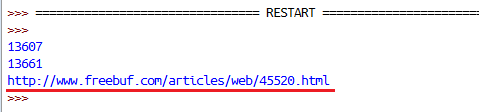
如下图所示,到这里成功提取出了第一篇文章的url地址,那么后面的事情就好办了,我只需要循环对文档流进行如上操作,得出每一篇文章的地址即可,最后对每一篇文章做处理就行了
以下代码之所以进行异常捕捉,是我发现如果不对异常进行处理,那么,url返回值会多一个空白行,导致不能对抓取到的文章进行处理,所以这里进行异常捕捉,忽略捕捉到的异常
至 此,一个最基本功能的网络爬虫就实现了,当然还可以自己加更多功能,我这里因为我只是写来玩玩,毕竟很晚了,太困了,实在不想写了,想睡觉了,所以就写这 么多了,这里只是一个思路而已,还可以添加很多功能,我这里没有用到面向对象的知识,如果利用面向对象的知识,那么这个爬虫还可以更完善。
import urllib

import string

url = 'http://www.freebuf.com/articles'

globalcontent = urllib.urlopen(url).read()

news_start = globlacontent

cout = 1

while count <= 16:

    try:

        news_inner_head = news_start.find('<dt><a href=')

        news_inner_tail = news_start.find('.html')

        news_inner_url = new_start[news_inner_head+13:news_inner_tail+5]

        print news_inner_url

        news_start = news_start[news_inner_tail+5:]


        filename = news_inner_url[-10:]

        urllib.urlretrieve(news_inner_url,filename)

        count += 1

    except:

        print 'Download Success!'

    finally:

        if count == 16:

            break
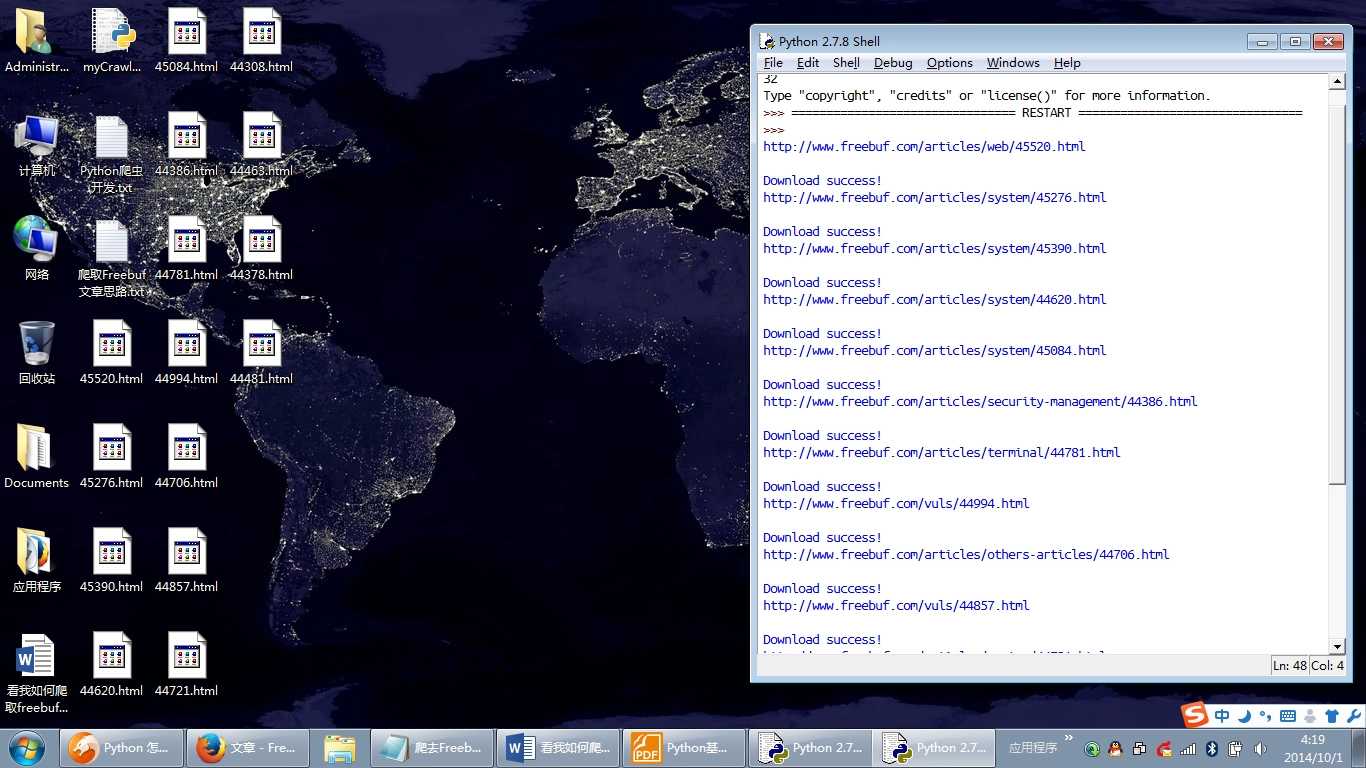
好了,不多说 了,上两张效果图,睡觉了!

【Python开发】【神经网络与深度学习】如何利用Python写简单网络爬虫的更多相关文章
- 【神经网络与深度学习】【python开发】caffe-windows使能python接口使用draw_net.py绘制网络结构图过程
[神经网络与深度学习][python开发]caffe-windows使能python接口使用draw_net.py绘制网络结构图过程 标签:[神经网络与深度学习] [python开发] 主要是想用py ...
- 【神经网络与深度学习】【Python开发】Caffe配置 windows下怎么安装protobuf for python
首先从google上下载protobuf-2.5.0.zip和protoc-2.5.0-win32.zip,然后把protoc-2.5.0-win32.zip里的protoc.exe放到protobu ...
- 【神经网络与深度学习】【Matlab开发】caffe-windows使能Matlab2015b接口
[神经网络与深度学习][Matlab开发]caffe-windows使能Matlab2015b接口 标签:[神经网络与深度学习] [Matlab开发] 主要是想全部来一次,所以使能了Matlab的接口 ...
- MINIST深度学习识别:python全连接神经网络和pytorch LeNet CNN网络训练实现及比较(三)
版权声明:本文为博主原创文章,欢迎转载,并请注明出处.联系方式:460356155@qq.com 在前两篇文章MINIST深度学习识别:python全连接神经网络和pytorch LeNet CNN网 ...
- 【神经网络与深度学习】【CUDA开发】caffe-windows win32下的编译尝试
[神经网络与深度学习][CUDA开发]caffe-windows win32下的编译尝试 标签:[神经网络与深度学习] [CUDA开发] 主要是在开发Qt的应用程序时,需要的是有一个使用的库文件也只是 ...
- 【神经网络与深度学习】【Qt开发】【VS开发】从caffe-windows-visual studio2013到Qt5.7使用caffemodel进行分类的移植过程
[神经网络与深度学习][CUDA开发][VS开发]Caffe+VS2013+CUDA7.5+cuDNN配置成功后的第一次训练过程记录<二> 标签:[神经网络与深度学习] [CUDA开发] ...
- 【神经网络与深度学习】【CUDA开发】【VS开发】Caffe+VS2013+CUDA7.5+cuDNN配置过程说明
[神经网络与深度学习][CUDA开发][VS开发]Caffe+VS2013+CUDA7.5+cuDNN配置过程说明 标签:[Qt开发] 说明:这个工具在Windows上的配置真的是让我纠结万分,大部分 ...
- Python机器学习库和深度学习库总结
我们在Github上的贡献者和提交者之中检查了用Python语言进行机器学习的开源项目,并挑选出最受欢迎和最活跃的项目. 1. Scikit-learn(重点推荐) www.github.com/sc ...
- 【神经网络与深度学习】chainer边运行边定义的方法使构建深度学习网络变的灵活简单
Chainer是一个专门为高效研究和开发深度学习算法而设计的开源框架. 这篇博文会通过一些例子简要地介绍一下Chainer,同时把它与其他一些框架做比较,比如Caffe.Theano.Torch和Te ...
随机推荐
- k8s资源需求及资源限制
在k8s上,可由容器或pod请求或消费的计算资源时指cpu和内存,这也是目前仅有的受支持的两种类型.相比较来说,cpu属于可压缩资源,即资源额度可按需收缩,而内存则是不可压缩型资源,对其执行收缩操作可 ...
- C#中引用参数ref和输出参数out
引用参数 用于按引用传递自变量. 为引用参数传递的自变量必须是具有明确值的变量,并且在方法执行期间,引用参数指明的存储位置与自变量相同. 引用参数使用 ref 修饰符进行声明. 输出参数 用于按引用传 ...
- python深浅copy
预备知识一——python的变量及其存储 在详细的了解python中赋值.copy和deepcopy之前,了解一下python内存中变量的存储情况. 在高级语言中,变量是对内存及其地址的抽象.对于py ...
- 树莓派GPIO接口
一.GPIO模式 GPIO分为板上模式和BCM模式 板上模式即为平时百度谷歌搜到的图,按顺序1-40排列(1B是26引脚) BCM模式为CPU分的,在图上一般会单独标记 二.引脚分类 1.电源:3.3 ...
- 【Winform-ComboBox】实现ComboBox下拉框与数据库的绑定
实现效果如下: 1.设计窗体 下拉框的名称cmbName 2.连接数据库 DBHelper类代码: class DBHelper { /// <summary> /// 创建静态连接字符串 ...
- Mybaist 注解 foreach 嵌套循环实现批量插入
第一种写法(#使用占位符推荐): @Insert("<script>" + " insert into ${tb} " +" <fo ...
- 【leetcode】Maximum Product of Word Lengths
Given a string array words, find the maximum value of length(word[i]) * length(word[j]) where the tw ...
- win10 exe如何添加或禁用开机自启动项
一.添加开机自启动 1,先打开存放自启动软件文件的文件夹 方法①:在文件搜索框中输入或粘贴以下地址: C:\ProgramData\Microsoft\Windows\Start Menu\Progr ...
- JavaScript疑难杂症系列-事件
事件这块知识点虽然是老生长谈的,但对于我来说多多整理,多多感悟,温故知新,每次看看这块都有不同的收获.(在这里我不会长篇大论,只会挑重点;具体的小伙伴们自行查找) 什么是事件 在编程时系统内发生的动作 ...
- java基本数据类型全面总结
Java数据类型(type)可以分为两大类:基本类型(primitive types)和引用类型(reference types).下面是Java团长给大家整理的java基本数据类型相关知识,感兴趣的 ...