
Python基础之字符编码
前言
字符编码非常容易出问题,我们要牢记几句话:
1.用什么编码保存的,就要用什么编码打开
2.程序的执行,是先将文件读入内存中
3.unicode是父编码,只能encode解码成其他编码格式
utf-8,GBK这些是子8编码,只能decode编码成Unicode
一、什么是字符编码
我们知道,计算机只能识别二进制,我们平时写的代码都需要转成二进制才能被计算机识别。所以,我们写的字符怎么转换成二进制呢,这个过程实际就是通过一个标准使我们写的字符与特定数字一一对应,这个标准就称为字符编码。
字符------(字符编码)------->数字
二、字符编码发展历程
1.ASCII码
计算机起源于美国,字符编码也起源于美国。但是美国人民使用的文字只有26个字母,再加上些特殊符号就搞定了。不像我们中国,小学生就要认识几千个汉字。所以美国人民就使用了ASCII码(美国信息交换标准码)作为字符编码,一个Bytes代表一个字符,1Bytes=8bit,可以有2的8次方即256中不同的变化,但最初只用了前7位,即127个字符,已经足够美国人民使用了(当然也出于成本的考虑)。后来将拉丁文编入第8位,至此,ASCII码就被占满了,英语国家和拉丁国家可以愉快的玩耍了。
2.GBK
别看咱们中国暂时科技比不上美帝国,但是咱们有一颗积极向上的心啊,于是,在1980年,国家标准总局发布了中文使用的字符编码-->GBK,使用两个字节表示一个汉字,这样就有2的16次方即65536种组合,已经足够汉字使用了。
同时,其他国家也分别发布了自己国家的字符编码标准,如日本的shift_JIS,韩国的Euc-kr等等
3.Unicode
据说,字符编码鼎盛时期有数百种,且彼此间互相不支持,看来各国人民都很有骨气,但是这太不利于世界的互通了,于是Unicode应运而生。1994年,国际标准化组织发布了号称万国码的Unicode,用两个字节表示一个字符,有65536种组合,已经能把全世界绝大多数语言包括了。
4.utf-8
Unicode虽然好,但有一个问题,本来用一个字节就能表示的英文,现在要用两个字节,存储空间平白多出一倍,这显然是不完美的,所以又产生了utf-8,对英文字符只用1个字节,对中文字符用3个字节来表示。
5. Unicode所有字符都是两个字节,简单粗暴,字符转换成数字的速度快,但是占用存储空间大
utf-8对不同的字符采用不用的长度表示,节省空间,但是转换效率不如Unicode快
内存中使用的字符编码是Unicode,内存就是为了加快速度的,所以宁肯牺牲一点空间,也要保证速度
硬盘和网络传输是用utf-8的,因为磁盘I/O或者网络I/O延迟要远大于utf-8的转换效率,并且在网络传输中应该尽可能节省带宽
三、Python解释器执行
第一阶段:python解释器启动,此时就相当于启动了一个文本编辑器
第二阶段:python解释器作为文本编辑器,去打开t.py文件,从硬盘上将t.py的文件内容读入到内存中
第三阶段:python解释器解释执行刚刚加载到内存中t.py的代码
其中第二阶段,t.py文件在保存时有一个字符编码,在Python解释器打开文件时也要指定一样的编码方式(Python2默认的编码方式是ASCII,Python3默认是utf-8),如果文件保存的编码格式和Python解释器默认的编码方式不一样,就要在文件的开头写上#coding: ,来告诉python解释器不要用自己默认的编码方式来读,而是要用头文件指定的方式来读文件,这样才不会出错。
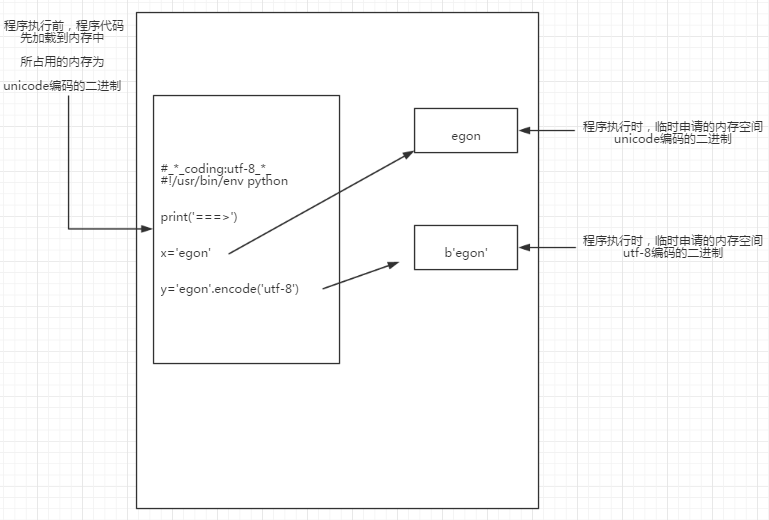
第三阶段:读取已经加载到内存中的代码(默认是Unicode),然后执行,执行过程中如果碰到类似定义变量的操作,就会在内存中开辟一块新的内存空间。此时注意,新开辟的内存空间不一定也是Unicode,用户可以在定义变量的时候指定编码方式,定义时开辟的内存空间,也只是一块空间而已,可以存放任意编码格式的代码。以Python3为例
四、编码解码
保存文件是把内存中的文件保存到硬盘上
读文件是把硬盘中的文件读到内存
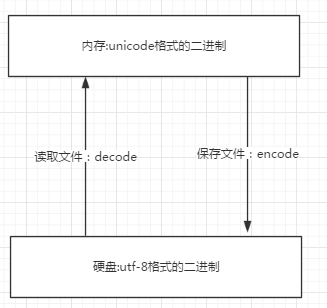
Unicode是父编码,utf-8,GBK这些是子编码,如果子码想转换成其他编码,必须要先转换成父编码,再由父编码转换成其他子编码
解码就是decode,是由子码转成父码Unicode的过程
编码就是encode,是由Unicode转换成其他编码的过程
之前说过,文件读入内存中,就成了Unicode编码(当然这是默认情况,也可以根据指令更改),从硬盘读文件的过程就是把硬盘中的utf-8解码成Unicode
文件保存时,就是由内存保存到硬盘的过程,硬盘中是utf-8的编码方式,需要由Unicode编码成utf-8
五、Python2和Python3的区别
1.Python2的默认编码方式是ASCII,打开utf-8保存的文件时会报错,应该在头文件上加#coding : utf-8
Python2中的str被识别为Bytes,所以Python2中的str是被编码后的结果,其实会默认做一件事,就是在str前面加一个u,先转换成Unicode,在encode成bytes
Python2中有两种字符串类型,str和Unicode,str可以通过在前面加个‘u’来转换成Unicode
2.python 3 的默认编码方式是utf-8,可以直接打开用utf-8保存的文件
Python3中的str被识别成Unicode
Python3中也有两种字符串类型(bytes和str),但bytes就是bytes,str是unicode
六、打印到终端
首先要知道,Windows的终端的默认编码方式是GBK
终端也是应用程序,是运行在内存中的,所以我们用print()打印的过程,是从内存中到内存中。所以对于unicode,怎么打印都不会出错,但是Python2中除了加‘u’的字符串外,其他的字符串是Bytes,此时终端中是GBK编码,而Python2中是指定的utf-8或者默认的ascii码时,在终端中打印就会出错。
这些是我目前的理解,如果我以后意识到错误或者有表述不清的地方,再来修改。唉,字符编码是个坑啊
Python基础之字符编码的更多相关文章
- python基础_字符编码
字符编码的历史 阶段一:现代计算机起源于美国,最早诞生也是基于英文考虑的ASCII 阶段二:为了满足中文,中国人定制了GBK 阶段三:各国有各国的标准,就会不可避免地出现冲突,结果就是,在多语言混合的 ...
- python 基础之字符编码和文件处理
一.字符编码 (1)计算机基础知识 (2)python 解释器执行py文件的原理 <1>python 解释器启动 <2>python解释器相当于一个文本编辑器,打开txt.py ...
- python基础4 ----字符编码
python基础---字符编码 一.了解字符编码 1. 文本编辑器存取文件的原理(nodepad++,pycharm,word) 打开编辑器就打开了启动了一个进程,是在内存中的,所以在编辑器编写的内容 ...
- 第二篇.2、python基础之字符编码
一 了解字符编码的知识储备 一 计算机基础知识 二 文本编辑器存取文件的原理(nodepad++,pycharm,word) #1.打开编辑器就打开了启动了一个进程,是在内存中的,所以,用编辑器编写的 ...
- 第1章 Python基础之字符编码
阅读目录 一.什么是字符编码 二.字符编码分类 三.字符编码转换关系 3.1 程序运行原理 3.2 终极揭秘 3.3 补充 总结 回到顶部 一.什么是字符编码 计算机要想工作必须通电,也就是说'电'驱 ...
- (Python基础)字符编码与转码
ASCII(American Standard Code for Information Interchange,美国标准信息交换代码)是基于拉丁字母的一套电脑编码系统,主要用于显示现代英语和其他西欧 ...
- Python全栈开发之路 【第三篇】:Python基础之字符编码和文件操作
本节内容 一.三元运算 三元运算又称三目运算,是对简单的条件语句的简写,如: 简单条件语句: if 条件成立: val = 1 else: val = 2 改成三元运算: val = 1 if 条件成 ...
- 第一章:python基础语法| 字符编码| 条件语句...
1.编程语言介绍 编程就是写代码,让计算机帮你做事情.计算机底层是电路,只认识二进制0和1.机器语言&汇编语言语言进化历史:机器.汇编.高级.机器语言只接受二进制代码:汇编语言是采用英文缩写的 ...
- Python基础2 字符编码和逻辑运算符
编码 AscII码 :标准ASCII码是采用7位二进制码来编码的,最高为0,没有0000 0000,所以就是2**7-1=127个字符 , 当用1个字节(8位二进制码)来表示ASCII码时,就在最高位 ...
随机推荐
- js扩展父类方法
在网上找了很多一直没找到关于JS扩展父类的方法,让我很是郁闷啊~要是真的开发组遇到了该咋整,于是乎自己手写了一些测试代码,没想到通过了……(难道是人品太好了?)废话不多说了直接上代码看看~ <s ...
- UX2 beta 3正式发布!!
UX浏览服务是为了加速浏览网页而开发的浏览服务,它解决了WebView的一系列问题,它能够在网络差的情况下快速的浏览,比webview快一倍以上,是webview的优化代替方案.它拥有完善的缓存管理策 ...
- 【Selenium】Selenium IDE(alt+ctrl+s)
ttp://www.yiibai.com/selenium/selenium_ide_tool_features.html 学习 Selenium IDE安装 http://seleniumh ...
- [0] C# 扩展方法(Extension Method)
有时有这样的情况,有一个类,你不能修改它,但你又想对它扩展(添加一个方法),这个时候就可以用到扩展方法了.请看下面的例子: using System;using System.Collections. ...
- epoll的ET和LT模式比较 - 源码分析
eventpoll是一种文件,它实现了一种机制利用一条rdllist队列来避免阻塞地进行poll.eventpoll归根到底还是在使用poll.而ET比LT高效,并不在于是否使用了poll,更不能说是 ...
- Testlink研究小结
1.Redmine与Testlink的关联 (1)redmine中的项目对应testlink的测试项目 (2)testllink执行用例时发现的问题可以记录到redmine中 2.Testlink优点 ...
- Lucence_Curd
设置Field的类型 new StringField 不分词(id,身份证号,电话...) new StoredField 不分词(链接) new TextField 分词(文本) new Fload ...
- JavaScript 基础——使用js的三种方式,js中的变量,js中的输出语句,js中的运算符;js中的分支结构
JavaScript 1.是什么:基于浏览器 基于(面向)对象 事件驱动 脚本语言 2.作用:表单验证,减轻服务器压力 添加野面动画效果 动态更改页面内容 Ajax网络请求 () 3.组成部分:ECM ...
- node.js 发送http 请求
自己研究了一下 node.js 的 http模块 下面为想服务器发送请求的代码 ,通过学习了解http 请求的过程 ,node.js 对http请求的原始封装比较低,以前php 可以用$_GET , ...
- Array和ArrayList的区别与联系
博主今天去了一个java的实习面试,发现有好多java最基础的数据结构对于博主来说反而感到陌生,在面试官问一些常见的例如HashMap这样的数据结构,博主能回答的头头是道,但是在问到Array和Arr ...