
HDFS 上文件块的副本数设置
一、使用 setrep 命令来设置
# 设置 /javafx-src.zip 的文件块只存三份

hadoop fs -setrep  /javafx-src.zip
二、文件块在磁盘上的路径
# 设置的 hdfs 目录为
/opt/hadoop-tmp/

# hdfs 文件块的路径为

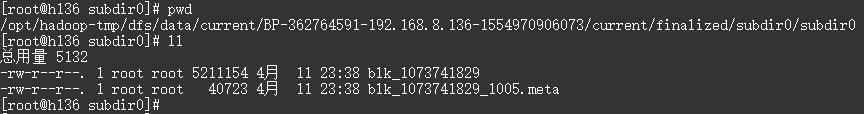
/opt/hadoop-tmp/dfs/data/current/BP-362764591-192.168.8.136-1554970906073/current/finalized/subdir0/subdir0
三、文件的分割
文件大小 < 块设定值,文件不会被切割,直接存放到 hdfs 上,占用磁盘的空间就是文件大小
文件大小 > 块设定值,文件被切割为块大小的 N 份文件,最后一份不够块大小也上面一样,只占用本身大小的磁盘空间

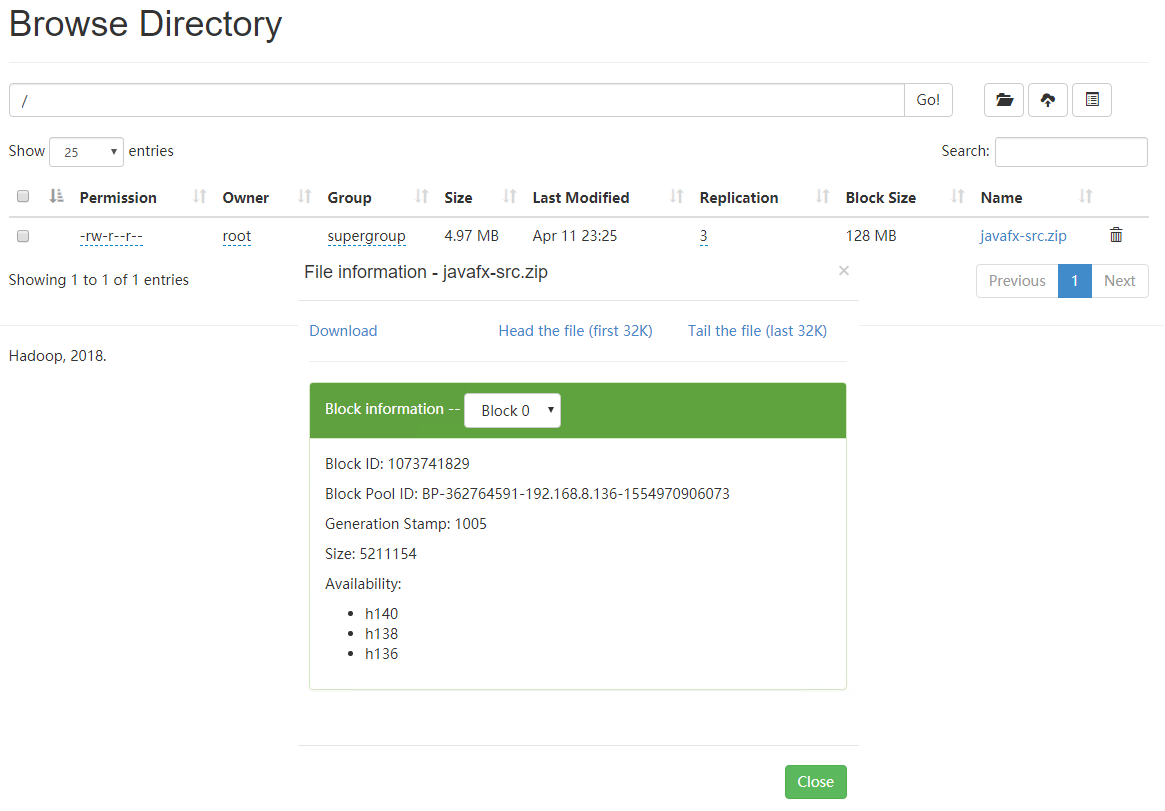
下图可以看到该文件副本为 3 份,分别存放在 h140、h138 和 h136 三台机器上
四、改变副本数后的文件的变化
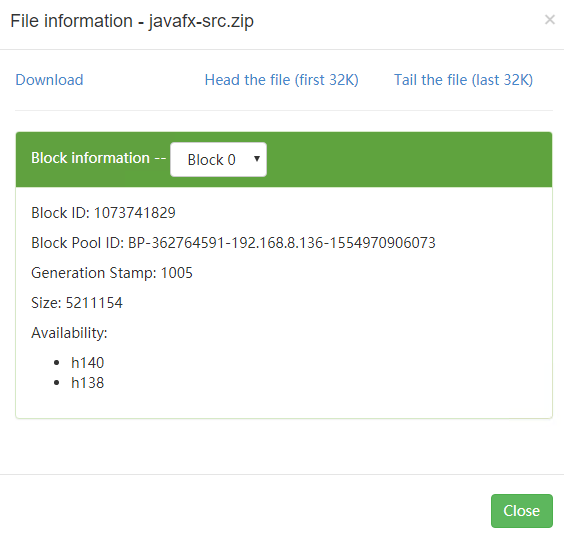
# 减少,会随机删除一个机器上的文件块,这里是删除了 h136 上的

hadoop fs -setrep 2 /javafx-src.zip
# 增加,由于只配置了三台机器无法截图

# 分两种情况:

# 机器数量 >= 副本数,会把所有文件块复制到新节点

# 机器数量 <  副本数,会等有新节点增加再执行复制操作,一直到达副本数为止

# 文件块的副本数储存在 NameNode 上

hadoop fs -setrep 5 /javafx-src.zip
http://hadoop.apache.org/docs/current/hadoop-project-dist/hadoop-hdfs/HdfsDesign.html
HDFS 上文件块的副本数设置的更多相关文章
- impala删表,而hdfs上文件却还在异常处理
Impala/hive删除表,drop后,hdfs上文件却还在处理方法: 问题原因分析,如下如可以看出一个属组是hive,一个是impala,keberas账号登录hive用户无法删除impala用户 ...
- shell脚本监控Flume输出到HDFS上文件合法性
在使用flume中发现由于网络.HDFS等其它原因,使得经过Flume收集到HDFS上得日志有一些异常,表现为: 1.有未关闭的文件:以tmp(默认)结尾的文件.加入存到HDFS上得文件应该是gz压缩 ...
- MapReduce读取hdfs上文件,建立词频的倒排索引到Hbase
Hdfs上的数据文件为T0,T1,T2(无后缀): T0: What has come into being in him was life, and the life was the light o ...
- 通过spark sql 将 hdfs上文件导入到mongodb
功能:通过spark sql 将hdfs 中文件导入到mongdo 所需jar包有:mongo-spark-connector_2.11-2.1.2.jar.mongo-java-driver-3.8 ...
- SparkHiveContext和直接Spark读取hdfs上文件然后再分析效果区别
最近用spark在集群上验证一个算法的问题,数据量大概是一天P级的,使用hiveContext查询之后再调用算法进行读取效果很慢,大概需要二十多个小时,一个查询将近半个小时,代码大概如下: try: ...
- 如何修改HDFS上文件
如果只想append操作: . echo "<Text to append>" | hdfs dfs -appendToFile - yourHdfsPath/test ...
- hadoop修改MR的提交的代码程序的副本数
hadoop修改MR的提交的代码程序的副本数 Under-Replicated Blocks的数量很多,有7万多个.hadoop fsck -blocks 检查发现有很多replica missing ...
- hdfs fsck命令查看HDFS文件对应的文件块信息(Block)和位置信息(Locations)
关键字:hdfs fsck.block.locations 在HDFS中,提供了fsck命令,用于检查HDFS上文件和目录的健康状态.获取文件的block信息和位置信息等. fsck命令必须由HDFS ...
- ES的副本数量、插入大批量数据前,副本数应该设置为0
多副本可以提升检索的能力,但是如果副本数量太多,插入数据的时候容易出现卡顿现象: 因为主分片要把数据同步给所有的副本,所以建议副本数量最好是1-2个: ---- Es在索引数据的时候,如果存在副本,那 ...
随机推荐
- 吉哥系列故事――恨7不成妻 HDU - 4507 数位dp
思路 和普通的DP不一样的是 这里求的是满足条件的数的平方的和 而数位DP只跟数每位是什么密切相关 所以要开一个结构 (多加一个 数的和sum 和平方和qsum)存一下各个状态的和的情况 dp[p ...
- nswl 收集日志
nswl 收集日志 参考链接:https://docs.citrix.com/en-us/citrix-adc/12-1/system/web-server-logging.html PS C:\Us ...
- 【cf789C】Functions again(最大子序列和)
C.Functions again 题意 给你一个数组a[1..n].有一个函数\(f(l,r)=\sum_{i=l}^{r-1}\left| a[i]-a[i+1]\right| (-1)^{l-i ...
- Markdown文本的学习
大标题 小标题 小小标题 小小小标题 萌啊萌啊萌 斜体 萌啊萌啊萌 粗体 萌啊萌啊萌 又粗又斜 萌啊萌啊萌 我是分割线 p.s. 标准Markdown换行要打两个空格 短代码 #include < ...
- Linux 遍历目录下面所有文件,将目录名、文件名转为小写
当你从 Windows 服务器换到 Linux 服务器的时候,以前的上传目录的目录名.文件名会遇到大小写的问题.在 Windows 环境下面没有文件区分大小写的概念,而 Linux 却有严格的文件名大 ...
- cf406E Hamming Triples (推公式)
考虑某两行a和b的dis 如果相同:$|a-b|$ 如果不同:$n-|a-b|$ 然后考虑三行的dis,不妨设a>=b>=c 那么有4种情况: 1.a,b,c 0/1的种类相同:$|a-b ...
- print
说一说这个print函数,我们经常使用,但有一些细节却往往错过了 print print()输出会换行是因为默认end="\n" 想要不换行,且覆盖 print("\r第 ...
- Spring cloud config 使用gitHub或者gitee连接
1. 创建SpringCloud项目,引入对应的Spring-config-server对应的jar <dependency> <groupId>org.springframe ...
- 用table绘制 等宽等间距的单元
css: .test1 { empty-cells: show;/*show:指定当表格的单元格无内容时,显示该单元格的边框.*/ border-spacing: 10px 10px;/*用长度值来定 ...
- HEOI2013 Segment
传说中的“李超树”. 大意:给你若干线段,试求横坐标x上的最上方一条线段的编号.无则输出零. 解:用线段树维护. 插入的时候保存自己这个区间上可能成为最大值的线段,被抛弃的则看情况下放. 查询时从最底 ...