
java.lang.UnsatisfiedLinkError: org.apache.hadoop.util.NativeCrc32.nativeComputeChunkedSumsByteArray(II[BI[BIILjava/lang/String;JZ)V
环境: Spark2.1.0 、Hadoop-2.7.5 代码运行系统:Win 7
在运行Spark程序写出文件(savaAsTextFile)的时候,我遇到了这个错误:
// :: ERROR Utils: Aborting task

java.lang.UnsatisfiedLinkError: org.apache.hadoop.util.NativeCrc32.nativeComputeChunkedSumsByteArray(II[BI[BIILjava/lang/String;JZ)V

    at org.apache.hadoop.util.NativeCrc32.nativeComputeChunkedSumsByteArray(Native Method)

    at org.apache.hadoop.util.NativeCrc32.calculateChunkedSumsByteArray(NativeCrc32.java:)

    at org.apache.hadoop.util.DataChecksum.calculateChunkedSums(DataChecksum.java:)

    at org.apache.hadoop.fs.FSOutputSummer.writeChecksumChunks(FSOutputSummer.java:)

    at org.apache.hadoop.fs.FSOutputSummer.flushBuffer(FSOutputSummer.java:)

    at org.apache.hadoop.fs.FSOutputSummer.flushBuffer(FSOutputSummer.java:)

    at org.apache.hadoop.fs.FSOutputSummer.write1(FSOutputSummer.java:)

    at org.apache.hadoop.fs.FSOutputSummer.write(FSOutputSummer.java:)

    at org.apache.hadoop.fs.FSDataOutputStream$PositionCache.write(FSDataOutputStream.java:)

    at java.io.DataOutputStream.write(DataOutputStream.java:)

    at org.apache.hadoop.mapred.TextOutputFormat$LineRecordWriter.writeObject(TextOutputFormat.java:)

    at org.apache.hadoop.mapred.TextOutputFormat$LineRecordWriter.write(TextOutputFormat.java:)

    at org.apache.spark.internal.io.SparkHadoopWriter.write(SparkHadoopWriter.scala:)

    at org.apache.spark.rdd.PairRDDFunctions$$anonfun$saveAsHadoopDataset$$$anonfun$$$anonfun$apply$.apply$mcV$sp(PairRDDFunctions.scala:)

    at org.apache.spark.rdd.PairRDDFunctions$$anonfun$saveAsHadoopDataset$$$anonfun$$$anonfun$apply$.apply(PairRDDFunctions.scala:)

    at org.apache.spark.rdd.PairRDDFunctions$$anonfun$saveAsHadoopDataset$$$anonfun$$$anonfun$apply$.apply(PairRDDFunctions.scala:)

    at org.apache.spark.util.Utils$.tryWithSafeFinallyAndFailureCallbacks(Utils.scala:)

    at org.apache.spark.rdd.PairRDDFunctions$$anonfun$saveAsHadoopDataset$$$anonfun$.apply(PairRDDFunctions.scala:)

    at org.apache.spark.rdd.PairRDDFunctions$$anonfun$saveAsHadoopDataset$$$anonfun$.apply(PairRDDFunctions.scala:)

    at org.apache.spark.scheduler.ResultTask.runTask(ResultTask.scala:)

    at org.apache.spark.scheduler.Task.run(Task.scala:)

    at org.apache.spark.executor.Executor$TaskRunner.run(Executor.scala:)

    at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:)

    at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:)

    at java.lang.Thread.run(Thread.java:)

// :: ERROR Executor: Exception in task 0.0 in stage 11.0 (TID )
查到的还是什么window远程访问Hadoop的错误,最后查阅官方文档HADOOP-11064
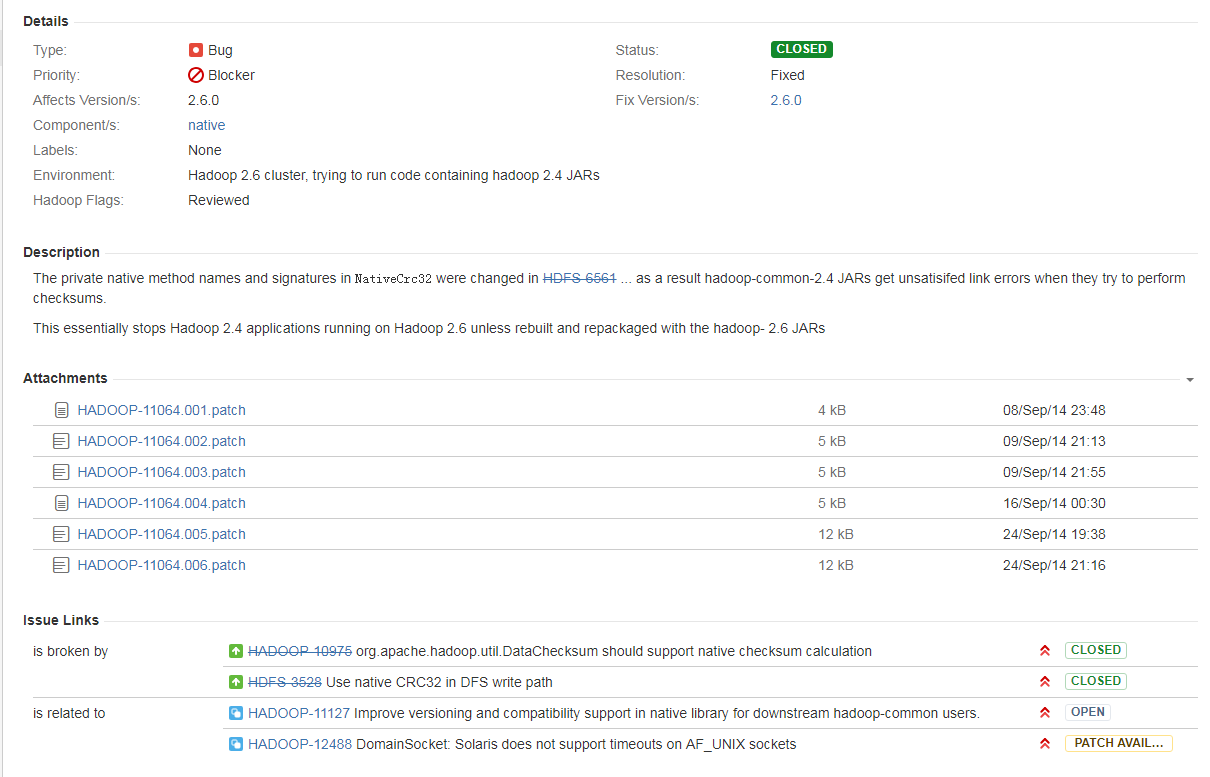
后来在网上找到解决方案是:由于hadoop.dll 版本问题出现的,这是由于hadoop.dll 版本问题,2.4之前的和之后的需要的不一样,需要选择正确的版本(包括操作系统的版本),并且在 Hadoop/bin上将其替换。
我的hadoop是2.7.5的,我之前用的是1.2的hadoop.dll,后来根据网上的说法换了hadoop.dll,找了2.6的还是不行,原来我找的2.6的是32位操作系统的,后来幸运找到了2.6的64位的hadoop.dll。
Hadoop的在windows系统中运行时需要添加win系统的支持,最开始找的版本比较老换成新的dell文件即可
java.lang.UnsatisfiedLinkError: org.apache.hadoop.util.NativeCrc32.nativeComputeChunkedSumsByteArray(II[BI[BIILjava/lang/String;JZ)V的更多相关文章
- Exceptionin thread "main" java.lang.UnsatisfiedLinkError:org.apache.hadoop.util.NativeCrc32.nativeComputeChunkedSumsByteArray(II[BI[BIILjava
这是由于hadoop.dll 版本问题,2.4之前的和自后的需要的不一样 需要选择正确的版本并且在 Hadoop/bin和 C:\windows\system32 上将其替换
- win7上代码连接hadoop出现错误 :org.apache.hadoop.util.NativeCrc32.nativeComputeChunkedSumsByteArray(II[BI[BIILjava/lang/String;JZ)V
在idea和eclipse中调试hadoop中hdfs文件,之前好好的,结果突然就出现java.lang.UnsatisfiedLinkError: org.apache.hadoop.util.Na ...
- Exceptionin thread "main" java.lang.UnsatisfiedLinkError:org.apache.hadoop.util.NativeCrc32.nativeComputeChunkedSumsByteArray(II[BI[BIILjav
在eclipse上运行hadoop报错:Exceptionin thread "main" java.lang.UnsatisfiedLinkError:org.apache.ha ...
- [bug] Window远程连接hdfs错误:java.lang.UnsatisfiedLinkError: org.apache.hadoop.util.NativeCrc32.nativeComput
原因 hadoop.dll 版本问题 解决 查询远程主机中hadoop版本,下载相同或稍高版本的hadoop.dll,将下载的 hadoop.dll 复制到windows系统的c:/window/sy ...
- java.lang.UnsatisfiedLinkError: org.apache.hadoop.io.nativeio.NativeIO$Windows.access0(Ljava/lang/String;I)Z
在 windows 上运行 MapReduce 时报如下异常 Exception in thread "main" java.lang.UnsatisfiedLinkError: ...
- Exception in thread "main" java.lang.UnsatisfiedLinkError: org.apache.hadoop.io.nativeio.NativeIO$Windows.access0(Ljava/lang/String;I)Z
1.window操作系统的eclipse运行wordcount程序出现如下所示的错误: Exception in thread "main" java.lang.Unsatisfi ...
- Exception in thread "main" java.lang.UnsatisfiedLinkError: org.apache.hadoop.io .nativeio.NativeIO$Windows.createDirectoryWithMode0(Ljava/lang/String;I)V
首先,遇到这个问题的一个原因是windows环境中没有配置hadoophome.配置之后加入winutils工具 第二个原因,pom中执行的hadoop的版本与window环境中的hadoop的版本不 ...
- MapReduce wordcount 输入路径为目录 java.lang.UnsatisfiedLinkError: org.apache.hadoop.io.nativeio.NativeIO$POSIX.stat(Ljava/lang/String;)Lorg/apache/hadoop/io/nativeio/NativeIO$POSIX$Stat;
之前windows下执行wordcount都正常,今天执行的时候指定的输入路径是文件夹,然后就报了如题的错误,把输入路径改成文件后是正常的,也就是说目前的wordcount无法对多个文件操作 报的异常 ...
- 本地spark报:java.lang.UnsatisfiedLinkError: org.apache.hadoop.io.nativeio.NativeIO$Windows.createFileWithMode0(Ljava/lang/String;JJJI)Ljava/io/FileDescriptor;
我是在运行rdd.saveAsTextFile(fileName)的时候报的错,找了很多说法……最终是跑到hadoop/bin文件夹下删除了hadoop.dll后成功.之前某些说法甚至和这个解决方法自 ...
随机推荐
- UGUI之Canvas和EventSystem
先介绍一下UGUI必不可缺的两个组件:Canvas和EventSystem 事实上在场景中第一次创建UGUI控件的时候,这两个物体都会自动添加到场景中,当然,必不可缺的不是这两个物体,而是他们身上挂载 ...
- ChemDraw中如何输入化学式分隔点
ChemDraw最实用的化学结构绘图软件,在绘制化学结构时,离不开给化学结构标记原子名称,有时还需要插入分隔点,本教程以下图给出的化学结构为例,讲解ChemDraw中如何输入化学式分隔点. 化学结构 ...
- datatables隐藏列排序
var tableOption = { id: 'cacScriptTable', order: [[2, 'desc'],[1, 'desc']],//以第三列‘updatedAt’排序,如果第三列 ...
- Effective C++ Item 19 Treat class design as type design
Too high class topic for me now ................... ................... ................... fill the ...
- php-fpm打开错误日志的配置
nginx与apache不一样,在apache中可以直接指定php的错误日志,那样在php执行中的错误信息就直接输入到php的错误日志中,可以方便查询. 在nginx中事情就变成了这样:nginx只对 ...
- SaltStack 如何自定义 grains 信息
首先在 minion 上编辑 grains 配置文件,然后添加自定义的 grains: [root@localhost ~]$ cat /etc/salt/grains # 这个文件默认是没有的 ro ...
- cocos2dx游戏--欢欢英雄传说--添加攻击按钮
接下来添加攻击按钮用于执行攻击动作.同时修复了上一版移动时的bug.修复后的Player::walkTo()函数: void Player::walkTo(Vec2 dest) { if (_seq) ...
- PHP面向对象 实例化 构造函数 封装 继承 静态
PHP面向对象 实例化 构造函数 封装 继承 静态 面向对象: 一:定义类 class Dog { var $name; var $age; var $pinzhong; function Jiao( ...
- 【markdown】使用 js 实现自己得markdown 网页编辑器
首先从这里下载其浏览器版: https://github.com/evilstreak/markdown-js/releases 解压缩后在其js文件同目录下新建一个网页进行测试,代码如下: < ...
- c++ 引用底层实现
红色是我添加的,其他地方是原作者的. 主要是看了上面的这篇“从底层汇编理解 c++ 引用实现机制“的文章之后,觉得不错.就转了过来,同时,对文中的程序都在自己的机器上验证了一下. 使用的G++版本:g ...