
北京汽车官网经销商信息抓取(解析html标签)
1、网站地址http://www.baicmotor.com/dealer.php
2、使用firefox查看后发现,此网站的信息未使用json数据,而是简单那的html页面而已
3、使用pyquery库中的PyQuery进行html的解析
页面样式:
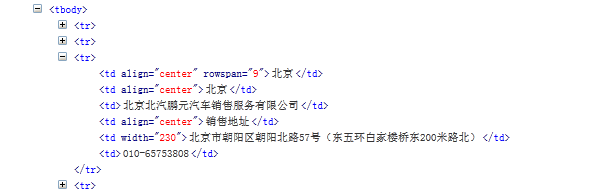
代码:
  def get_dealer_info(self):

         """获取经销商信息"""

         css_select = 'html body div.box div.news_wrapper div.main div.news_list div.service_main div table tr '

         #使用火狐浏览器中的自动复制css路径得到需要位置数据

         page = urllib2.urlopen(self.entry_url).read()

         #读取页面

         page = page.replace('<br />','&')

         page = page.replace('<br/>','&')

         #由于页面中的电话信息中使用了br换行,所以在抓取的时候会产生问题

         #问题是:如果取得一对标签中的数据,中包含<br/>,会出现值得到br之前的数据,而后的数据将得不到,原因个人认为是解析html是会任务/>结尾标准

         d = pq(page)

         #使用PyQuery解析页面,此处pq=PyQuery,因为from pyquery import PyQuery as pq

         dealer_list = []

         #创建列表用于提交到存储方法

         for dealer_div in d(css_select):

             #此处定位tr,具体数据在此标签中的td标签内

             p = dealer_div.findall('td')

             #此处p就是一个tr标签内,全部td数据的集合

             dealer = {}

             #此处的字典用于存储一个店铺的信息用于提交到列表中

             if len(p)==1:

                 #此处多哥if判断是用于对数据进行处理,因为一些格式不符合最终数据的要求,需要剔除,这个快的代码按需求而定

                 print '@'

             elif len(p)==6 :

                 strp = p[0].text.strip()

                 dealer[Constant.CITY] = p[1].text.strip()

                 strc = p[2].text.strip()

                 dealer[Constant.PROVINCE] = p[0].text.strip()

                 dealer[Constant.CITY] = p[1].text.strip()

                 dealer[Constant.NAME] = p[2].text.strip()

                 dealer[Constant.ADDRESSTYPE] = p[3].text.strip()

                 dealer[Constant.ADDRESS] = p[4].text.strip()

                 dealer[Constant.TELPHONE] = p[5].text.strip()

                 dealer_list.append(dealer)

             elif len(p)==5:

                 if p[0].text.strip() != u'省份':

                     dealer[Constant.PROVINCE] = strp

                     dealer[Constant.CITY] = p[0].text.strip()

                     dealer[Constant.NAME] = p[1].text.strip()

                     dealer[Constant.ADDRESSTYPE] = p[2].text.strip()

                     dealer[Constant.ADDRESS] = p[3].text.strip()

                     dealer[Constant.TELPHONE] = p[4].text.strip()

                     dealer_list.append(dealer)

             elif len(p)==3:

                 print '@@'

         print '@@@'

         self.saver.add(dealer_list)

         self.saver.commit()
4、最终代码执行成功,得到了相应数据并存入excel中
北京汽车官网经销商信息抓取(解析html标签)的更多相关文章
- 网易新闻页面信息抓取(htmlagilitypack搭配scrapysharp)
转自原文 网易新闻页面信息抓取(htmlagilitypack搭配scrapysharp) 最近在弄网页爬虫这方面的,上网看到关于htmlagilitypack搭配scrapysharp的文章,于是决 ...
- Atitit.web的自动化操作与信息抓取 attilax总结
Atitit.web的自动化操作与信息抓取 attilax总结 1. Web操作自动化工具,可以简单的划分为2大派系: 1.录制回放 2.手工编写0 U' z; D! s2 d/ Q! ^1 2. 常 ...
- 网页信息抓取进阶 支持Js生成数据 Jsoup的不足之处
转载请标明出处:http://blog.csdn.net/lmj623565791/article/details/23866427 今天又遇到一个网页数据抓取的任务,给大家分享下. 说道网页信息抓取 ...
- Ajax异步信息抓取方式
淘女郎模特信息抓取教程 源码地址: cnsimo/mmtao 网址:https://0x9.me/xrh6z 判断一个页面是不是Ajax加载的方法: 查看网页源代码,查找网页中加载的数据信息,如果 ...
- 网页信息抓取 Jsoup的不足之处 httpunit
今天又遇到一个网页数据抓取的任务,给大家分享下. 说道网页信息抓取,相信Jsoup基本是首选的工具,完全的类JQuery操作,让人感觉很舒服.但是,今天我们就要说一说Jsoup的不足. 1.首先我们新 ...
- 接口测试——fiddler对soapui请求返回信息抓取
原文:接口测试——fiddler对soapui请求返回信息抓取 背景:接口测试的时候,需要对接口的请求和返回信息进行查阅或者修改请求信息,可利用fiddler抓包工具对soapui的请求数据进行抓取或 ...
- Python 东方财富网-股市行情数据抓取
东方财富网 股市行情数据抓取: http://quote.eastmoney.com/center/gridlist.html#hs_a_board 请求数据未入库处理,其中数据只存入数据文本,未做存 ...
- 使用java开源工具httpClient及jsoup抓取解析网页数据
今天做项目的时候遇到这样一个需求,需要在网页上展示今日黄历信息,数据格式如下 公历时间:2016年04月11日 星期一 农历时间:猴年三月初五 天干地支:丙申年 壬辰月 癸亥日 宜:求子 祈福 开光 ...
- 汽车之家汽车品牌Logo信息抓取 DotnetSpider实战[三]
一.正题前的唠叨 第一篇实战博客,阅读量1000+,第二篇,阅读量200+,两篇文章相差近5倍,这个差异真的令我很费劲,截止今天,我一直在思考为什么会有这么大的差距,是因为干货变少了,还是什么原因,一 ...
随机推荐
- JAVA~多线程:sleep、yield方法
sleep不考虑其它线程的优先级 yield让位给相同或更高优先级的线程 sleep yield package multiThread2; public class TestThread042Yie ...
- cocos2d-x中false,setSwallowTouches,stopPropagation的区别
研究到cocos2d-x触摸这一块了,3.0和2.0相比已经有了很大的不同,使用更加方便和容易理解了. 直接进入正题,解释下,标题中3个用法的区别 通常来说,应用程序中更多使用的是单点触摸,为了简化单 ...
- eclipse 调试时出现 Error: [Errno 10013]
法1: 端口占用错误.换个端口即可. 新端口 在 8001到15536之间的任意值. 法2: windows下查看哪个程序占用端口 netstat -ano | findstr “8080” 找到p ...
- 队列理论和队列网络模型 queueing theory and queueing network model
1队列理论 1.1队列在生活中随处可见,例如排队买票,排队打饭,排队做地铁等等.那将诸如此类的队列抽象一下,可归纳为一下5要术: 到达过程arrival process 服务时间的分布 service ...
- velocity freemarker比较
相比较 FreeMarker 而言,Velocity 更加简单.轻量级,但它的功能却没有 FreeMarker 那么强大. 对于大部分的应用来说,使用 FreeMarker 比 Velocity 更简 ...
- CLRS:build_max_heap(strorage in array)
//用满二叉树存储,从n/2处开始递归向上调整(n/2后均为叶子节点,无需调整)使得根最大 //满二叉树顺序存储,左子2i,右子2i+1: #include<stdio.h>#includ ...
- 【MySQL】删除大表的讨论【转】
转自http://tech.ddvip.com/2013-07/1373269453198566.html 微博上讨论MySQL在删除大表engine=innodb(30G+)时,如何减少MySQL ...
- 五、用户数据报传输(UDP)
1.UDP常用的发送和接收函数 int recvfrom(int sockfd,void *buf,int len,unsigned int flags,struct sockaddr *from,i ...
- ASP.NET的SEO:目录
ASP.NET的SEO:基础知识 ASP.NET的SEO:Global.asax和HttpModule中的RewritePath()方法--友好的URL ASP.NET的SEO:正则表达式 ASP.N ...
- 关于hbase的read操作的深入研究 region到storefile过程
这里面说的read既包括get,也包括scan,实际底层来看这两个操作也是一样的.我们将要讨论的是,当我们从一张表读取数据的时候hbase到底是怎么处理的.分二种情况来看,第一种就是表刚创建,所有pu ...