
kylin 连接 hortonworks 中的 hive 遇到的问题
用 hortonworks(V3.1.0.0) 部署了 ambari (V2.7.3),用 ambari 部署了 hadoop 及 hive。
1. 启动 kylin(V2.6)时,遇到如下问题:
Retrieving hadoop conf dir...

KYLIN_HOME is set to /opt/programs/kylin

(Not all processes could be identified, non-owned process info

 will not be shown, you would have to be root to see it all.)

Retrieving hive dependency...

Something wrong with Hive CLI or Beeline, please execute Hive CLI or Beeline CLI in terminal to find the root cause.
经过查找,最后一行的错误信息是在 find-hive-dependency.sh 这个脚本中的,查看此脚本,是由于 hive_env 没有值引起的,
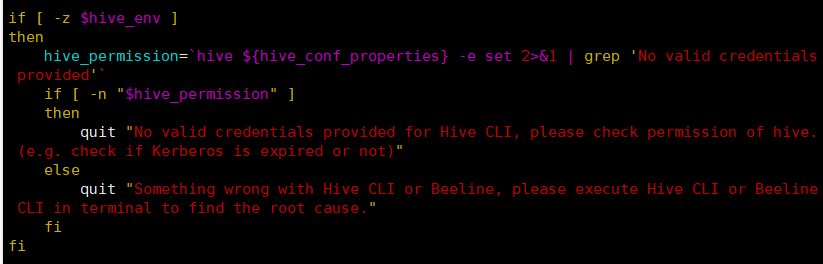
进一步分析脚本,发现是因为脚本中的下面这段脚本没有得到值
hive_env=`hive ${hive_conf_properties} -e set >& | grep 'env:CLASSPATH'`
直接在 shell 中运行上面的命令,确实没有输出。想了半天,把管道命令符前面的命令的输出,输出到一个文件。然后查找文件,发现是有 env:CLASSPATH 这一内容的。 但是为

唯一能想到的原因是:管道符命令,前面命令的输出是有大小限制的,超过多少字符后,只能把最后多少个字符传给后面的命令。
修改 find-hive-dependency.sh,把 hive_env=`hive ${hive_conf_properties} -e set 2>&1 | grep 'env:CLASSPATH'` 这一行删掉,加入下面几行后,kylin 能成功启动了。
    hive -e set >/tmp/hive_env.txt >&

    hive_env=`grep 'env:CLASSPATH' /tmp/hive_env.txt`

    hive_env=`echo ${hive_env#*env:CLASSPATH}`

    hive_env="env:CLASSPATH"${hive_env}
2. kylin 创建 module 和 cube,可是在 build cube 时发生问题。在 stackoverflow 上提了此问题,也没有正确答案。后来还是偶然间,解决了问题。具体描述见
kylin 连接 hortonworks 中的 hive 遇到的问题的更多相关文章
- Mac OSX系统中Hadoop / Hive 与 spark 的安装与配置 环境搭建 记录
Mac OSX系统中Hadoop / Hive 与 spark 的安装与配置 环境搭建 记录 Hadoop 2.6 的安装与配置(伪分布式) 下载并解压缩 配置 .bash_profile : ...
- 在hue中使用hive
一.创建新表 建表语句如下: CREATE TABLE IF NOT EXISTS user_collection_9( user_id string , seller_id string , pro ...
- 怎样在Java中运行Hive命令或HiveQL
这里所说的在Java中运行Hive命令或HiveQL并非指Hive Client通过JDBC的方式连接HiveServer(or HiveServer2)运行查询,而是简单的在部署了HiveServe ...
- Apache Kylin高级部分之使用Hive视图
本章节我们将介绍为什么须要在Kylin创建Cube过程中使用Hive视图.而假设使用Hive视图.能够带来什么优点.解决什么样的问题.以及须要学会怎样使用视图.使用视图有什么限制等等. 1. ...
- 将CDH中的hive和hbase相互整合使用
一..hbase与hive的兼容版本: hive0.90与hbase0.92是兼容的,早期的hive版本与hbase0.89/0.90兼容,不需要自己编译. hive1.x与hbase0.98.x或则 ...
- 【大数据】SparkSql 连接查询中的谓词下推处理 (一)
本文首发于 vivo互联网技术 微信公众号 https://mp.weixin.qq.com/s/YPN85WBNcnhk8xKjTPTa2g 作者:李勇 目录: 1.SparkSql 2.连接查询和 ...
- 如何在 Flink 1.9 中使用 Hive?
Apache Flink 从 1.9.0 版本开始增加了与 Hive 集成的功能,用户可以通过 Flink 来访问 Hive 的元数据,以及读写 Hive 中的表.本文将主要从项目的设计架构.最新进展 ...
- TCP连接探测中的Keepalive和心跳包
TCP连接探测中的Keepalive和心跳包 tcp keepalive 心跳 保活 Linuxtcp心跳keepalive保活1. TCP保活的必要性 1) 很多防火墙等对于空闲socket自动关闭 ...
- ora-01445:无法从不带保留关键字的表的连接视图中选择ROWID或采样
系统要创建一个物化试图,用到很多张表,执行的时候报错: ora-01445:无法从不带保留关键字的表的连接视图中选择ROWID或采样 网上搜了下,有多种原因和解决方法,最终我选择先尝试一下修改 ...
随机推荐
- -3dB的理解
-3dB到底是什么?集成运放-3dB带宽又是什么? 以无源高通电路为例,介绍-3dB的意义. 输出与输入只比: Au=Uo/Ui=R/(R+1/j*2*PI*f*C)=1/(1+1/j*2*PI*f* ...
- uboot指令和环境变量
一.uboot指令 1.printenv(pri) - 打印环境变量 2.setenv - 设置环境变量,和saveenv 配合使用 3.saveenv - 保存环境变量 4.run - 执行设置好的 ...
- 深入浅出 消息队列 ActiveMQ------增强版
本小节我们将讲解Apache开源下的ActiveMQ,而ActiveMQ是JMS的一个具体实现.JMS即Java消息服务(Java Message Service)应用程序接口是一个Java平台中关于 ...
- 从CoreAnimation到Pop
pop是Facebook在开源的一款动画引擎,看下其官方的介绍: Pop是一款在iOS.tvOS和OS X平台通用的可扩展动画引擎.它在基本静态动画的基础上,增加了弹性以及衰减动画,这在创建真实有物里 ...
- 数据库:ubantu下MySQL安装指南
http://wiki.ubuntu.org.cn/MySQL%E5%AE%89%E8%A3%85%E6%8C%87%E5%8D%97 安装MySQL sudo apt-get install mys ...
- Drools学习笔记4—Consequence/RHS
Right Hand Side,当LHS所有条件满足才会执行 可以使用LHS部分定义的绑定变量.全局变量.或者直接编写JAVA代码. 提供宏函数操作working memory fact对象,如ins ...
- DAY16-Django之model
Object Relational Mapping(ORM) ORM介绍 ORM概念 对象关系映射(Object Relational Mapping,简称ORM)模式是一种为了解决面向对象与关系数据 ...
- POJ 3714 分治/求平面最近点对
第一次见这种问题直接懵圈...没想到分治法这么强大,借鉴了lyd的代码: 代码如下 #include<cstdio> #include<algorithm> #include& ...
- C++字符串流保存数据
文件流是以外存文件为输入输出对象的数据流.字符串流是以内存中用户定义的字符数组(字符串)为输入输出对象的. 建立输出字符串流: ostrstream strout(c,sizeof(c));第一个参数 ...
- 旋转矩阵(Rotate Matrix)的性质分析
博客转载自:http://www.cnblogs.com/caster99/p/4703033.html 学过矩阵理论或者线性代数的肯定知道正交矩阵(orthogonal matrix)是一个非常好的 ...