
用go实现常用算法与数据结构——队列(queue)
queue 简介
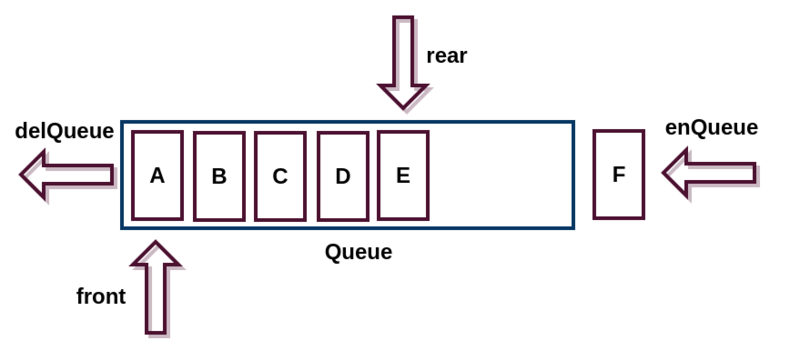
队列是一种非常常见的数据结构,日常生活中也能经常看到。一个典型的队列如下图(图片来自 segmentfault):
可以看出队列和我们日常生活中排队是基本一致的。都遵循 FIFO(First In First Out)的原则。
实现
队列可以使用链表或者数组实现,使用链表的优点是扩容简单,缺点是无法通过索引定位元素,使用数组则相反,扩容不容易但是可以通过索引定位元素。文章采用双向链表实现。代码放在github:
https://github.com/AceDarkknight/AlgorithmAndDataStructure/tree/master/queue
链表一般有下面这几个基本操作,先定义一个接口,方便开发和测试:
type Queue interface {

    // 获取当前链表长度。

	Length() int

	// 获取当前链表容量。

	Capacity() int

	// 获取当前链表头结点。

	Front() *Node

	// 获取当前链表尾结点。

	Rear() *Node

	// 入列。

	Enqueue(value interface{}) bool

	// 出列。

	Dequeue() interface{}

}
笔者的实现中,front 和 rear 节点不保存具体值,只是用来指示真正头尾节点的位置。
链表实现的队列
入列的实现如下:
// normalQueue.go

func (q *NormalQueue) Enqueue(value interface{}) bool {

	if q.length == q.capacity || value == nil {

		return false

	}

	node := &Node{

		value: value,

	}

	if q.length == 0 {

		q.front.next = node

	}

	node.previous = q.rear.previous

	node.next = q.rear

	q.rear.previous.next = node

	q.rear.previous = node

	q.length++

	return true

}
出列的实现:
// normalQueue.go

func (q *NormalQueue) Dequeue() interface{} {

	if q.length == 0 {

		return nil

	}

	result := q.front.next

	q.front.next = result.next

	result.next = nil

	result.previous = nil

	q.length--

	return result.value

}
可以看到,具体实现和链表基本一致,这种方法好处在于不需要考虑数组溢出的问题。但是有时候,我们可能会向 queue 插入相同的元素,我们当前的实现是无法判断数据是否已经存在的,这时我们就需要实现一个无重复元素的 queue。
无重复元素的队列。
我们只需要在原来的基础上加一个 Map 存放我们的具体值就可以了。直接上代码:
// uniqueQueue.go

func (q *UniqueQueue) Enqueue(value interface{}) bool {

	if q.length == q.capacity || value == nil {

		return false

	}

	node := &Node{

		value: value,

	}

	// Ignore uncomparable type.

	if kind := reflect.TypeOf(value).Kind(); kind == reflect.Map || kind == reflect.Slice || kind == reflect.Func {

		return false

	}

	if v, ok := q.nodeMap[value]; ok || v {

		return false

	}

	if q.length == 0 {

		q.front.next = node

	}

	node.previous = q.rear.previous

	node.next = q.rear

	q.rear.previous.next = node

	q.rear.previous = node

	q.nodeMap[value] = true

	q.length++

	return true

}
因为在 golang 中,map 的 key 必须是可以比较的,所以我们需要排除 Map、slice、function 这些不可比较的类型。剩下的实现和上面的就差不多了。再看出列操作:
// uniqueQueue.go

func (q *UniqueQueue) Dequeue() interface{} {

	if q.length == 0 {

		return nil

	}

	result := q.front.next

	delete(q.nodeMap, result.value)

	q.front.next = result.next

	result.next = nil

	result.previous = nil

	q.length--

	return result.value

}
上面两个队列都是基于链表实现的,下面介绍一下基于数组实现的循环队列。
循环队列
循环队列通过复用数组元素来达到“循环”的效果。简单来说就是如果数组前面有位置,就把元素放进去。具体原理可以看这里。入列代码如下:
// cyclicQueue.go

func (q *CyclicQueue) Enqueue(value interface{}) bool {

	if q.length == q.capacity || value == nil {

		return false

	}

	node := &Node{

		value: value,

	}

	index := (q.rear + 1) % cap(q.nodes)

	q.nodes[index] = node

	q.rear = index

	q.length++

	if q.length == 1 {

		q.front = index

	}

	return true

}
出列操作也类似:
// cyclicQueue.go

func (q *CyclicQueue) Dequeue() interface{} {

	if q.length == 0 {

		return nil

	}

	result := q.nodes[q.front].value

	q.nodes[q.front] = nil

	index := (q.front + 1) % cap(q.nodes)

	q.front = index

	q.length--

	return result

}
Reference
https://www.geeksforgeeks.org/queue-set-1introduction-and-array-implementation/
用go实现常用算法与数据结构——队列(queue)的更多相关文章
- python 下的数据结构与算法---2:大O符号与常用算法和数据结构的复杂度速查表
目录: 一:大O记法 二:各函数高阶比较 三:常用算法和数据结构的复杂度速查表 四:常见的logn是怎么来的 一:大O记法 算法复杂度记法有很多种,其中最常用的就是Big O notation(大O记 ...
- 大数据学习之BigData常用算法和数据结构
大数据学习之BigData常用算法和数据结构 1.Bloom Filter 由一个很长的二进制向量和一系列hash函数组成 优点:可以减少IO操作,省空间 缺点:不支持删除,有 ...
- TypeScript算法与数据结构-队列和循环队列
本文涉及的源码,均在我的github.有两部分队列和循环队列.有问题的可以提个issue,看到后第一时间回复 1. 队列(Queue) 队列也是一种线性的数据结构, 队列是一种先进先出的数据结构.类似 ...
- PHP常用算法和数据结构示例
<?php header("content-type:text/html;charset=utf-8"); $arr=array(3,5,8,4,9,6,1,7,2); ec ...
- php常用算法和数据结构
</pre><pre name="code" class="php"><?php /** * Created by PhpStor ...
- python算法与数据结构-队列(44)
一.队列的介绍 队列的定义:队列是一种特殊的线性表,只允许在表的头部(front处)进行删除操作,在表的尾部(rear处)进行插入操作的线性数据结构,这种结构就叫做队列.进行插入操作的一端称为队尾,进 ...
- Java数据结构与算法(4) - ch04队列(Queue和PriorityQ)
队列: 先进先出(FIFO). 优先级队列: 在优先级队列中,数据项按照关键字的值有序,关键字最小的数据项总在对头,数据项插入的时候会按照顺序插入到合适的位置以确保队列的顺序,从后往前将小于插入项的数 ...
- 用golang实现常用算法与数据结构——跳跃表(Skip list)
背景 最近在学习 redis,看到redis中使用 了skip list.在网上搜索了一下发现用 golang 实现的 skip list 寥寥无几,性能和并发性也不是特别好,于是决定自己造一个并发安 ...
- 数据结构 -- 队列Queue
一.队列简介 定义 队列(queue)在计算机科学中,是一种先进先出的线性表. 它只允许在表的前端进行删除操作,而在表的后端进行插入操作.进行插入操作的端称为队尾,进行删除操作的端称为队头.队列中没有 ...
随机推荐
- 通过wget工具下载指定文件中的URLs对应的资源并保存到指定的本地目录中去并进行文件完整性与可靠性校验
创建URLs文件在终端输入cd target_directory回车,便把当前文件夹切换到了目标文件夹target_directory,此后创建的文件都会丢它里面在终端输入cat > URLs回 ...
- java字符串类型常量拼接与变量拼接的区别
前言 首先看下下面代码结果是什么? package cn.demo_01; public class StringDemo02 { public static void main(String[] a ...
- Entry的验证
Entry组件是支持验证输入的合法性的, 比如要求输入数字,你输入了字母就是非法. 实现该功能,需要通过设置validate,validatecommand,invalidcommand选项. 1.首 ...
- php+MySql实现登录系统与输出浏览者信息功能
这篇文章主要介绍了php+MySql实现登录系统与输出浏览者信息功能 的相关资料,需要的朋友可以参考下 本系统,与之前在<ASP 连接Access数据库的登陆系统>(点击打开链接)一文 ...
- java集合详解
1.java集合框架的层次结构 Collection接口: Set接口: HashSet具体类 LinkedHashSet具体类 TreeSet具体类 List接口: ArrayList具体类 L ...
- RPC服务和HTTP服务
很长时间以来都没有怎么好好搞清楚RPC(即Remote Procedure Call,远程过程调用)和HTTP调用的区别,不都是写一个服务然后在客户端调用么?这里请允许我迷之一笑~Naive!本文简单 ...
- 浅谈linux静态库、动态库。
动态库又叫动态共享文件(.so,Dynamic Shared Objects)和静态库(.a)都是将一些待重用的公共代码打包成一种特殊的重定位目标文件. 在使用时,连接器会将静态库中所有的代码,编译到 ...
- [机器学习Lesson4]多元线性回归
1. 多元线性回归定义 多元线性回归也被称为多元线性回归. 我们现在介绍方程的符号,我们可以有任意数量的输入变量. 这些多个特征的假设函数的多变量形式如下: hθ(x)=θ0+θ1x1+θ2x2+θ3 ...
- css befroe after 尾类技术器
CSS counter计数器(content目录序号自动递增)详解 这篇文章发布于 2014年08月26日,星期二,15:54,归类于 css相关. 阅读 44148 次, 今日 11 次 by zh ...
- [LeetCode] Print Binary Tree 打印二叉树
Print a binary tree in an m*n 2D string array following these rules: The row number m should be equa ...