
Python爬虫_糗事百科
本爬虫任务:
爬虫糗事百科网站(https://www.qiushibaike.com/)——段子版块中所有的【段子】、【投票数】、【神回复】等内容
步骤:
- 通过翻页寻找url规律,构造url列表
- 查看审查元素,发现网页内容均在elements中,可以直接请求
- 通过xpath提取需要的内容
- 保存数据
逻辑:
- 构造外层url列表并进行遍历
- 对外层url请求访问,获得响应
- 提取内层url列表
- 遍历内层url
- 对内层url请求访问,获取响应
- 提取需要的数据(段子、投票数、神回复)
- 保存
代码:
 1 import requests

 2 from lxml import etree

 3 import json

 4

 5

 6 class QiuShiSpider:

 7     def __init__(self):

 8         self.start_url = "https://www.qiushibaike.com/text/page/{}/"

 9         self.headers = {

10             "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.k36 (KHTML, like Gecko) ""Chrome/86.0.4240.11"}

11

12     def parse_url(self, url):

13         res = requests.get(url, headers=self.headers)

14         return res.content.decode()

15

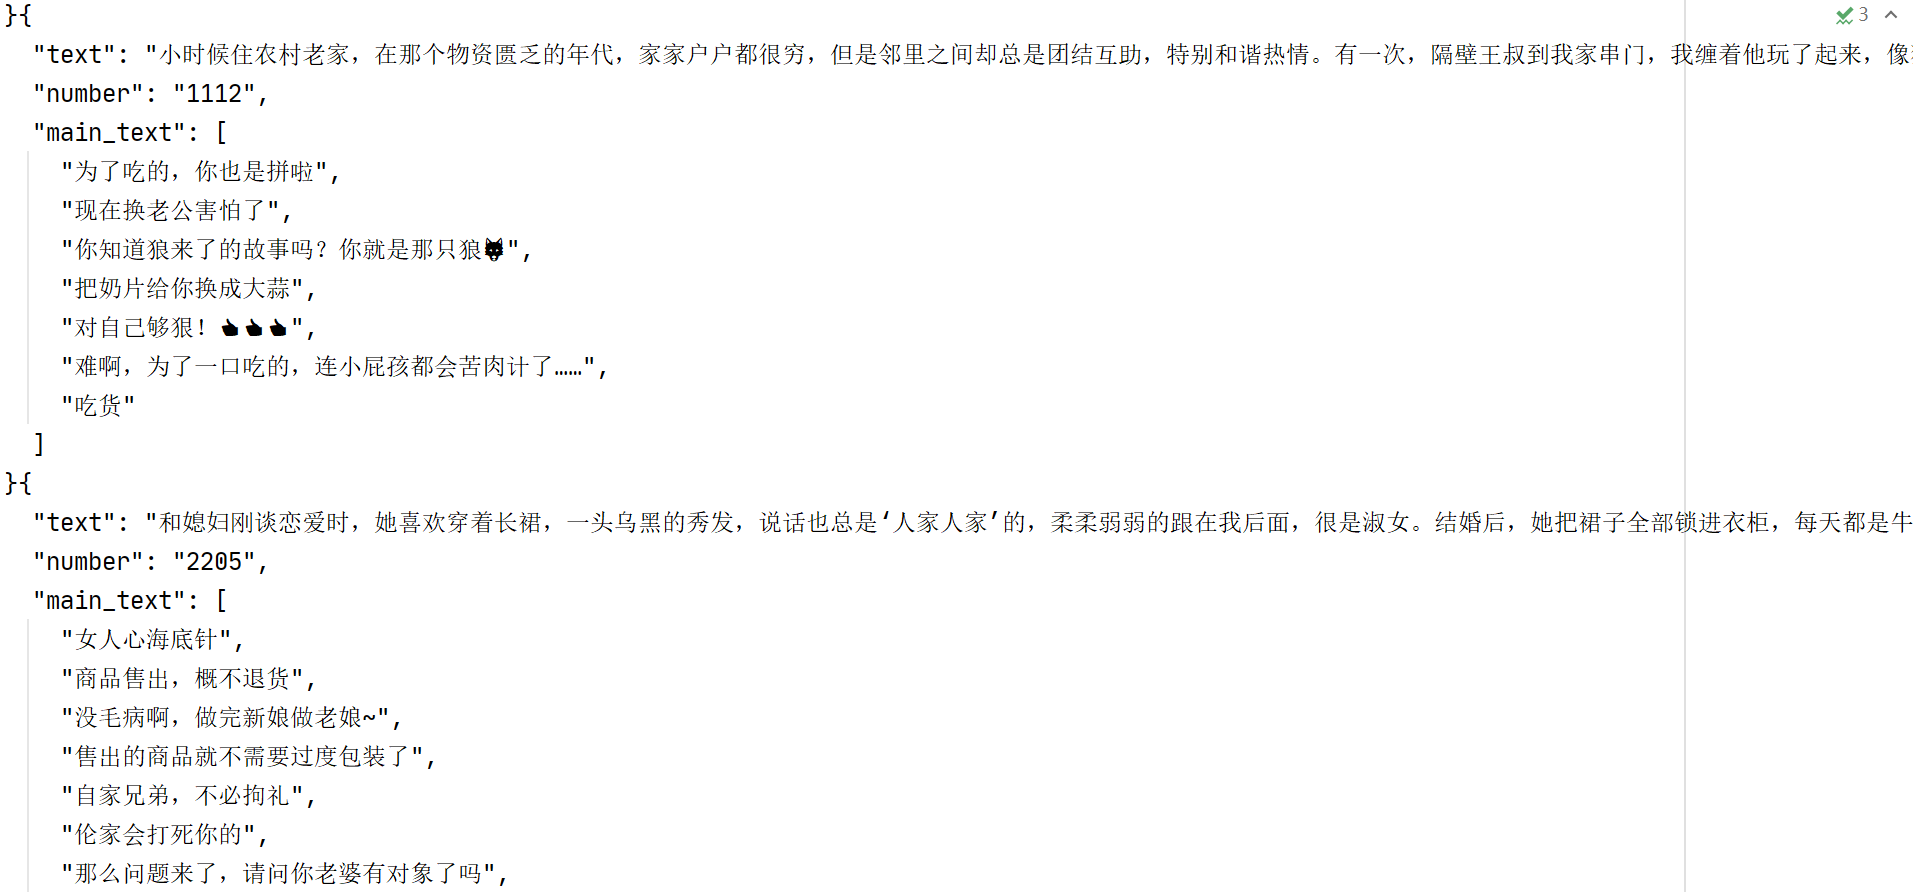
16     def get_urls_inner(self, html_str):

17         html = etree.HTML(html_str)

18         urls_inner = html.xpath("//a[@class='contentHerf']/@href")

19         full_urls_inner = ["https://www.qiushibaike.com" + i for i in urls_inner]

20         return full_urls_inner

21

22     def get_contents(self, html_str):

23         html = etree.HTML(html_str)

24         text_list = html.xpath("//div[@class='content']/text()")

25         text = "".join(text_list)

26         number = html.xpath("//span[@class='stats-vote']/i/text()")[0] if len(

27             html.xpath("//span[@class='stats-vote']/i/text()")) > 0 else None

28         main_text_list = html.xpath("//div/span[@class='body']/text()")

29         return text, number, main_text_list

30

31     def save(self, content_dic):

32         with open("qs4.txt", "a", encoding="utf-8") as f:

33             f.write(json.dumps(content_dic, ensure_ascii=False, indent=2))

34

35     def run(self):

36         # 遍历url发送请求获取响应

37         urls_outer = [self.start_url.format(n + 1) for n in range(13)]

38         for url_outer in urls_outer:

39             try:

40                 html_str = self.parse_url(url_outer)

41                 urls_inner = self.get_urls_inner(html_str)

42                 for url_inner in urls_inner:

43                     content_dic = {}

44                     html_str = self.parse_url(url_inner)

45                     text, number, main_text_list = self.get_contents(html_str)

46                     content_dic["text"] = text

47                     content_dic["number"] = number

48                     content_dic["main_text"] = main_text_list

49

50                     self.save(content_dic)

51                     print("第{}页,第{}条".format(urls_outer.index(url_outer), urls_inner.index(url_inner)))

52             except Exception as e:

53                 print(e)

54

55

56 if __name__ == "__main__":

57     qs = QiuShiSpider()

58     qs.run()
Python爬虫_糗事百科的更多相关文章
- 爬虫_糗事百科(scrapy)
糗事百科scrapy爬虫笔记 1.response是一个'scrapy.http.response.html.HtmlResponse'对象,可以执行xpath,css语法来提取数据 2.提取出来的数 ...
- Python爬虫(十七)_糗事百科案例
糗事百科实例 爬取糗事百科段子,假设页面的URL是: http://www.qiushibaike.com/8hr/page/1 要求: 使用requests获取页面信息,用XPath/re做数据提取 ...
- python scrapy实战糗事百科保存到json文件里
编写qsbk_spider.py爬虫文件 # -*- coding: utf-8 -*- import scrapy from qsbk.items import QsbkItem from scra ...
- python 爬取糗事百科 gui小程序
前言:有时候无聊看一些搞笑的段子,糗事百科还是个不错的网站,所以就想用Python来玩一下.也比较简单,就写出来分享一下.嘿嘿 环境:Python 2.7 + win7 现在开始,打开糗事百科网站,先 ...
- Python抓取糗事百科成人版图片
最近开始学习爬虫,一开始看的是静觅的爬虫系列文章,今天看到糗事百科成人版,心里就邪恶了一下,把图片都爬下来吧,哈哈~ 虽然后来实现了,但还是存在一些问题,暂且不提,先切入正题吧,没什么好说的,直接上代 ...
- Python爬取糗事百科
import urllib import urllib.request from bs4 import BeautifulSoup """ 1.抓取糗事百科所有纯 ...
- python 抓取糗事百科糗图
1 首先看下要抓取的页面 这是糗事百科里面的糗图页面,每一页里面有很多的图片,我们要做的就是把这些图片抓取下来. 2 分析网页源代码 发现源代码里面的每张图是这样储存的,所以决定使用正则匹配出图片的u ...
- python爬取糗事百科段子
初步爬取糗事百科第一页段子(发布人,发布内容,好笑数和评论数) #-*-coding:utf--*- import urllib import urllib2 import re page = url ...
- <爬虫实战>糗事百科
1.糗事百科段子.py # 目标:爬取糗事百科段子信息(文字) # 信息包括:作者头像,作者名字,作者等级,段子内容,好笑数目,评论数目 # 解析用学过的几种方法都实验一下①正则表达式.②Beauti ...
随机推荐
- K8s 二、(1、kubeadm部署Kubernetes集群)
准备工作 满足安装 Docker 项目所需的要求,比如 64 位的 Linux 操作系统.3.10 及以上的内核版本: x86 或者 ARM 架构均可: 机器之间网络互通,这是将来容器之间网络互通的前 ...
- rand()函数 不同区间 整数和浮点数
C++中rand()范围[0,RAND_MAX] 1.生成整数随机数,a b均为整数,且 [a,b)---rand()%(b-a)+a [a,b] ---rand()%(b-a+1)+a (a ...
- 「SCOI2005」互不侵犯 (状压DP)
题目链接 在\(N\times N\) 的棋盘里面放 \(K\)个国王,使他们互不攻击,共有多少种摆放方案.国王能攻击到它上下左右,以及左上左下右上右下八个方向上附近的各一个格子,共\(8\) 个格子 ...
- Codeforces Round #602 Div2 D1. Optimal Subsequences (Easy Version)
题意:给你一个数组a,询问m次,每次返回长度为k的和最大的子序列(要求字典序最小)的pos位置上的数字. 题解:和最大的子序列很简单,排个序就行,但是题目要求字典序最小,那我们在刚开始的时候先记录每个 ...
- 牛客算法周周练20 F.紫魔法师 (二分图染色)
题意:给你一张图,对其染色,使得相连的点的颜色两两不同求,最少使用多少种颜色. 题解:首先,若\(n=1\),只需要一种.然后我们再去判断是否是二分图,对于二分图,两种颜色就够了,若不是二分图,也就是 ...
- 在WLS2下开发和部署NET Core3.1目录
前言 在youtube推送上看到WSL2的消息(https://www.youtube.com/watch?v=MrZolfGm8Zk&t=1s),觉得很棒.恰好最近在学习PowerShell ...
- SpringBoot整合Swagger初探
当下的Web项目大都采用前后端分离+分布式微服务的架构.前后端分离式的开发中,前端开发人员要与后端开发人员协商通信接口,约定接口规范.因此对于开发人员来说能够维持一份及时更新且完整全面的API文档会大 ...
- DCL 数据控制语言
目录 授予权限(GRANT) 回收权限(REVOTE) 授予权限(GRANT) # 语法 mysql> help grant; Name: 'GRANT' Description: Syntax ...
- Linux-文件查看命令
目录 系统文件查看命令-cat 系统文件查看命令-more 系统文件查看命令-less 系统文件查看命令-head 系统文件查看命令-tail 系统文件查看命令-grep 文件上传下载命令-rz,sz ...
- K8S(01)二进制部署实践-1.15.5
系列文章说明 本系列文章,可以基本算是 老男孩2019年王硕的K8S周末班课程 笔记,根据视频来看本笔记最好,否则有些地方会看不明白 需要视频可以联系我 目录 系列文章说明 1 部署架构 1.1 架构 ...