
Flink on Yarn三部曲之三:提交Flink任务
欢迎访问我的GitHub
https://github.com/zq2599/blog_demos
内容:所有原创文章分类汇总及配套源码,涉及Java、Docker、Kubernetes、DevOPS等;
本文是《Flink on Yarn三部曲》系列的终篇,先简单回顾前面的内容:
- 《Flink on Yarn三部曲之一:准备工作》:准备好机器、脚本、安装包;
- 《Flink on Yarn三部曲之二:部署和设置》:完成CDH和Flink部署,并在管理页面做好相关的设置;
现在Flink、Yarn、HDFS都就绪了,接下来实践提交Flink任务到Yarn执行;
全文链接
两种Flink on YARN模式
实践之前,对Flink on YARN先简单了解一下,如下图所示,Flink on Yarn在使用的时候分为两种模式,Job Mode和Session Mode:
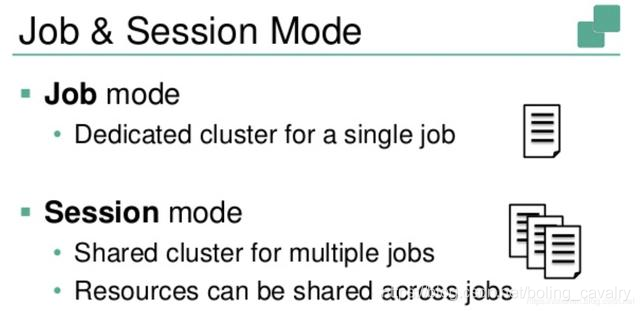
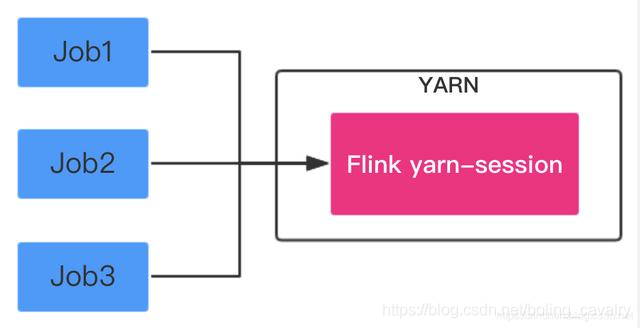
Session Mode:在YARN中提前初始化一个Flink集群,以后所有Flink任务都提交到这个集群,如下图:
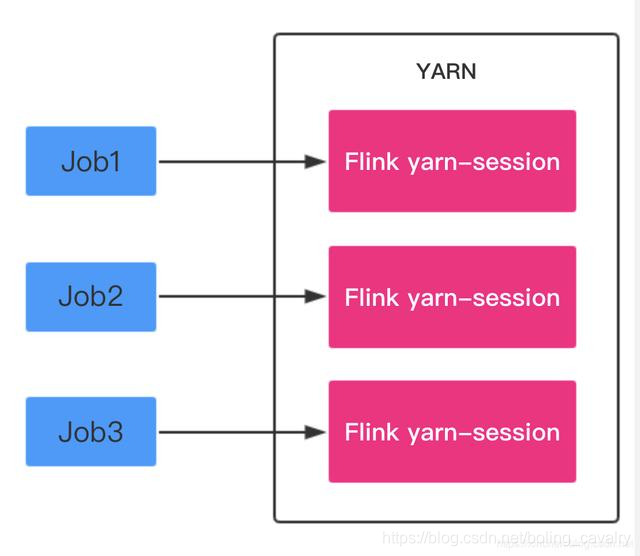
Job Mode:每次提交Flink任务都会创建一个专用的Flink集群,任务完成后资源释放,如下图:
接下来分别实战这两种模式;
准备实战用的数据(CDH服务器)
接下来提交的Flink任务是经典的WordCount,先在HDFS中准备一份文本文件,后面提交的Flink任务都会读取这个文件,统计里面每个单词的数字,准备文本的步骤如下:
- SSH登录CDH服务器;
- 切换到hdfs账号:su - hdfs
- 下载实战用的txt文件:
wget https://github.com/zq2599/blog_demos/blob/master/files/GoneWiththeWind.txt
- 创建hdfs文件夹:hdfs dfs -mkdir /input
- 将文本文件上传到/input目录:hdfs dfs -put ./GoneWiththeWind.txt /input
准备工作完成,可以提交任务试试了。
Session Mode实战
- SSH登录CDH服务器;
- 切换到hdfs账号:su - hdfs
- 进入目录:/opt/flink-1.7.2/
- 执行如下命令创建Flink集群,-n参数表示TaskManager的数量,-jm表示JobManager的内存大小,-tm表示每个TaskManager的内存大小:
./bin/yarn-session.sh -n 2 -jm 1024 -tm 1024
- 创建成功后,控制台输出如下图,注意红框中的提示,表明可以通过38301端口访问Flink:

- 浏览器访问CDH服务器的38301端口,可见Flink服务已经启动:
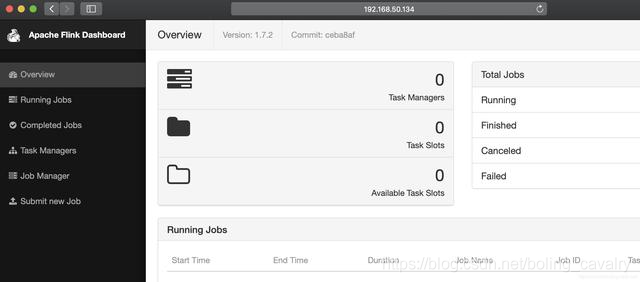
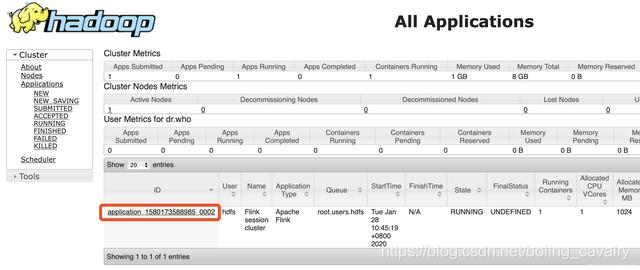
- 浏览器访问CDH服务器的8088端口,可见YARN的Application(即Flink集群)创建成功,如下图,红框中是任务ID,稍后结束Application的时候会用到此ID:
- 再开启一个终端,SSH登录CDH服务器,切换到hdfs账号,进入目录:/opt/flink-1.7.2
- 执行以下命令,就会提交一个Flink任务(安装包自带的WordCount例子),并指明将结果输出到HDFS的wordcount-result.txt文件中:
bin/flink run ./examples/batch/WordCount.jar \

-input hdfs://192.168.50.134:8020/input/GoneWiththeWind.txt \

-output hdfs://192.168.50.134:8020/wordcount-result.txt
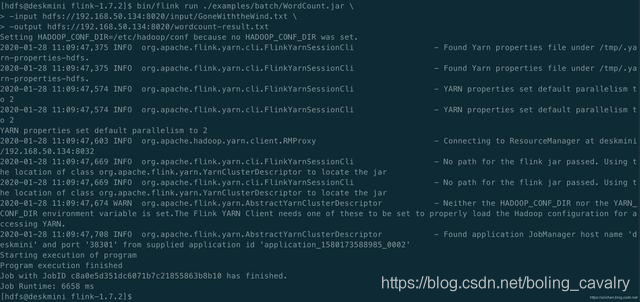
- 执行完毕后,控制台输出如下:
- flink的WordCount任务结果保存在hdfs,我们将结果取出来看看:hdfs dfs -get /wordcount-result.txt
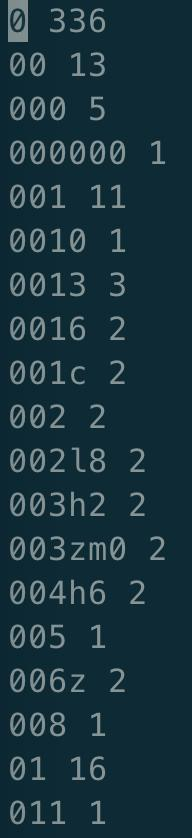
- vi打开wordcount-result.txt文件,如下图,可见任务执行成功,指定文本中的每个单词数量都统计出来了:
- 浏览器访问Flink页面(CDH服务器的38301端口),也能看到任务的详细情况:

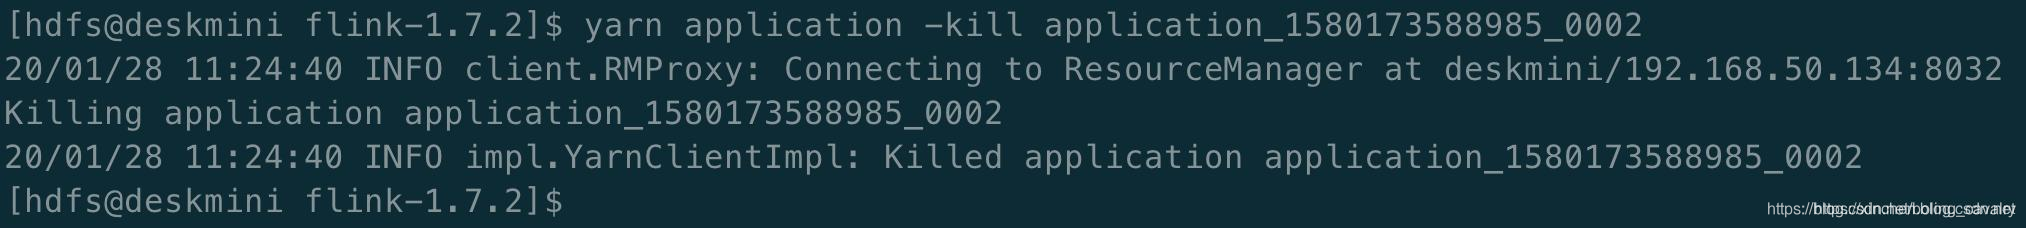
- 销毁这个Flink集群的方法是在控制台执行命令:yarn application -kill application_1580173588985_0002
Session Mode的实战就完成了,接下来我们来尝试Job Mode;
Job Mode
- 执行以下命令,创建一个Flink集群,该集群只用于执行参数中指定的任务(wordCount.jar),结果输出到hdfs的wordcount-result-1.txt文件:
bin/flink run -m yarn-cluster \

-yn 2 \

-yjm 1024 \

-ytm 1024 \

./examples/batch/WordCount.jar \

-input hdfs://192.168.50.134:8020/input/GoneWiththeWind.txt \

-output hdfs://192.168.50.134:8020/wordcount-result-1.txt
- 控制台输出如下,表明任务执行完成:

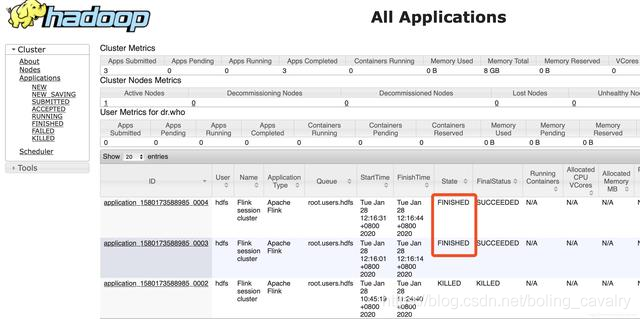
- 如果您的内存和CPU核数充裕,可以立即执行以下命令再创建一个Flink集群,该集群只用于执行参数中指定的任务(wordCount.jar),结果输出到hdfs的wordcount-result-2.txt文件:
bin/flink run -m yarn-cluster \

-yn 2 \

-yjm 1024 \

-ytm 1024 \

./examples/batch/WordCount.jar \

-input hdfs://192.168.50.134:8020/input/GoneWiththeWind.txt \

-output hdfs://192.168.50.134:8020/wordcount-result-2.txt
- 在YARN管理页面可见任务已经结束:
- 执行命令hdfs dfs -ls /查看结果文件,已经成功生成:
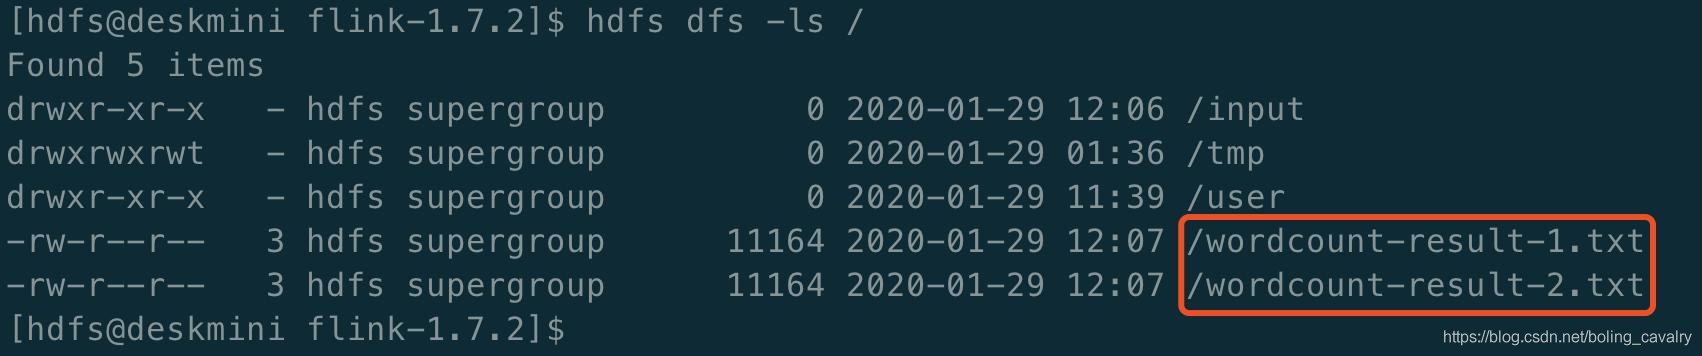
- 执行命令hdfs dfs -get /wordcount-result-1.txt下载结果文件到本地,检查数据正常;
- 至此,Flink on Yarn的部署、设置、提交都实践完成,《Flink on Yarn三部曲》系列也结束了,如果您也在学习Flink,希望本文能够给您一些参考,也建议您根据自身情况和需求,修改ansible脚本,搭建更适合自己的环境;
欢迎关注公众号:程序员欣宸
微信搜索「程序员欣宸」,我是欣宸,期待与您一同畅游Java世界...
https://github.com/zq2599/blog_demos
Flink on Yarn三部曲之三:提交Flink任务的更多相关文章
- Flink on Yarn三部曲之一:准备工作
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- Flink on Yarn三部曲之二:部署和设置
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- Flink的DataSource三部曲之三:自定义
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- Flink源码阅读(一)——Flink on Yarn的Per-job模式源码简析
一.前言 个人感觉学习Flink其实最不应该错过的博文是Flink社区的博文系列,里面的文章是不会让人失望的.强烈安利:https://ververica.cn/developers-resource ...
- Flink的DataSource三部曲之一:直接API
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- Flink的DataSource三部曲之二:内置connector
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- Apache Flink 进阶(六):Flink 作业执行深度解析
本文根据 Apache Flink 系列直播课程整理而成,由 Apache Flink Contributor.网易云音乐实时计算平台研发工程师岳猛分享.主要分享内容为 Flink Job 执行作业的 ...
- flink on yarn模式下两种提交job方式
yarn集群搭建,参见hadoop 完全分布式集群搭建 通过yarn进行资源管理,flink的任务直接提交到hadoop集群 1.hadoop集群启动,yarn需要运行起来.确保配置HADOOP_HO ...
- Flink on yarn的配置及执行
1. 写在前面 Flink被誉为第四代大数据计算引擎组件,即可以用作基于离线分布式计算,也可以应用于实时计算.Flink可以自己搭建集群模式已提供为庞大数据的计算.但在实际应用中.都是计算hdfs上的 ...
随机推荐
- JVM七大垃圾回收器上篇Serial、ParNeW、Parallel Scavenge、 Serial Old、 Parallel Old、 CMS、 G1
GC逻辑分类 垃圾收集器没有在规范中进行过多的规定,可以由不同的厂商.不同版本的JVM来实现. 由于JDK的版本处于高速迭代过程中,因此Java发展至今已经衍生了众多的GC版本. 从不同角度分析垃圾收 ...
- Fork Join 并发任务执行框架
Fork Join 体现了分而治之 什么是分而治之? 规模为N的问题,如果N<阈值,直接解决,N>阈值,将N分解为K个小规模子问题,子问题互相对立,与原问题形式相同,将子问题的解合并得到原 ...
- hystrix文档翻译之开始使用
获取包 使用maven获取包. <dependency> <groupId>com.netflix.hystrix</groupId> <artifactId ...
- Linux安装指定版Git以及卸载
来自于:https://www.cnblogs.com/rstyro/articles/10817855.html 安装Git 在linux中,安装Git 一般一条命令即可,如下: Debian/U ...
- Unity3D 一、游戏
3D游戏编程第一次作业 作业要求 阅读 Tracy Fullerton, *GAME DESIGN WORKSHOP* 第2-4章(游戏结构.基本元素.戏剧元素).选择一款你喜欢的中等规模游戏如&qu ...
- mxgraph浅入
mxgraph浅入 参考文献:https://www.cnblogs.com/xuxg/articles/3246206.html 1.了解 (1)如何判断需要引入mxgraph产品:过程图.工作流和 ...
- 欧拉函数线性求解以及莫比乌斯反演(Mobius)
前言 咕咕了好久终于来学习莫反了 要不是不让在机房谁会发现数学一本通上有这么神奇的东西 就是没有性质的证明 然后花了两节数学课证明了一遍 舒服- 前置知识:欧拉函数,二项式定理(组合数) 会欧拉函数的 ...
- Python-类属性查询协议-__getattr__ __getattribute__
__getattr__ 查找不到类属性的时候调用 class BeiMenChuiXue: def __init__(self, name): self.name = name def __getat ...
- 基于GAN的特征抽取 Feature Extraction by GAN
InfoGAN 期望的是 input 的每一个维度都能表示输出数据的某种特征.但实际改变输入的一个特定维度取值,很难发现输出数据随之改变的规律. InfoGAN 就是想解决这个问题.在 GAN 结构以 ...
- Python练习题 009:水仙花数
[Python练习题 009] 打印出所有的"水仙花数",所谓"水仙花数"是指一个三位数,其各位数字立方和等于该数本身.例如:153是一个"水仙花数& ...