
Scrapy使用RabbitMQ做任务队列
前言
一个月没更博客了,这个月也搞了不少东西,但是公司对保密性要求挺高,很多东西都没有办法写出来
想来想去,还是写一篇最近写Scrapy中遇到的跳转问题
如果你的业务需求是遇到301/302/303跳转的请求时继续请求网址,直到获取到最终的真实数据为止,那么这篇文章将会非常适合你
正文
队列选型
我们在使用SCRAPY中通常会使用分布式来提高爬取效率,所以需要一个任务队列来进行任务的下发,通常,该队列还承担着爬取的结果进行收集交由某几个Worker进行入库的作用
如果使用Redis作为任务队列,推荐使用 scrapy-redis 教程很多,这里不多说
这里着重介绍使用 RabbitMQ 作为任务队列,RabbitMQ的好处有很多,但是还是建议跟着业务走.
使用RabbitMQ作为任务队列
使用RabbitMQ作为任务队列的轮子很少,基本都已停止更新(17年),这里推荐一个国人的修改版,最近才开始发布,但是经本人实测已经可以正常使用
项目地址(GitHub)scrapy-rabbitmq-scheduler
因是国人写的,所以README文件写的通俗易懂.
安装
pip install scrapy-rabbitmq-scheduler
集成至Scrapy
在settings.py最后加入
# 指定项目的调度器

SCHEDULER = "scrapy_rabbitmq_scheduler.scheduler.SaaS"

# 指定rabbitmq的连接DSN

# amqp_url="amqp://username:password@ip:port/"

RABBITMQ_CONNECTION_PARAMETERS = 'amqp://admin:pwd@x.x.x.x:5672/'

# 指定重试的http状态码(重新加回队列重试)

# 如果结果的状态码位该list其中一个则会重试

# SCHEDULER_REQUEUE_ON_STATUS = [500]

# 指定下载器中间件, 确认任务是否成功

DOWNLOADER_MIDDLEWARES = {

    'scrapy_rabbitmq_scheduler.middleware.RabbitMQMiddleware': 999

}

# 指定item处理方式, item会加入到rabbitmq中

ITEM_PIPELINES = {

    'scrapy_rabbitmq_scheduler.pipelines.RabbitmqPipeline': 300,

}
爬虫编写
这里与Scrapy原来的方式稍有不同
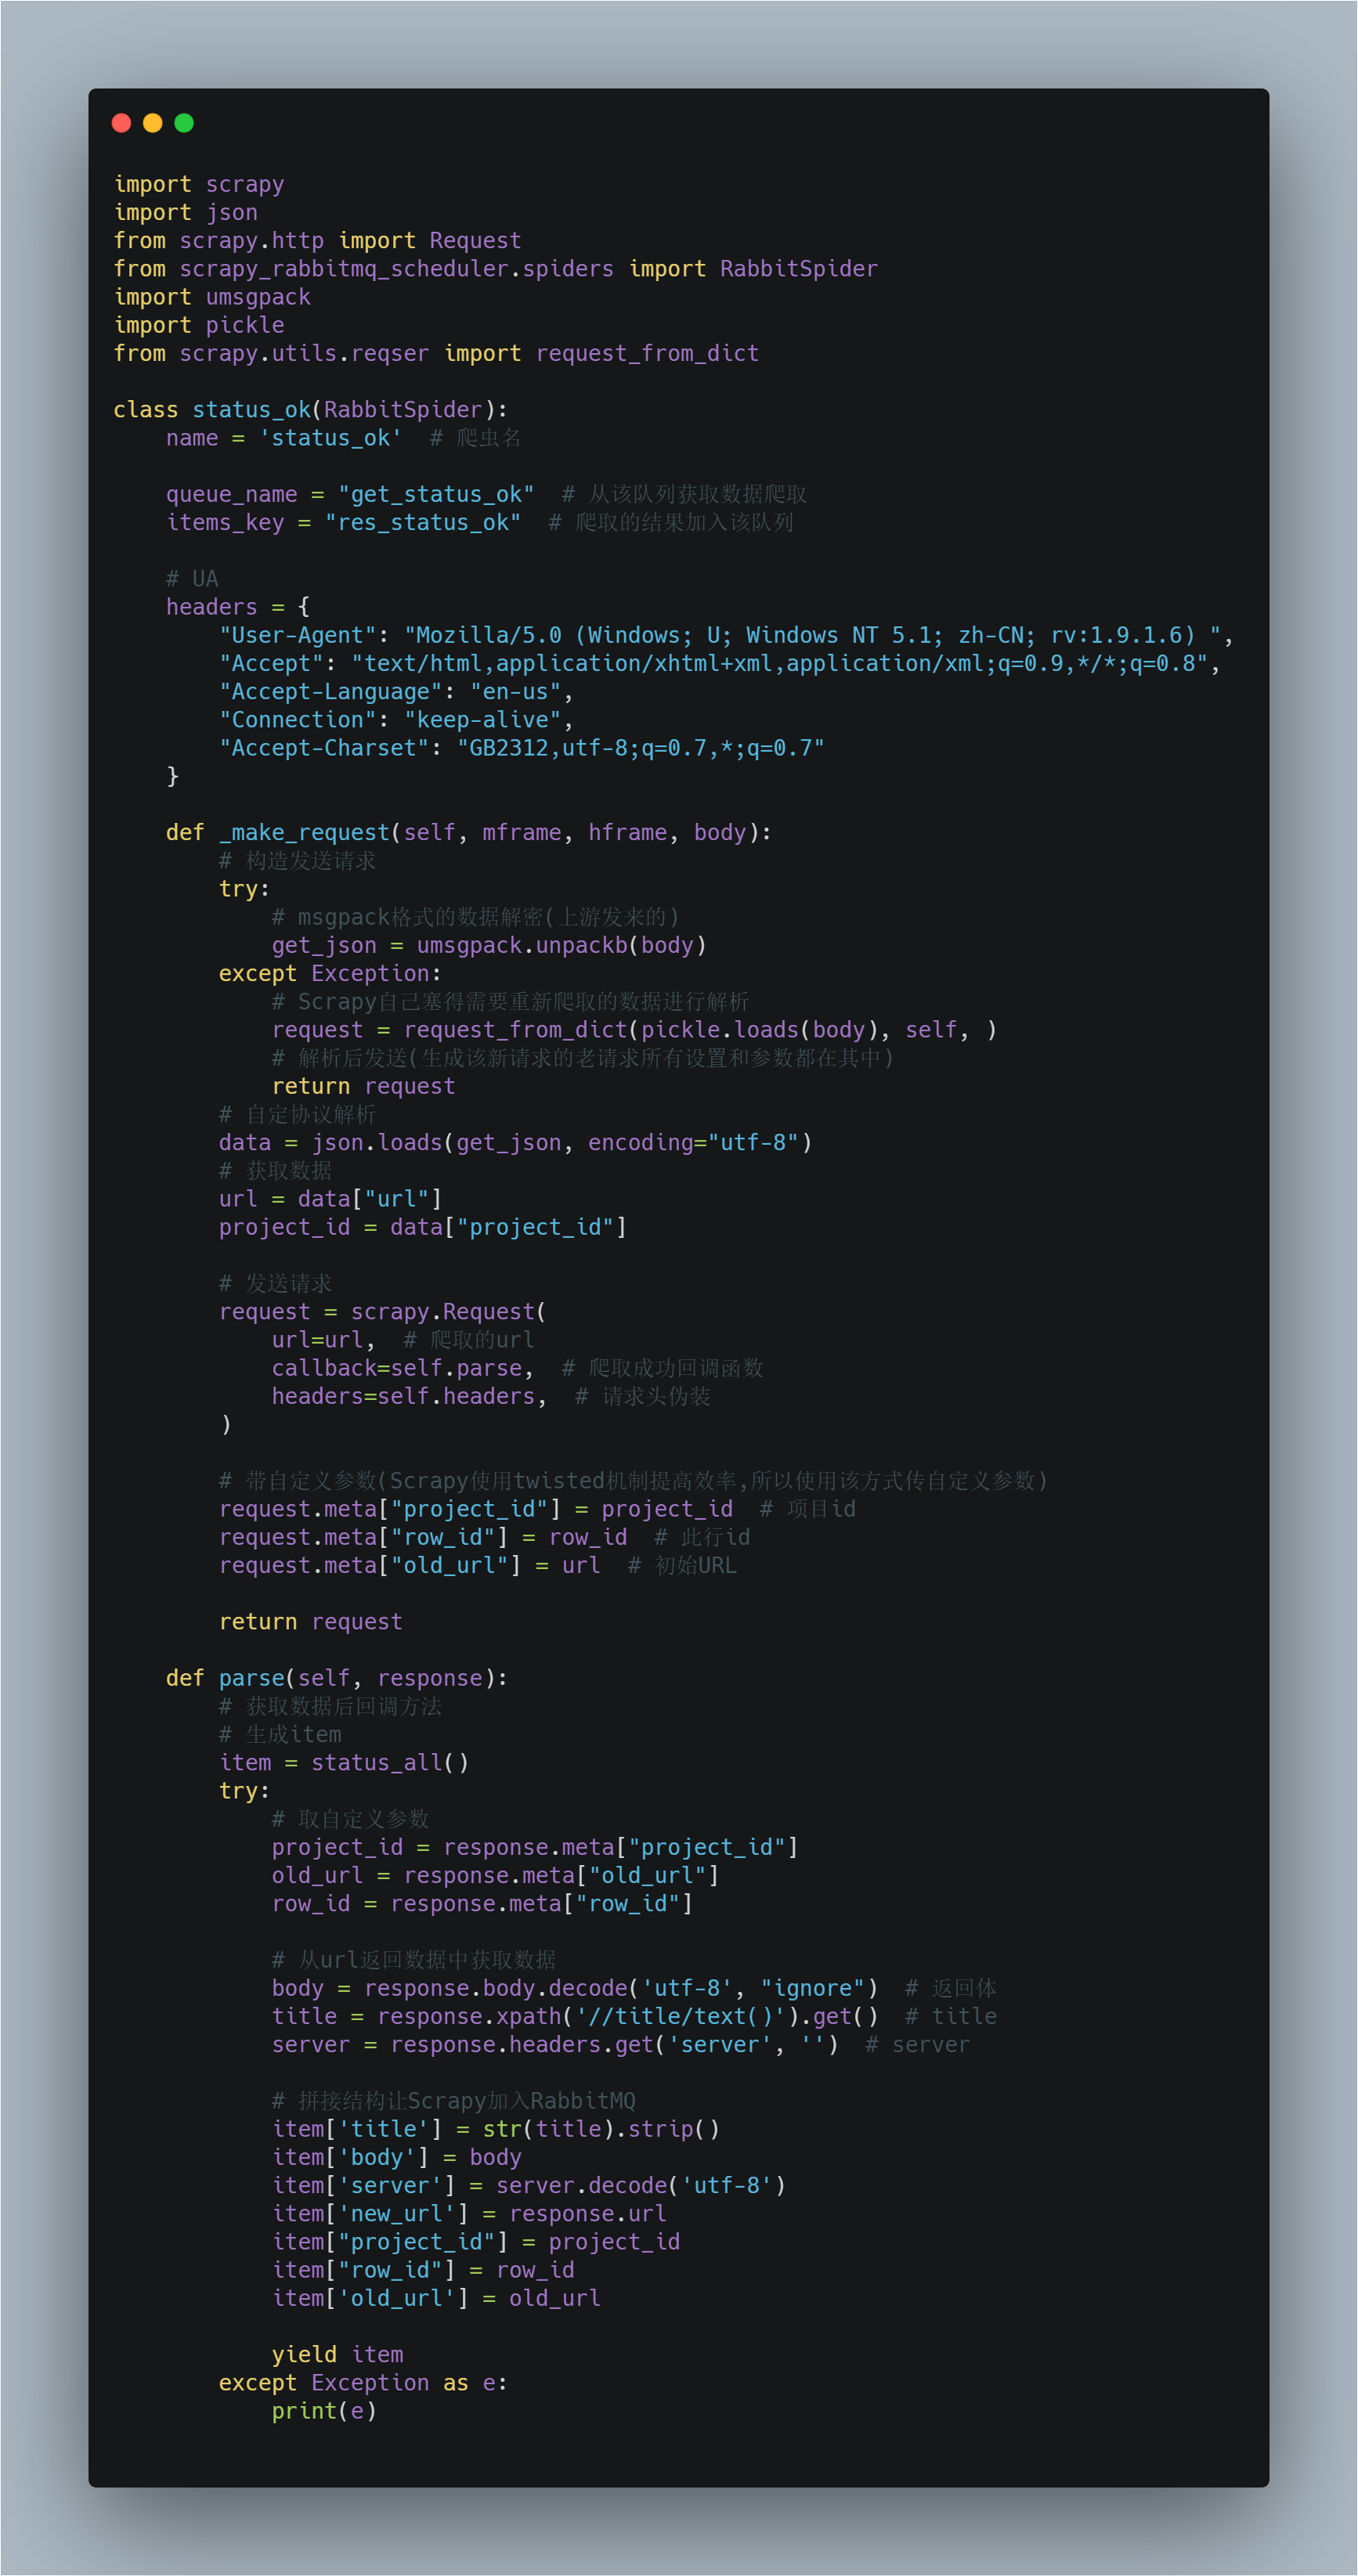
构造发送请求/接收RabbitMQ数据的方法名为 _make_request
我们必须重构该方法才可正常运行使用爬虫
该方法起到每次从队列中拿取数据后的解析数据并进行请求的作用
通常我们存放在队列中的一个数据为一个JSON/msgpack格式,里面包含了要请求的URl/该条数据所属ID等多个信息
必须要注意的是如果遇到跳转或你在setting中设置了返回状态码为xxx重新爬取,那么Scrapy会将需要重新爬取的url存放至你的队列中,此时队列中有两种格式的数据
- 上游生产者发送的符合你的通信协议的数据(JSON/msgpack)
- Scrapy自己加入的需要重新爬取的数据
所以我们要对这两种数据加以区分
爬虫示例
item是对返回数据序列化的,item
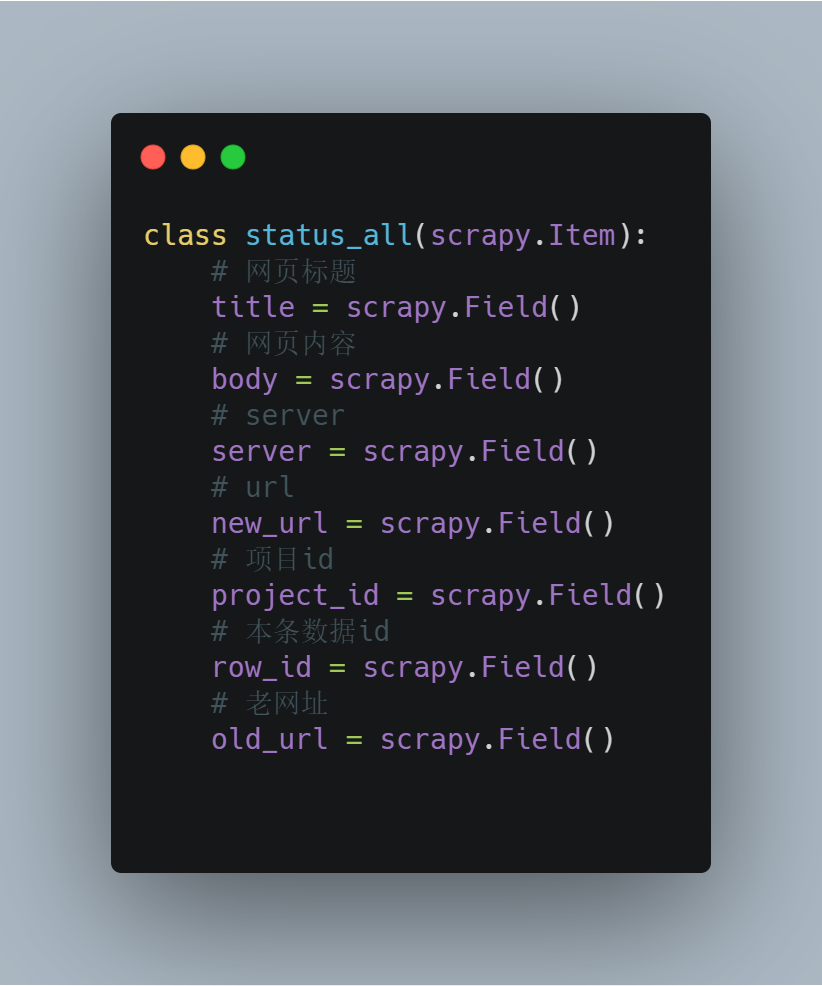
运行爬虫后,scrapy获取到的数据会转JSON传送至res_status_ok中(你自定义的)
添加个Work在队列另一端接收入库或其他操作即可
需要注意的点
Scrapy自己插入数据到分发队列
当时被这个问题卡了一小时,网上是没有解决方法的,他生成的数据也是不能使用常规方法进行解码的,这常常令人一头雾水
通道设置
该组件默认RabbitMQ持久化为True,因此请注意建立通道的时候将设置对齐否则会出现因为设置错误导致无法连接的问题
Scrapy使用RabbitMQ做任务队列的更多相关文章
- RabbitMQ之任务队列【译】
在第一个教程里面,我们写了一个程序从一个有名字的队列中发送和接收消息,在这里我们将要创建一个分发耗时任务给多个worker的任务队列. 任务队列核心思想就是避免执行一个资源密集型的任务,而程序要等待其 ...
- 使用IOCP完成端口队列做任务队列
使用IOCP完成端口队列做任务队列 与其自己费力设计异步任务队列,不如使用WINDOWS内核级的IOCP完成端口队列做任务队列. 1)引用单元 uses windows; 2)定义完成端口句柄 var ...
- springboot + rabbitmq 做智能家居,我也没想到会这么简单
本文收录在个人博客:www.chengxy-nds.top,共享技术资源,共同进步 前一段有幸参与到一个智能家居项目的开发,由于之前都没有过这方面的开发经验,所以对智能硬件的开发模式和技术栈都颇为好奇 ...
- (9)分布式下的爬虫Scrapy应该如何做-关于ajax抓取的处理(一)
转载请注明出处:http://www.cnblogs.com/codefish/p/4993809.html 最近在群里频繁的被问到ajax和js的处理问题,我们都知道,现在很多的页面都是用动态加载的 ...
- (8)分布式下的爬虫Scrapy应该如何做-图片下载(源码放送)
转载主注明出处:http://www.cnblogs.com/codefish/p/4968260.html 在爬虫中,我们遇到比较多需求就是文件下载以及图片下载,在其它的语言或者框架中,我们可能 ...
- 集成RabbitMQ做秒杀
由于秒杀的并发量太大,所以仅仅使用缓存是不够的,还需要用到RabbitMQ. 这里推荐一款用于分库分表的中间件:mycat 解决超卖的问题(看第五章节): 秒杀接口优化: 实操: 然后把下载好的文件上 ...
- (4)分布式下的爬虫Scrapy应该如何做-规则自动爬取及命令行下传参
本次探讨的主题是规则爬取的实现及命令行下的自定义参数的传递,规则下的爬虫在我看来才是真正意义上的爬虫. 我们选从逻辑上来看,这种爬虫是如何工作的: 我们给定一个起点的url link ,进入页面之后提 ...
- (3)分布式下的爬虫Scrapy应该如何做-递归爬取方式,数据输出方式以及数据库链接
放假这段时间好好的思考了一下关于Scrapy的一些常用操作,主要解决了三个问题: 1.如何连续爬取 2.数据输出方式 3.数据库链接 一,如何连续爬取: 思考:要达到连续爬取,逻辑上无非从以下的方向着 ...
- (2)分布式下的爬虫Scrapy应该如何做-关于对Scrapy的反思和核心对象的介绍
本篇主要介绍对于一个爬虫框架的思考和,核心部件的介绍,以及常规的思考方法: 一,猜想 我们说的爬虫,一般至少要包含几个基本要素: 1.请求发送对象(sender,对于request的封装,防止被封) ...
随机推荐
- 个人项目作业WC
项目github地址 https://github.com/gs735028922gs/wordc 项目相关要求 wc.exe 是一个常见的工具,它能统计文本文件的字符数.单词数和行数.这个项目要求写 ...
- 获取浏览器URL中查询字符串中的参数
//http://www.runoob.com/index.html?name=xiaoming&age=23function showWindowHref(){ var sHref = wi ...
- 开发实践丨用小熊派STM32开发板模拟自动售货机
摘要:本文内容是讲述用小熊派开发板模拟自动售货机,基于论坛提供的工程代码,通过云端开发和设备终端开发,实现终端数据在的华为云平台显示. 本文内容是讲述用小熊派开发板模拟自动售货机,基于论坛提供的工程代 ...
- WPF中Logical Tree和Visual Tree的区别
The Logical TreeThe logical tree describes the relations between elements of the user interface. The ...
- AcWing 339 .圆形数字
大型补档计划 题目链接 设 \(f[i][j]\) 表示二进制下,数字有 \(i\) 位, \(0\) 的个数 - \(1\) 的个数 \(=\) \(j\) 的方案数 \(f[0][0] = 1;\ ...
- 通过游戏学javascript系列第一节Canvas游戏开发基础
本节教程通过一个简单的游戏小例子,讲解Canvas的基础知识. 最终效果: 点击移动的方块,方块上的分数会增加,方块的行进方向会改变,并且方块的速度会增加. 在线演示 源码 HTML5引入了canva ...
- Linux下常用日志说明
/var/log/message ------------------------------------------系统启动后的信息和错误日志 /var/log/secure ----------- ...
- elasticsearch6.5.x-centos6
elasticsearch6.5.x-centos6 elasticsearch 和 关系型数据库中的类比 es ====== RDBMS index ----- database type ---- ...
- Linux 设置日期时间
linux 日期设置 直接设置日期和时间 date -s 2019-02-11 date -s 12:12:12 date -s "2019-02-11 12:12:12"
- java-02-基础语法
1.分支语句 if语句 格式 if(关系表达式1){语句1} else if(关系表达式2){语句2} else{语句3}; 说明 如果关系表达式1的值为true,执行语句1. 如果关系表达式2的值为 ...