
CUDA学习(三)之使用GPU进行两个数组相加
传入两个数组,在GPU中将两个数组对应索引位置相加
#include "cuda_runtime.h"

#include "device_launch_parameters.h"

#include <iomanip>

#include <iostream>

#include <stdio.h>

using namespace std;

//检测GPU

bool CheckCUDA(void){

    int count = ;

    int i = ;

    cudaGetDeviceCount(&count);

    if (count == ) {

        printf("找不到支持CUDA的设备!\n");

        return false;

    }

    cudaDeviceProp prop;

    for (i = ; i < count; i++) {

        if (cudaGetDeviceProperties(&prop, i) == cudaSuccess) {

            if (prop.major >= ) {

                break;

            }

        }

    }

    if (i == count) {

        printf("找不到支持CUDA的设备!\n");

        return false;

    }

    cudaGetDeviceProperties(&prop, );

    printf("GPU is: %s\n", prop.name);

    cudaSetDevice();

    printf("CUDA initialized success.\n");

    return true;

}//使用一维数组相加

__global__ void addForOneDim(double *a, double *b, double *c, int N);

//初始化一维数组

void InitOneDimArray(double *a, double b, int N);

int main(){

    //检测GPU

    if (!CheckCUDA()){

        cout << "No CUDA device.";

        return ;

    }

  //****数组相加************************************************************************************************************************

    cout << "****************************************数组相加*********************************************************************" << endl;

    int N = ;                  //定义数组大小

    double *h_a_one, *h_b_one, *h_c_one;      //声明在CPU上使用的指针

    double *d_a_one, *d_b_one, *d_c_one;             //声明在GPU上使用的指针

    //为数组分配大小

    h_a_one = new double[N];

    h_b_one = new double[N];

    h_c_one = new double[N];

    cudaMalloc((void **)&d_a_one, sizeof(double)*N);    //在GPU上分配内存空间

    cudaMalloc((void **)&d_b_one, sizeof(double)*N);

    cudaMalloc((void **)&d_c_one, sizeof(double)*N);

    //为数组初始化

    InitOneDimArray(h_a_one, 1.1, N);

    InitOneDimArray(h_b_one, 2.2, N);

    //使用GPU中分配的指针指向CPU中的数组

    cudaMemcpy(d_a_one, h_a_one, sizeof(double)*N, cudaMemcpyHostToDevice);

    cudaMemcpy(d_b_one, h_b_one, sizeof(double)*N, cudaMemcpyHostToDevice);

    //调用核函数,使用1个线程块N个线程

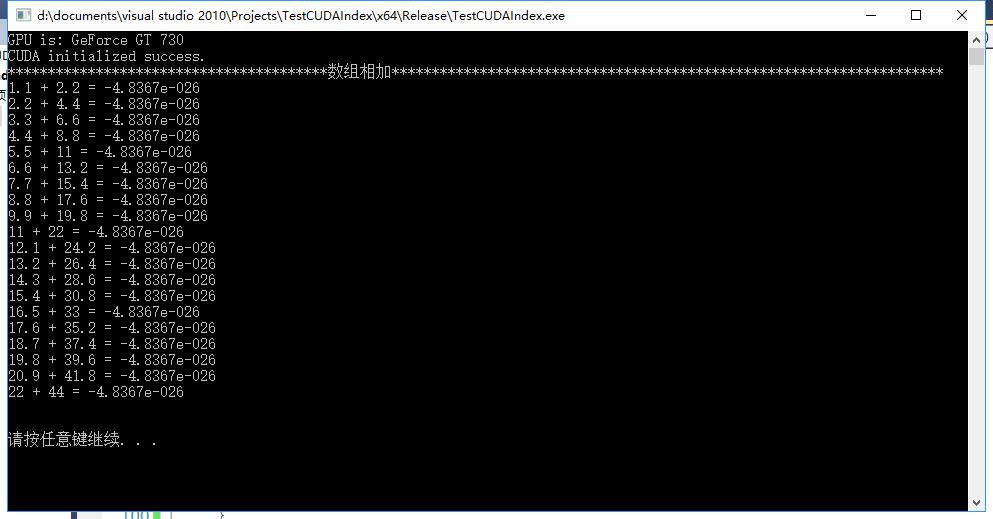
    //addForOneDim<<<1, N>>>(h_a_one, h_b_one, d_c_one, N);    //不能使用h_a_one和h_b_one,只能使用GPU上定义的指针,不然结果如图一所示

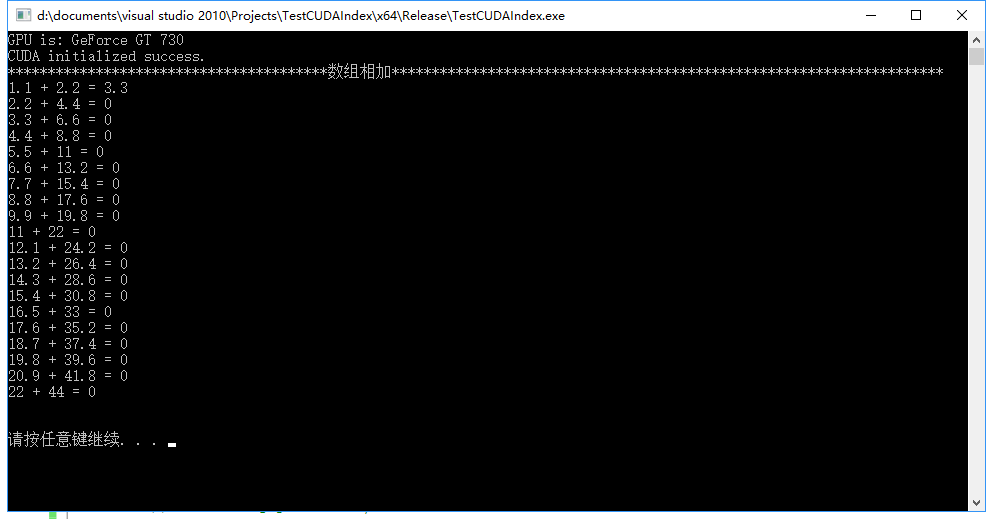
    addForOneDim<<<, N>>>(d_a_one, d_b_one, d_c_one, N);      //结果如图二所示
  //调用核函数,使用N个线程块,每个线程块中包含1个线程
  //addForOneDim<<<N, >>>(d_a_one, d_b_one, d_c_one, N);      //结果如图三所示

    //将GPU上计算好的结果返回到CPU上定义好的变量

    cudaMemcpy(h_c_one, d_c_one, sizeof(double)*N, cudaMemcpyDeviceToHost);

    //打印结果

    for (int i = ; i < N; i++){

        cout <<  h_a_one[i] << " + " << h_b_one[i] << " = " << h_c_one[i] << endl;

    }

    cout << endl << endl;

    system("pause");

    return ;

}

//使用一维数组相加

__global__ void addForOneDim(double *a, double *b, double *c, int N){

    int tid = threadIdx.x;      //线程索引,启用1个线程块,每个线程块N个线程

    if (tid < N){

        c[tid] = a[tid] + b[tid];

    }

}

//初始化一维数组

void InitOneDimArray(double *a, double b, int N){

    for (int i = ; i < N; i++){

        a[i] = (i+) * b;

        //cout << a[i] << endl;

    }

}
图一 (该图是错误的)
图二 (该图是正确的)

图三 (该图是错误的)当在调用核函数时,
addForOneDim<<<N, >>>(d_a_one, d_b_one, d_c_one, N);
使用的索引是
int tid = threadIdx.x; //对应的是一个线程块中每个线程id
正确的索引是
int tid = blockIdx.x; //对应的是每个线程块id
CUDA学习(三)之使用GPU进行两个数组相加的更多相关文章
- PHP两个数组相加
在PHP中,当两个数组相加时,会把第二个数组的取值添加到第一个数组上,同时覆盖掉下标相同的值: <?php $a = array("a" => "apple& ...
- PHP基础--两个数组相加
在PHP中,当两个数组相加时,会把第二个数组的取值添加到第一个数组上,同时覆盖掉下标相同的值: <?php $a = array("a" => "apple& ...
- PHP将两个数组相加
$arr_a=[1=>1,2=>2,3=>3];$arr_b=[1=>'a',4=>4];print_r($arr_a+$arr_b);返回结果:Array ( [1] ...
- OpenCL入门:(二:用GPU计算两个数组和)
本文编写一个计算两个数组和的程序,用CPU和GPU分别运算,计算运算时间,并且校验最后的运算结果.文中代码偏多,原理建议阅读下面文章,文中介绍了OpenCL相关名词概念. http://opencl. ...
- CUDA学习(三)之使用GPU进行两个数相加
在CPU上定义两个数并赋值,然后使用GPU核函数将两个数相加并返回到CPU,在CPU上显示 #include "cuda_runtime.h" #include "dev ...
- cuda学习3-共享内存和同步
为什么要使用共享内存呢,因为共享内存的访问速度快.这是首先要明确的,下面详细研究. cuda程序中的内存使用分为主机内存(host memory) 和 设备内存(device memory),我们在这 ...
- CUDA学习,第一个kernel函数及代码讲解
前一篇CUDA学习,我们已经完成了编程环境的配置,现在我们继续深入去了解CUDA编程.本博文分为三个部分,第一部分给出一个代码示例,第二部分对代码进行讲解,第三部分根据这个例子介绍如何部署和发起一个k ...
- CUDA学习笔记3:CUFFT(CUDA提供了封装好的CUFFT库)的使用例子
一.FFT介绍 傅里叶变换是数字信号处理领域一个很重要的数学变换,它用来实现将信号从时域到频域的变换,在物理学.数论.组合数学.信号处理.概率.统计.密码学.声学.光学等领域有广泛的应用.离散傅里叶变 ...
- CUDA学习之二:shared_memory使用,矩阵相乘
CUDA中使用shared_memory可以加速运算,在矩阵乘法中是一个体现. 矩阵C = A * B,正常运算时我们运用 C[i,j] = A[i,:] * B[:,j] 可以计算出结果.但是在CP ...
随机推荐
- Visual Studio 2017 安装心得
既然VS2017已经发布了,就想安装一下试试,先卸载VS2015, 网上有个完全卸载的东东,https://github.com/Microsoft/VisualStudioUninstaller/r ...
- 面试官刁难:Java字符串可以引用传递吗?
老读者都知道了,六年前,我从苏州回到洛阳,抱着一幅"海归"的心态,投了不少简历,也"约谈"了不少面试官,但仅有两三个令我感到满意.其中有一位叫老马,至今还活在我 ...
- ECShop二次开发指南(一)
ECSHOP是一套完整的网络商店解决方案,包括前台的商品展示.购物流程和强大易用的后台管理.由于 ecshop简单易用,使用者几乎可以在3几分钟简单的设置一下就可以拥有一个网上商店系统,所以很多的B2 ...
- Java基础知识学习(一)--引用
1.概念 如果一个变量的类型为类类型,而非基本类型,那么该变量就叫做引用: 2.对象引用 new Person(); 如上,代表创建了一个对象,但也仅仅是创建了,并没有办法去访问它. 为了访问 ...
- 实操教程丨如何在K8S集群中部署Traefik Ingress Controller
注:本文使用的Traefik为1.x的版本 在生产环境中,我们常常需要控制来自互联网的外部进入集群中,而这恰巧是Ingress的职责. Ingress的主要目的是将HTTP和HTTPS从集群外部暴露给 ...
- IOS系统唤醒微信内置地图
针对前一篇文章 唤醒微信内置地图 后来发现在IOS系统中运行 唤醒地图会无效的问题.因为在IOS上无法解析这俩个字符串的问题! 需要对经纬度 使用 “parseFloat()”进行转换 返回一个浮点数 ...
- 在64位ubuntu上安装tensorflow
首先从ubuntu14.04的安装讲起 1.下载ubuntu14.04 64位的系统,下载地址如下: http://www.ubuntu.com/download/desktop 2.下载好64位的u ...
- tomcat 介绍及环境搭建
一.tomcat介绍 Tomcat 服务器是一个免费的开放源代码的 Web 应用服务器,属于轻量级应用服务器,在中小型 系统和并发访问用户不是很多的场合下被普遍使用,是开发和调试 JSP 程序的首选. ...
- 《大厂面试》京东+百度一面,不小心都拿了Offer
你知道的越多,你不知道的越多 点赞再看,养成习惯 本文 GitHub https://github.com/JavaFamily 已收录,有一线大厂面试点思维导图,也整理了很多我的文档,欢迎Star和 ...
- C#实现文件Move操作和文件的Copy操作
文件移动(Move)操作和文件的复制(Copy)是C#程式开发经常遇到的方法,根据传入的源文件地址和目标文件地址参数,实现对文件的操作.实现代码如下: Move操作代码: public static ...