
SQL基础之GROUPING
1.grouping sets
记得前几天第一次接触grouping sets时,笔者的感觉是一脸懵逼。
后来一不小心看到msdn上对grouping sets的说明,顿时豁然开朗,其实grouping sets就是由多个group by联合起来,关系如下。
select A , B from table group by grouping sets(A, B) 等价于
select A , null as B from table group by A
union all
select null as A , B from table group by B
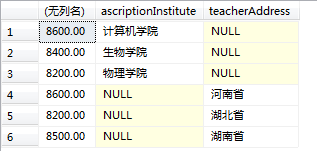
为了更好的理解我创建了teacher表,表数据如下,查询结果集中左边的为使用union all的group by字句,右边的为使用grouping sets的结果集。

select  null as teacherAddress,MAX(teacherSalary),ascriptionInstitute from teacher group by  ascriptionInstitute

union all

select  teacherAddress,MAX(teacherSalary),NULL as ascriptionInstitute from teacher group by  teacherAddress

select  teacherAddress,MAX(teacherSalary),ascriptionInstitute from teacher group by  GROUPING SETS (ascriptionInstitute,teacherAddress)


上面提到grouping sets是等价于带union all的group by子句,之所以是等价而不是等于,从两者结果集中的对比就可以一目了之,那就是它们的顺序不一样。这说明grouping sets并不只是group by的语法糖,这两者内部的执行过程应该是全然不同的,在百度过程中发现大多数答案都是这句话:“聚合是一次性从数据库中取出所有需要操作的数据,在内存中对数据库进行聚合操作并生成结果。而UNION ALL是多次扫描表,将返回的结果进行UNION操作。性能方面grouping sets能减少IO操作但会增加CPU占用时间”。我不理解的地方是一次性取出数据后,是如何在内存中进行聚合操作的?结果集虽然顺序不一样但数据是相同的,这说明依旧进行了联合操作而这个联合操作并不是多次扫描表,关键内部多次是如何扫描的我很好奇?对于性能我想知道为什么会这样子而不是看到现象。另外在grouping sets中如果将括号中的参数换个位置那么结果也将改变,这说明结果集中的顺序与参数的位置也有关,这让我更加好奇grouping sets的内部执行过程了。
select  MAX(teacherSalary),ascriptionInstitute ,teacherAddress from teacher group by  GROUPING SETS (ascriptionInstitute,teacherAddress)

select  MAX(teacherSalary),ascriptionInstitute ,teacherAddress from teacher group by  GROUPING SETS (teacherAddress,ascriptionInstitute)

2.grouping( )
grouping函数用来区分NULL值,这里NULL值有2种情况,一是原本表中的数据就为NULL,二是由rollup、cube、grouping sets生成的NULL值。
当为第一种情况中的空值时,grouping(NULL)返回0;当为第二种情况中的空值时,grouping(NULL)返回1。实例如下,从结果中可以看到第二个结果集中原本为null的数据由于grouping函数为1,故显示ROLLUP-NULL字符串。
select teacherAddress,ascriptionInstitute,COUNT(teacherId ) from teacher group by teacherAddress,ascriptionInstitute

select teacherAddress,ascriptionInstitute,COUNT(teacherId )  from teacher group by rollup(teacherAddress,ascriptionInstitute)

select ISNULL(teacherAddress,case when GROUPING(teacherAddress)=1 then 'ROLLUP-NULL' end) as teacherAddress,

            ISNULL(ascriptionInstitute,case when GROUPING(ascriptionInstitute)=1 then 'ROLLUP-NULL' end) as ascriptionInstitute,

            COUNT(teacherId )

            from teacher group by rollup(teacherAddress,ascriptionInstitute)


3.grouping_id( )
grouping_id函数也是计算分组级别的函数,注意如果要使用grouping_id函数那必须得有group by字句,而且group by字句的中的列与grouping_id函数的参数必须相等。比如group by A,B,那么必须使用grouping_id(A,B)。下面用一个等效关系来说明grouping_id()与grouping()的联系,grouping_id(A, B)等效于grouping(A) + grouping(B),但要注意这里的+号不是算术相加,它表示的是二进制数据组合在一起,比如grouping(A)=1,grouping(B)=1,那么grouping_id(A, B)=11B,也就是十进制数3。原来的表数据执行下面的sql语句结果太多效果不明显,所以我改了下表数据,不过对比两个结果集效果很明显。
select ISNULL(teacherAddress,case when GROUPING(teacherAddress)=1 then 'ROLLUP-NULL' end) as teacherAddress,

            ISNULL(ascriptionInstitute,case when GROUPING(ascriptionInstitute)=1 then 'ROLLUP-NULL' end) as ascriptionInstitute,

            ISNULL(teacherSex,case when GROUPING(teacherSex)=1 then 'ROLLUP-NULL' end) as teacherSex,

            COUNT(teacherId )

            from teacher group by rollup(teacherAddress,ascriptionInstitute,teacherSex)

select ISNULL(teacherAddress,case when GROUPING(teacherAddress)=1 then 'ROLLUP-NULL' end) as teacherAddress,

            ISNULL(ascriptionInstitute,case when GROUPING(ascriptionInstitute)=1 then 'ROLLUP-NULL' end) as ascriptionInstitute,

            ISNULL(teacherSex,case when GROUPING(teacherSex)=1 then 'ROLLUP-NULL' end) as teacherSex,

            COUNT(teacherId ) as '数量' ,

            GROUPING_ID(teacherAddress,ascriptionInstitute,teacherSex)

            from teacher group by rollup(teacherAddress,ascriptionInstitute,teacherSex)


SQL基础之GROUPING的更多相关文章
- 《SQL基础教程》+ 《SQL进阶教程》 学习笔记
写在前面:本文主要注重 SQL 的理论.主流覆盖的功能范围及其基本语法/用法.至于详细的 SQL 语法/用法,因为每家 DBMS 都有些许不同,我会在以后专门介绍某款DBMS(例如 PostgreSQ ...
- [SQL] SQL 基础知识梳理(一)- 数据库与 SQL
SQL 基础知识梳理(一)- 数据库与 SQL [博主]反骨仔 [原文地址]http://www.cnblogs.com/liqingwen/p/5902856.html 目录 What's 数据库 ...
- [SQL] SQL 基础知识梳理(二) - 查询基础
SQL 基础知识梳理(二) - 查询基础 [博主]反骨仔 [原文]http://www.cnblogs.com/liqingwen/p/5904824.html 序 这是<SQL 基础知识梳理( ...
- [SQL] SQL 基础知识梳理(三) - 聚合和排序
SQL 基础知识梳理(三) - 聚合和排序 [博主]反骨仔 [原文]http://www.cnblogs.com/liqingwen/p/5926689.html 序 这是<SQL 基础知识梳理 ...
- [SQL] SQL 基础知识梳理(四) - 数据更新
SQL 基础知识梳理(四) - 数据更新 [博主]反骨仔 [原文]http://www.cnblogs.com/liqingwen/p/5929786.html 序 这是<SQL 基础知识梳理( ...
- [SQL] SQL 基础知识梳理(五) - 复杂查询
SQL 基础知识梳理(五) - 复杂查询 [博主]反骨仔 [原文]http://www.cnblogs.com/liqingwen/p/5939796.html 序 这是<SQL 基础知识梳理( ...
- 黑马程序员+SQL基础(上)
黑马程序员+SQL基础 ---------------<a href="http://edu.csdn.net"target="blank">ASP ...
- Oracle SQL 基础学习
oracel sql 基础学习 CREATE TABLE USERINFO ( ID ,) PRIMARY KEY, USERNAME ), USERPWD ), EMAIL ), REDATE DA ...
- 第一章 SQL基础
第一部分:SQL基础1. 为什么学习SQL自人类社会形成之日起,社会的运转就在不断地产生和使用各种信息(文献.档案.资料.数据等):在如今所谓的信息时代,由于计算机和互联网的作用,信息的产生和使用达到 ...
随机推荐
- Linux文件操作常用命令整理
收集.整理日常系统管理或维护当中的,常用到的一些关于文件操作的命令或需求,后续会慢慢补充.完善! 查看.生成指定目录的目录树结构? [root@DB-Server ~]#tree #当前目录 ...
- truncate表hang住(等待时间较长),出现enq:RO fast object reuse等待事件
有一个应用truncate表等待了一晚上,一个定时任务,跑了几年了,今天早上来发现昨晚没有执行完成,hang住了,查询发现等待事件 fast object reuse. 10.2.0.4的库 Bug ...
- Android设置AlertDialog点击按钮对话框不关闭(转)
(转自:http://blog.csdn.net/winson_jason/article/details/8485524) 当我们在用到Android alertDialog创建对话框 的时候,我们 ...
- Android 的提权 (Root) 原理是什么?
作者:Kevin链接:https://www.zhihu.com/question/21074979/answer/18176410来源:知乎著作权归作者所有,转载请联系作者获得授权. Android ...
- 关于C语言中的位域
有些信息在存储时,并不需要占用一个完整的字节, 而只需占几个或一个二进制位.例如在存放一个开关量时,只有0和1 两种状态,用一位二进位即可.为了节省存储空间,并使处理简便,C语言提供了一种数据结构,称 ...
- 学习OpenStack之 (4): Linux 磁盘、分区、挂载、逻辑卷管理 (Logical Volume Manager)
0. 背景: inux用户安装Linux操作系统时遇到的一个常见的难以决定的问题就是如何正确地评估各分区大小,以分配合适的硬盘空间.普通的磁盘分区管理方式在逻辑分区划分好之后就无法改变其大小,当一个逻 ...
- 高级c++头文件bits/stdc++.h
用这种方法声明头文件只需两行代码 #include<bits/stdc++.h> using namespace std; 这个头文件包含以下等等C++中包含的所有头文件: #includ ...
- Caffe 抽取CNN网络特征 Python
Caffe Python特征抽取 转载请注明出处,楼燚(yì)航的blog,http://www.cnblogs.com/louyihang-loves-baiyan/ Caffe大家一般用到的深度学 ...
- POJ1837 Balance[分组背包]
Balance Time Limit: 1000MS Memory Limit: 30000K Total Submissions: 13717 Accepted: 8616 Descript ...
- 虚拟机软件VMware Workstation Pro的安装与使用
聚焦行业最佳实践,BDTC 2016完整议程公布 Java 编程入门(系列) 程序员11月书讯,评论得书啦 免费的知识库,你的知识库 虚拟机软件VMware Workst ...