
SQL group by底层原理——本质是排序,可以利用索引事先排好序
转自:http://blog.csdn.net/caomiao2006/article/details/52140993
由于GROUP BY 实际上也同样会进行排序操作,而且与ORDER BY 相比,GROUP BY 主要只是多了排序之后的分组操作。当然,如果在分组的时候还使用了其他的一些聚合函数,那么还需要一些聚合函数的计算。所以,在GROUP BY 的实现过程中,与 ORDER BY 一样也可以利用到索引。
在MySQL 中,GROUP BY 的实现同样有多种(三种)方式,其中有两种方式会利用现有的索引信息来完成 GROUP BY,另外一种为完全无法使用索引的场景下使用。下面我们分别针对这三种实现方式做一个分析。
1、使用松散(Loose)索引扫描实现 GROUP BY
何谓松散索引扫描实现 GROUP BY 呢?实际上就是当 MySQL 完全利用索引扫描来实现 GROUP BY 的时候,并不需要扫描所有满足条件的索引键即可完成操作得出结果。
下面我们通过一个示例来描述松散索引扫描实现 GROUP BY,在示例之前我们需要首先调整一下 group_message 表的索引,将 gmt_create 字段添加到 group_id 和 user_id 字段的索引中:
sky@localhost: example ::> create index idx_gid_uid_gc

 -> on group_message(group_id,user_id,gmt_create);

 Query OK, rows affected (0.03 sec)

 Records:  Duplicates:  Warnings:

sky@localhost: example ::> drop index idx_group_message_gid_uid

 -> on group_message;

 Query OK,  rows affected (0.02 sec)

 Records:  Duplicates:  Warnings:
然后再看如下 Query 的执行计划:
sky@localhost: example ::> EXPLAIN

 -> SELECT user_id,max(gmt_create)

 -> FROM group_message

 -> WHERE group_id <

 -> GROUP BY group_id,user_id\G

 *************************** . row ***************************

 id:

 select_type: SIMPLE

 table: group_message

 type: range

 possible_keys: idx_gid_uid_gc

 key: idx_gid_uid_gc

 key_len:

 ref: NULL

 rows:

 Extra: Using where; Using index for group-by
我们看到在执行计划的 Extra 信息中有信息显示“Using index for group-by”,实际上这就是告诉我们,MySQL Query Optimizer 通过使用松散索引扫描来实现了我们所需要的 GROUP BY 操作。
下面这张图片描绘了扫描过程的大概实现:
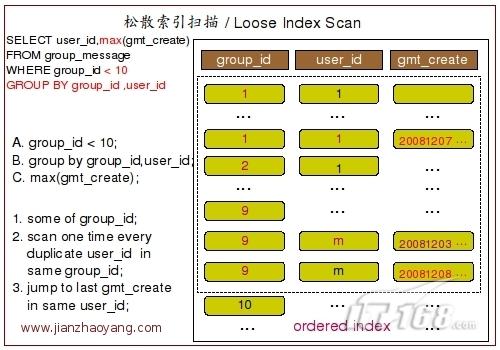
要利用到松散索引扫描实现 GROUP BY,需要至少满足以下几个条件:
◆GROUP BY 条件字段必须在同一个索引中最前面的连续位置;
◆在使用GROUP BY 的同时,只能使用 MAX 和 MIN 这两个聚合函数;
◆如果引用到了该索引中 GROUP BY 条件之外的字段条件的时候,必须以常量形式存在;
为什么松散索引扫描的效率会很高?
因为在没有WHERE子句,也就是必须经过全索引扫描的时候, 松散索引扫描需要读取的键值数量与分组的组数量一样多,也就是说比实际存在的键值数目要少很多。而在WHERE子句包含范围判断式或者等值表达式的时候, 松散索引扫描查找满足范围条件的每个组的第1个关键字,并且再次读取尽可能最少数量的关键字。
2.使用紧凑(Tight)索引扫描实现 GROUP BY
紧凑索引扫描实现 GROUP BY 和松散索引扫描的区别主要在于他需要在扫描索引的时候,读取所有满足条件的索引键,然后再根据读取恶的数据来完成 GROUP BY 操作得到相应结果。
 sky@localhost : example ::> EXPLAIN

-> SELECT max(gmt_create)

-> FROM group_message

-> WHERE group_id =

-> GROUP BY user_id\G

*************************** . row ***************************

id:

select_type: SIMPLE

table: group_message

type: ref

possible_keys: idx_group_message_gid_uid,idx_gid_uid_gc

key: idx_gid_uid_gc

key_len:

ref: const

rows:

Extra: Using where; Using index

 row in set (0.01 sec)
这时候的执行计划的 Extra 信息中已经没有“Using index for group-by”了,但并不是说 MySQL 的 GROUP BY 操作并不是通过索引完成的,只不过是需要访问 WHERE 条件所限定的所有索引键信息之后才能得出结果。这就是通过紧凑索引扫描来实现 GROUP BY 的执行计划输出信息。
下面这张图片展示了大概的整个执行过程:
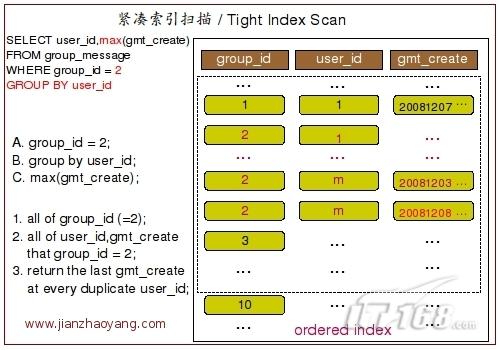
在 MySQL 中,MySQL Query Optimizer 首先会选择尝试通过松散索引扫描来实现 GROUP BY 操作,当发现某些情况无法满足松散索引扫描实现 GROUP BY 的要求之后,才会尝试通过紧凑索引扫描来实现。
当 GROUP BY 条件字段并不连续或者不是索引前缀部分的时候,MySQL Query Optimizer 无法使用松散索引扫描,设置无法直接通过索引完成 GROUP BY 操作,因为缺失的索引键信息无法得到。但是,如果 Query 语句中存在一个常量值来引用缺失的索引键,则可以使用紧凑索引扫描完成 GROUP BY 操作,因为常量填充了搜索关键字中的“差距”,可以形成完整的索引前缀。这些索引前缀可以用于索引查找。而如果需要排序GROUP BY结果,并且能够形成索引前缀的搜索关键字,MySQL还可以避免额外的排序操作,因为使用有顺序的索引的前缀进行搜索已经按顺序检索到了所有关键字。
3.使用临时表实现 GROUP BY
MySQL 在进行 GROUP BY 操作的时候要想利用所有,必须满足 GROUP BY 的字段必须同时存放于同一个索引中,且该索引是一个有序索引(如 Hash 索引就不能满足要求)。而且,并不只是如此,是否能够利用索引来实现 GROUP BY 还与使用的聚合函数也有关系。
前面两种 GROUP BY 的实现方式都是在有可以利用的索引的时候使用的,当 MySQL Query Optimizer 无法找到合适的索引可以利用的时候,就不得不先读取需要的数据,然后通过临时表来完成 GROUP BY 操作。
sky@localhost : example ::> EXPLAIN

-> SELECT max(gmt_create)

-> FROM group_message

-> WHERE group_id >  and group_id <

-> GROUP BY user_id\G

*************************** . row ***************************

id:

select_type: SIMPLE

table: group_message

type: range

possible_keys: idx_group_message_gid_uid,idx_gid_uid_gc

key: idx_gid_uid_gc

key_len:

ref: NULL

rows:

Extra: Using where; Using index; Using temporary; Using filesort
这次的执行计划非常明显的告诉我们 MySQL 通过索引找到了我们需要的数据,然后创建了临时表,又进行了排序操作,才得到我们需要的 GROUP BY 结果。整个执行过程大概如下图所展示:
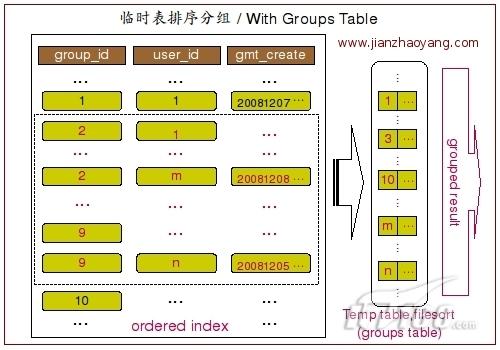
当 MySQL Query Optimizer 发现仅仅通过索引扫描并不能直接得到 GROUP BY 的结果之后,他就不得不选择通过使用临时表然后再排序的方式来实现 GROUP BY了。
在这样示例中即是这样的情况。 group_id 并不是一个常量条件,而是一个范围,而且 GROUP BY 字段为 user_id。所以 MySQL 无法根据索引的顺序来帮助 GROUP BY 的实现,只能先通过索引范围扫描得到需要的数据,然后将数据存入临时表,然后再进行排序和分组操作来完成 GROUP BY。
SQL group by底层原理——本质是排序,可以利用索引事先排好序的更多相关文章
- 【T-SQL进阶】02.理解SQL查询的底层原理
本系列[T-SQL]主要是针对T-SQL的总结. [T-SQL基础]01.单表查询-几道sql查询题 [T-SQL基础]02.联接查询 [T-SQL基础]03.子查询 [T-SQL基础]04.表表达式 ...
- 理解SQL查询的底层原理
阅读目录 一.SQL Server组成部分 二.查询的底层原理 本系列[T-SQL]主要是针对T-SQL的总结. T-SQL基础 [T-SQL基础]01.单表查询-几道sql查询题 [T-SQL基础] ...
- sql查询调优之where条件排序字段以及limit使用索引的奥秘
奇怪的慢sql 我们先来看2条sql 第一条: select * from acct_trans_log WHERE acct_id = 1000000000009000757 order b ...
- Mysql 排序优化与索引使用(转)
为了优化SQL语句的排序性能,最好的情况是避免排序,合理利用索引是一个不错的方法.因为索引本身也是有序的,如果在需要排序的字段上面建立了合适的索引,那么就可以跳过排序的过程,提高SQL的查询速度.下面 ...
- iOS底层原理总结 - 探寻block的本质(一)
面试题 block的原理是怎样的?本质是什么? __block的作用是什么?有什么使用注意点? block的属性修饰词为什么是copy?使用block有哪些使用注意? block在修改NSMu ...
- SQL 执行 底层原理(一)
一.SQL Server组成部分 1.关系引擎:主要作用是优化和执行查询.包含三大组件: (1)命令解析器:检查语法和转换查询树. (2)查询执行器:优化查询. (3)查询优化器:负责执行查询. 2. ...
- SQL中 left join 的底层原理
介绍 left join的实现效果就是保留左表的全部信息,将右表往左表上拼接,如果拼不上则为NULL. 除了left join以外,还有inner join.outer join.right join ...
- LINQ TO SQL ——Group by
原文:LINQ TO SQL --Group by 分组在SQL中应用的十分普遍,在查询,统计时都有可能会用到它.LINQ TO SQL中同样具备group的功能,这篇我来讲下LINQ TO SQL中 ...
- Lucene底层原理和优化经验分享(1)-Lucene简介和索引原理
Lucene底层原理和优化经验分享(1)-Lucene简介和索引原理 2017年01月04日 08:52:12 阅读数:18366 基于Lucene检索引擎我们开发了自己的全文检索系统,承担起后台PB ...
随机推荐
- junit在idea中的使用(2)--实践篇
目录:(1)普通java项目(2)在web项目中 (1)普通java项目 直接在代码中写上 @Before @Test即可,想执行main方法,直接右击main,选择run as import org ...
- 17南宁区域赛 I - Rake It In 【DFS】
题目链接 https://nanti.jisuanke.com/t/19975 题意 Alice 和 Bob 玩游戏 在一个4x4 的方格上 每个人 每次选择2x2的区域 将里面的四个值求和加到最后的 ...
- java生成字符串的MD5值
下面的代码实现了MD5值的生成: public class MD5Test2 { public static void main(String[] args) { System.out.println ...
- Python学习进程(9)序列
序列是Python中最基本的数据结构. (1)序列简介: 序列中的每个元素都分配一个数字标明它的位置或索引,第一个索引是0,第二个索引是1,依此类推.序列都可以进行的操作包括索引,切片,加,乘 ...
- vue 数据传递的方法
组件(Component)是 Vue.js 最强大的功能.组件可以封装可重用的代码,通过传入对象的不同,实现组件的复用,但组件传值就成为一个需要解决的问题. 1.父组件向子组件传值 组件实例的作用域是 ...
- 释放Linux系统缓存
清理Linux缓存使用下面的命令 sync; echo 3 > /proc/sys/vm/drop_caches 需求与原理 下面介绍buffer与cache的差别: A buffer is s ...
- 跨平台移动开发 Adobe Edge制作HTML5圣诞音乐贺卡DEMO
1.新建项目 2.添加背景,图片,音频 var au_to_play=new Audio(); au_to_play.src="audio/lap.mp3"; //指定文件名,这里 ...
- 13.常见模块re-正则模块
1.正则 正则表达式是计算机科学的一个概念,正则表通常被用来检索.替换那些符合某个模式(规则)的文本.也就是说使用正则表达式可以在字符串中匹配出你需要的字符或者字符串,甚至可以替换你不需要的字符或者字 ...
- poj 2186 Popular Cows 【强连通分量Tarjan算法 + 树问题】
题目地址:http://poj.org/problem?id=2186 Popular Cows Time Limit: 2000MS Memory Limit: 65536K Total Sub ...
- 如何在java代码中调用一个web项目jsp或者servlet
有时候需要调用一个web项目的jsp或者servlet,但是执行内部的代码,并不是打开jsp,例如需要在一段java代码中清除一个web项目中的缓存,那么可以把清除缓存的代码放在该web项目的一个se ...