
Alex 的 Hadoop 菜鸟教程: 第3课 Hadoop 安装教程 - 非HA方式 (一台server)
原帖地址: http://blog.csdn.net/nsrainbow/article/details/36629741
接上一个教程:http://blog.csdn.net/nsrainbow/article/details/36629339
本教程是在 Centos6 下使用yum来安装 CDH5 版本号的 hadoop 的教程。 假设没有加入yum源的请參考上一个教程:http://blog.csdn.net/nsrainbow/article/details/36629339
Hadoop架构图
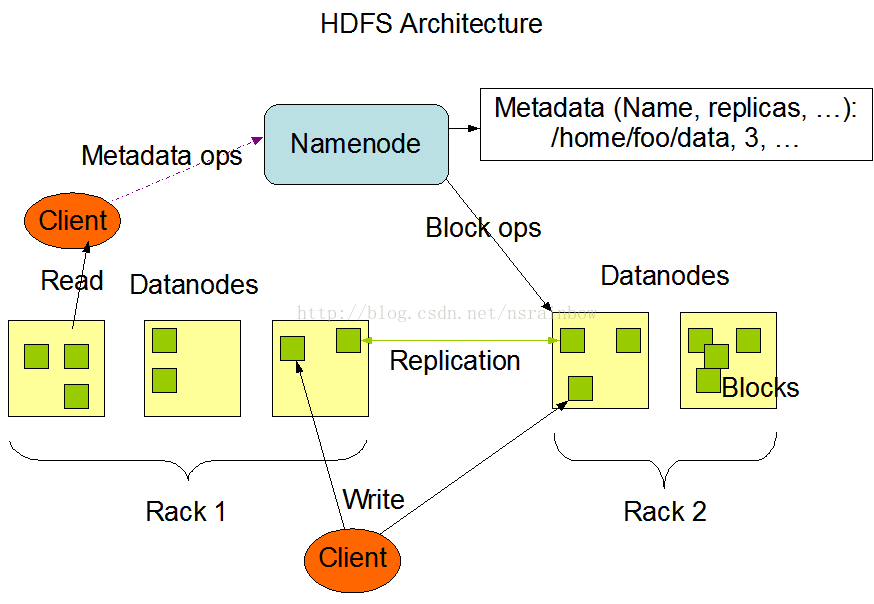
- NameNode、DataNode和Client
NameNode能够看作是分布式文件系统中的管理者,主要负责管理文件系统的命名空间、集群配置信息和存储块的复制等。NameNode会将文件系统的Meta-data存储在内存中,这些信息主要包含了文件信息、每个文件相应的文件块的信息和每个文件块在DataNode的信息等。
DataNode是文件存储的基本单元,它将Block存储在本地文件系统中,保存了Block的Meta-data,同一时候周期性地将全部存在的Block信息发送给NameNode。Client就是须要获取分布式文件系统文件的应用程序。
- 文件写入
Client向NameNode发起文件写入的请求。NameNode依据文件大小和文件块配置情况。返回给Client它所管理部分DataNode的信息。
Client将文件划分为多个Block,依据DataNode的地址信息。按顺序写入到每个DataNode块中。 - 文件读取
Client向NameNode发起文件读取的请求
NameNode返回文件存储的DataNode的信息。
Client读取文件信息。
開始安装非HA模式
1. 加入库key
$ sudo rpm --import http://archive.cloudera.com/cdh5/redhat/6/x86_64/cdh/RPM-GPG-KEY-cloudera2. 安装CDH5
2.1 安装Resource Manager host
$ sudo yum clean all

$ sudo yum install hadoop-yarn-resourcemanager -y
2.2 安装 NameNode host
$ sudo yum clean all

$ sudo yum install hadoop-hdfs-namenode -y
2.3 安装 Secondary NameNode host
$ sudo yum clean all

$ sudo yum install hadoop-hdfs-secondarynamenode -y
2.4 安装 nodemanager , datanode, mapreduce (官方说明是在除了 Resource Manager以外的机子上装这些,可是我们如今就一台机子。所以就在这台机子上装)
$ sudo yum clean all

$ sudo yum install hadoop-yarn-nodemanager hadoop-hdfs-datanode hadoop-mapreduce -y
2.5 安装 hadoop-mapreduce-historyserver hadoop-yarn-proxyserver (官方说是在cluster中挑一台做host,可是我们就一台,就直接在这台上装)
$ sudo yum clean all

$ sudo yum install hadoop-mapreduce-historyserver hadoop-yarn-proxyserver -y
2.6 安装 hadoop-client (用户连接hadoop的client,官方说在client装,我们就直接在这台上装)
$ sudo yum clean all

$ sudo yum install hadoop-client -y
3. 部署CDH
3.1 配置计算机名(默认是localhost)
先看看自己的hostname有没有设置
$ sudo vim /etc/sysconfig/network

HOSTNAME=localhost.localdomain
假设HOSTNAME是 localhost.localdomain的话就改一下
HOSTNAME=myhost.mydomain.com
然后再执行下,保证马上生效
$ sudo hostname myhost.mydomain.com检查一下是否设置生效
$ sudo uname -a3.2 改动配置文件
先切换到root用户。免得每行命令之前都加一个sudo,所以下面教程都是用root角度写的
$ sudo su -

$ cd /etc/hadoop/conf

$ vim core-site.xml
在 <configuration>...</configuration> 中添加
<property>

	<name>fs.defaultFS</name>

	<value>hdfs://myhost.mydomain.com:8020</value>

</property>
编辑hdfs-site.xml
$ vim hdfs-site.xml在 <configuration>...</configuration> 中加入
<property>

 <name>dfs.permissions.superusergroup</name>

 <value>hadoop</value>

</property>
3.3 配置存储目录
在 namenode 机子上配置 hdfs.xml 用来存储name元数据(我们仅仅有一台机,所以既是namenode又是datanode)
$ vim hdfs-site.xml改动dfs.name.dir 为 dfs.namenode.name.dir(dfs.name.dir已经过时),并改动属性值,一般来说我们的 /data 或者 /home/data 都是挂载大硬盘数据用的,所以把存储目录指向这个路径里面的目录比較较好
<property>

     <name>dfs.namenode.name.dir</name>

     <value>file:///data/hadoop-hdfs/1/dfs/nn</value>

  </property>
在 datanode上配置 hdfs.xml 用来存储实际数据(我们仅仅有一台机,所以既是namenode又是datanode)
$ vim hdfs-site.xml添加dfs.datanode.data.dir(dfs.data.dir已经过时)配置
<property>

     <name>dfs.datanode.data.dir</name>

     <value>file:///data/hadoop-hdfs/1/dfs/dn,file:///data/hadoop-hdfs/2/dfs/dn</value>

  </property>
建立这些目录
$ mkdir -p /data/hadoop-hdfs/1/dfs/nn

$ mkdir -p /data/hadoop-hdfs/1/dfs/dn

$ mkdir -p /data/hadoop-hdfs/2/dfs/dn
改动目录用户
$ chown -R hdfs:hdfs /data/hadoop-hdfs/1/dfs/nn /data/hadoop-hdfs/1/dfs/dn /data/hadoop-hdfs/2/dfs/dn改动目录权限
$ chmod 700 /data/hadoop-hdfs/1/dfs/nn3.4 格式化namenode
$ sudo -u hdfs hdfs namenode -format3.5 配置 Secondary NameNode
在hdfs-site.xml中加入
<property>

  <name>dfs.namenode.http-address</name>

  <value>0.0.0.0:50070</value>

  <description>

    The address and the base port on which the dfs NameNode Web UI will listen.

  </description>

</property>
3.6 启动hadoop
$ for x in `cd /etc/init.d ; ls hadoop-*` ; do sudo service $x start ; done

Starting Hadoop nodemanager:                               [  OK  ]

starting nodemanager, logging to /var/log/hadoop-yarn/yarn-yarn-nodemanager-xmseapp03.ehealthinsurance.com.out

Starting Hadoop proxyserver:                               [  OK  ]

starting proxyserver, logging to /var/log/hadoop-yarn/yarn-yarn-proxyserver-xmseapp03.ehealthinsurance.com.out

Starting Hadoop resourcemanager:                           [  OK  ]

starting resourcemanager, logging to /var/log/hadoop-yarn/yarn-yarn-resourcemanager-xmseapp03.ehealthinsurance.com.out

Starting Hadoop datanode:                                  [  OK  ]

starting datanode, logging to /var/log/hadoop-hdfs/hadoop-hdfs-datanode-xmseapp03.ehealthinsurance.com.out

Starting Hadoop namenode:                                  [  OK  ]

starting namenode, logging to /var/log/hadoop-hdfs/hadoop-hdfs-namenode-xmseapp03.ehealthinsurance.com.out

Starting Hadoop secondarynamenode:                         [  OK  ]

starting secondarynamenode, logging to /var/log/hadoop-hdfs/hadoop-hdfs-secondarynamenode-xmseapp03.ehealthinsurance.com.out

...
都成功后用jps看下
$jps

17033 NodeManager

16469 DataNode

17235 ResourceManager

17522 JobHistoryServer

16565 NameNode

16680 SecondaryNameNode

17593 Jps
4 client測试
打开你的浏览器输入 http://<hadoop server ip>:50070
假设看到
Hadoop Administration
DFS Health/Status
这种字样就成功进入了hadoop的命令控制台
Alex 的 Hadoop 菜鸟教程: 第3课 Hadoop 安装教程 - 非HA方式 (一台server)的更多相关文章
- Alex 的 Hadoop 菜鸟教程: 第2课 hadoop 安装教程 (CentOS6 CDH分支 yum方式)
原帖地址:http://blog.csdn.net/nsrainbow/article/details/36629339 我们这个教程是在 centos 上安装cdh的教程,并且使用的是yum方式. ...
- Docker和Docker-compose安装教程以及docker-elk,docker-storm安装教程
此安装教程仅供我自己安装配置时查看,其他的人不可以偷看!!! 安装Docker 1. Update package information, ensure that APT works with th ...
- MySQL官方教程及各平台的安装教程和配置详解入口
官方文档入口: https://dev.mysql.com/doc/ 一般选择MySQL服务器版本入口: https://dev.mysql.com/doc/refman/en/ 在右侧有版本选择: ...
- hadoop分布式集群完全安装(非HA)
一.各节点基础环境配置(最好每台都配置) 先输入su获取root权限 1修改主机名 输入vim /etc/sysconfig/network 改成: NETWORKING=yes HOSTNAME=m ...
- 【Hadoop离线基础总结】Hive的安装部署以及使用方式
Hive的安装部署以及使用方式 安装部署 Derby版hive直接使用 cd /export/softwares 将上传的hive软件包解压:tar -zxvf hive-1.1.0-cdh5.14. ...
- 2018超详细sublime text3+python3.x安装配置教程(附常用插件安装教程)
导读 本文是关于2018年7月最新版sublime text3+pythin3.x下载及安装配置教程,sublime text3版本为3176,python版本为3.7,安装环境是基于windows1 ...
- PL/SQL Developer安装教程以及汉化包安装教程
一.安装PL/SQL 1.百度下载plsql破解版软件,官网只能使用30天 2.双击plsqldev906.exe进行安装,点击 iagree 3.默认是安装在c盘,可以根据自己需要更改安装目录 4. ...
- WordPaster.exe安装教程
安装教程: Firefox控件安装教程 Chrome控件安装教程 Chrome 45+控件安装教程 相关问题: 提示Runtime Error错误 360拦截 Chrome启用npapi Fire ...
- Redis安装教程及可视化工具RedisDesktopManager下载安装
Redis安装教程: 1. Windows下安装教程: 下载:https://github.com/MSOpenTech/redis/releases Redis 支持 32 位和 64 位.这个需要 ...
随机推荐
- 3---Django rest framework源码分析(3)----节流
Django rest framework源码分析(3)----节流 目录 添加节流 自定义节流的方法 限制60s内只能访问3次 (1)API文件夹下面新建throttle.py,代码如下: # u ...
- IT职场?未来?
转自 IT职场?未来? 不能否认,有些技术大牛,生活也过的不错,工资不少挣.但是这种人,本来就不多啊,很少啊.这些人一般都是小时候就搞程序的,你觉得你半路出家,能变成这种超级牛人么?? 而且这些牛人, ...
- 移动端刷新组件XtnScroll--Angular4实现
刷新组件 - 主要是学习一下Angular4所有花了我一天时间,写了这个刷新组件. 以项目开发当中,特别是手机移动端开发的时候,经常要用到就是上拉加载下一面,下拉刷新获取最新数据的功能. 在网也有很多 ...
- 原生态hadoop2.6平台搭建
hadoop2.6平台搭建 一.条件准备 软件条件: Ubuntu14.04 64位操作系统,jdk1.7 64位,Hadoop 2.6.0 硬件条件: 1台主节点机器,配置:cpu 8个,内存32 ...
- Linux软件安装的补充
1 使用yum 命令查看软件提供的版本 yum list mysql* 然后比如说都需要安装我们就可以执行命令: yum install mysql* 然后就会安装所有的.会显示所有需要安装的包,和需 ...
- jdk7.NIO.2学习笔记之目录文件及权限
package com.zl.jdk7; import java.io.File; import java.io.IOException; import java.nio.file.Path; imp ...
- codeigniter读取数据库的公共配置并全局缓存的实现方案
引言 学习CodeIgniter大概有几天了.从第一天了解后,对CI情有独钟,比较符合我的风格.其实一直以来对框架这块不太敏感.自己长时间的开发,也有一套自己的开发风格和习惯.但是这年头,你说你不会框 ...
- 一个典型案例为你解读TDSQL 全时态数据库系统
欢迎大家前往腾讯云+社区,获取更多腾讯海量技术实践干货哦~ 本文由腾讯技术工程官方号发表在腾讯云+社区 经典案例 增量抽取.增量计算等都是T-TDSQL的经典案例.如下以增量计算为例,来分析T-TDS ...
- node.js async/await 继发执行与并发执行
async/await 继发执行与并发执行,看如何控制 两个异步函数 foo bar function foo() { return new Promise((resolve, reject) =&g ...
- mysql 查两个表相同的值
比如一个数据库 表A和表B 都有一个username字段, 现查出与表A中username值相同的表B的username和password数据 select B.username,B.password ...