
K 折验证
为了在调节网络参数(比如训练的轮数)的同时对网络进行评估,你可以将数据划分为训练集和验证集。但由于数据点很少,验证集会非常小(比如大约100 个样本)。因此,验证分数可能会有很大波动,这取决于你所选择的验证集和训练集。也就是说,验证集的划分方式可能会造成验证分数上有很大的方差,这样就无法对模型进行可靠的评估。
在这种情况下,最佳做法是使用 K 折交叉验证。这种方法将可用数据划分为 K个分区(K 通常取 4 或 5),实例化 K 个相同的模型,将每个模型在 K-1 个分区上训练,并在剩下的一个分区上进行评估。模型的验证分数等于 K 个验证分数的平均值。 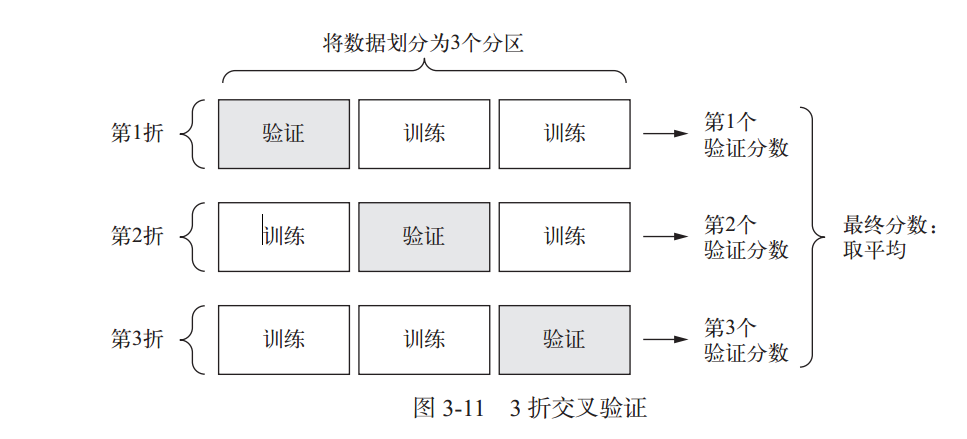
一个可能的程序示例:
k = 4 #划分成k块

num_validation_samples = len(data) // k

np.random.shuffle(data)

validation_scores = []

for fold in range(k):

  validation_data = data[num_validation_samples * fold : num_validation_samples * (fold + 1)]

  training_data = data[:num_validation_samples * fold] + data[num_validation_samples * (fold + 1):]

model = get_model()

model.train(training_data)

validation_score = model.evaluate(validation_data)

validation_scores.append(validation_score)

validation_score = np.average(validation_scores)

model = get_model()

model.train(data)

test_score = model.evaluate(test_data)
K 折验证的更多相关文章
- sklearn的K折交叉验证函数KFold使用
K折交叉验证时使用: KFold(n_split, shuffle, random_state) 参数:n_split:要划分的折数 shuffle: 每次都进行shuffle,测试集中折数的总和就是 ...
- 机器学习--K折交叉验证和非负矩阵分解
1.交叉验证 交叉验证(Cross validation),交叉验证用于防止模型过于复杂而引起的过拟合.有时亦称循环估计, 是一种统计学上将数据样本切割成较小子集的实用方法. 于是可以先在一个子集上做 ...
- cross_val_score 交叉验证与 K折交叉验证,嗯都是抄来的,自己作个参考
因为sklearn cross_val_score 交叉验证,这个函数没有洗牌功能,添加K 折交叉验证,可以用来选择模型,也可以用来选择特征 sklearn.model_selection.cross ...
- 小白学习之pytorch框架(7)之实战Kaggle比赛:房价预测(K折交叉验证、*args、**kwargs)
本篇博客代码来自于<动手学深度学习>pytorch版,也是代码较多,解释较少的一篇.不过好多方法在我以前的博客都有提,所以这次没提.还有一个原因是,这篇博客的代码,只要好好看看肯定能看懂( ...
- 小白学习之pytorch框架(6)-模型选择(K折交叉验证)、欠拟合、过拟合(权重衰减法(=L2范数正则化)、丢弃法)、正向传播、反向传播
下面要说的基本都是<动手学深度学习>这本花书上的内容,图也采用的书上的 首先说的是训练误差(模型在训练数据集上表现出的误差)和泛化误差(模型在任意一个测试数据集样本上表现出的误差的期望) ...
- k折交叉验证
原理:将原始数据集划分为k个子集,将其中一个子集作为验证集,其余k-1个子集作为训练集,如此训练和验证一轮称为一次交叉验证.交叉验证重复k次,每个子集都做一次验证集,得到k个模型,加权平均k个模型的结 ...
- 偏差(bias)和方差(variance)及其与K折交叉验证的关系
先上图: 泛化误差可表示为偏差.方差和噪声之和 偏差(bias):学习算法的期望预测与真实结果(train set)的偏离程度(平均预测值与真实值之差),刻画算法本身的拟合能力: 方差(varianc ...
- K折-交叉验证
k-折交叉验证(k-fold crossValidation):在机器学习中,将数据集A分为训练集(training set)B和测试集(test set)C,在样本量不充足的情况下,为了充分利用数据 ...
- KFold,StratifiedKFold k折交叉切分
python风控评分卡建模和风控常识(博客主亲自录制视频教程) https://study.163.com/course/introduction.htm?courseId=1005214003&am ...
随机推荐
- C语言博客作业10
一.本周教学内容&目标 第4章 循环结构 4.5 综合介绍循环结构的程序设计,涉及到多个典型算法.要求学生能够根据实际情况,选择合适的算法.合理的循环结构,熟练的编写程序. 二.本周作业头 这 ...
- Spring Data JPA 条件查询的关键字
Spring Data JPA 为此提供了一些表达条件查询的关键字,大致如下: And --- 等价于 SQL 中的 and 关键字,比如 findByUsernameAndPassword(Stri ...
- vue实例化过程
我们在用vue进行开发项目时,是否存在疑惑,new Vue(xxx)的过程中,究竟发生了什么?定义的数据,是如何绑定到视图上的?本篇主要介绍在实例化vue时,主要做了哪些事,文章比较长,主要篇幅内容为 ...
- python-布隆过滤器
在学习redis过程中提到一个缓存击穿的问题, 书中参考的解决方案之一是使用布隆过滤器, 那么就有必要来了解一下什么是布隆过滤器.在参考了许多博客之后, 写个总结记录一下. 一.布隆过滤器简介 什么是 ...
- 图的存储结构与操作--C语言实现
图(graph)是一种比树结构还要复杂的数据结构,它的术语,存储方式,遍历方式,用途都比较广,所以如果想要一次性完成所有的代码,那代码会非常长.所以,我将分两次来完成图的代码.这一次,我会完成图的五种 ...
- Semaphore回顾
用途 在多线程访问可变变量时,是非线程安全的.可能导致程序崩溃.此时,可以通过使用信号量(semaphore)技术,保证多线程处理某段代码时,后面线程等待前面线程执行,保证了多线程的安全性.使用方法记 ...
- 3分钟了解ServiceStage 应用智能化运维【华为云分享】
[摘要] 微服务云应用平台(ServiceStage)是面向企业及开发者的一站式DevOps平台服务,支持基于微服务的应用开发.治理.部署及运维监控的全生命周期管理,并提供大规模容器集群管理及中间件服 ...
- 技术谈 | SDN 和 NFV 之间的爱与恨
部分开发者经常混淆 SDN 和 NFV,无法看清他们的关系.今天,小编搬出华为技术专家的一篇大稿,给大家掰扯掰扯:SDN 和 NFV 究竟是什么关系. ----文/闫长江 什么是 SDN 回到基本的概 ...
- 【Elasticsearch 7 探索之路】(五)搜索相关 Search-API
本节主要讲解 Elasticsearch 的 搜索相关功能 Search-API,讲解什么是 URL Search 和 Request Body Search 的语法,对常用的语法都会一一进行详细介绍 ...
- 面试阿里被分布式“搞懵”,Redis、MongoDB、memcached没答上来
都说大厂面试难,一点也没有错,一线大厂的面试究竟怎么样还得自己亲身经历了才知道.小白面试阿里,就被面试官吊打,一问分布式就被“搞懵”了,Redis.MongoDB.Memcached都没答好,很多没有 ...