
python第三次作业-mooc笔记
1.注册中国大学MOOC

2.选择北京理工大学嵩天老师的《Python网络爬虫与信息提取》MOOC课程
3.学习完成第0周至第4周的课程内容,并完成各周作业
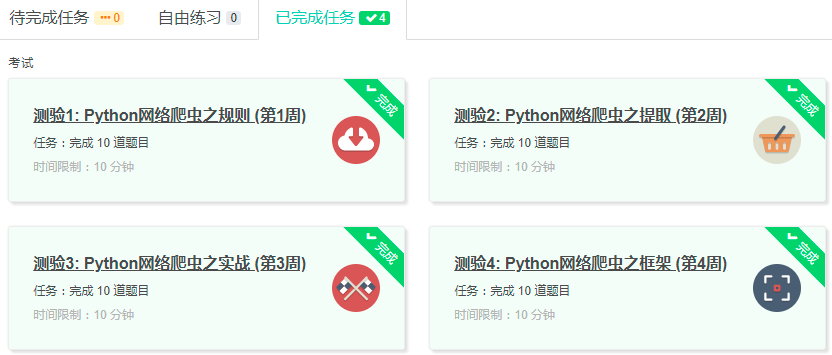
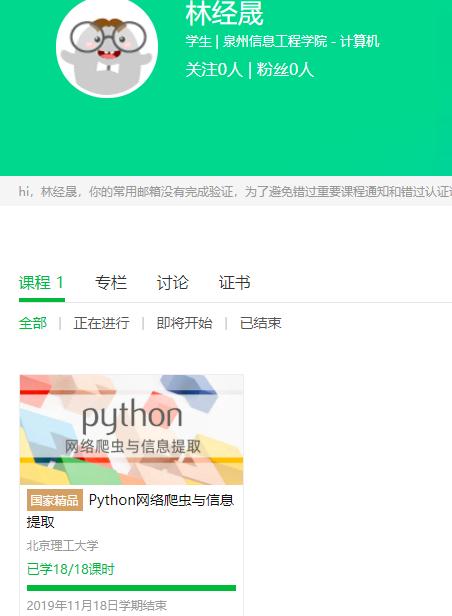
4.提供图片或网站显示的学习进度,证明学习的过程
5.写一篇不少于1000字的学习笔记,谈一下学习的体会和收获。
第一周笔记:
Python网络爬虫与信息提取:
内容分为:
Requests:自动爬取HTML页面自动网络请求提交
Robots.txt:网络爬虫排除标准
Beautiful Soup:解析HTML页面
Projects:实战项目A/B
Re:正则表达式详解提取页面关键信息
Scrapy:网络爬虫原理介绍,专业爬虫框架介绍
用管理员身份运行cm,执行pip install requests;
Requests库的2个重要对象:request,response,response对象包含爬虫返回的内容了解及使用。
HTTP协议及Requests库方法:
Requests库的7个主要方法:
requests.request():构造一个请求,支撑以下各方法的基础方法
requests.get():获取HTML网页的主要方法,对应HTTP的GET
requests.head():获取HTML网页头信息的方法,对应于HTTP的HEAD
requests.post():向HTML网页提交POST请求的方法,对应于HTTP的POST
requests.put():向HTML网页提交PUT请求的方法,对应于HTTP的PUT
requests.patch():向HTML网页提交局部修改请求,对应于HTTP的PATCH
requests.delete():向HTML页面提交删除请求,对应于HTTP的DELETE
第二周笔记:
对BeautifulSoup库进行安装,以管理员运行cmd,执行pip install beautifulsoup4.
Beautifulsoup是解析,边历,维护“标签数”的功能库,beautifulsoup类的基本元素:
Tag(标签,最基本的信息组织单元,分别用<>和</>标明开头和结尾。任何存在于HTML语法中的标签都可以用soup.<tag>访问获得,当HTML文档中存在多个相同<tag>对应内容时,soup.<tag>返回第一个。);
Attributes(标签的属性,字典的形式组织,格式:<tag>.attrs。一个<tag>可以有0个或多个属性,字典类型);
Name(标签的名字,<p>...</p>的名字是‘p’,格式:<tag>.name。每个<tag>都有自己的名字,通过<tag>.name获取,字符串类型);
NavigableString(标签内非属性字符串,<>...</>中字符串,格式:<tag>.string。可以跨越多个层次);
Comment(标签内字符串的注释部分,一种特殊的Comment类型);
基于bs4库的HTML内容遍历:
回顾HTML,<>...</>构成了所属关系,形成了标签的树形结构;
标签树的下行遍历:
.contents:子节点的列表,将<tag>所有儿子节点存入列表。
.children:子节点的选代类型,与.contents类似,用于循环遍历儿子节点。
.descendants:子孙节点的选代类型,包含所有子孙节点,用于循环遍历。
Beautifulsoup类型是标签树的根节点
标签树的上行遍历:
.parent:节点的父亲标签;
.parents:节点先辈标签的选代类型,用于循环遍历先辈节点;
遍历所有先辈节点,包括soup本身,所以要区别判断;
标签树的平行遍历:
.next_sibling:返回按照HTML文本顺序的下一个平行节点标签
.previous_sibling:返回按照HTML文本顺序的上一个平行节点标签
.next_siblings:选代类型,返回按照HTML文本顺序的后续所有平行节点标签
.previous_siblings:选代类型,返回按照HTML文本顺序的前续所有平行节点标签
平行遍历发生在同一个父节点下的各节点间;
第三周:
Re库:
正则表达式:是用来简洁表达一组字符串的表达式;是一种通用的字符串表达框架;进一步,正则表达式是一种针对字符串表达“简洁”和“特征”思想的工具,可以用来判断某字符串的特征归属。
对Re库的主要功能函数(search、match、findall、finditer、sub)进行了解和使用,Re库的函数式法为一次性操作,还有一种为面向对象法,通过compile生成的regex对象。
第四周:
应用Scrapy爬虫框架主要是编写配置型代码:
进入工程目录,执行scrapy genapider demo pyth
该命令作用:
(1)生成一个名称为demo的spider
(2)在spiders目录下增加代码文件demo.py(该命令仅用于生成demo.py,该文件也可以手工生成)
运行爬虫,获取网页命令:scrapy crawl demo
yield关键字的使用:
包含yield语句的函数是一个生成器,生成器每次产生一个值(yield),函数被冻结,被唤醒后再产生一个值,生成器是一个不断产生值得函数。
python第三次作业-mooc笔记的更多相关文章
- 第三次作业-MOOC学习笔记:Python网络爬虫与信息提取
1.注册中国大学MOOC 2.选择北京理工大学嵩天老师的<Python网络爬虫与信息提取>MOOC课程 3.学习完成第0周至第4周的课程内容,并完成各周作业 第一周 Requests库的爬 ...
- python第三次作业——叶耀宗
作业1 import random#引入随机数模块xing=["小白","小黄","小王","小陈","小绿& ...
- python 第三次作业
习题1: **1.初始化一个数据集,包括5-10位同学的成绩数据(数据类型不限),数据格式如下: **学号 姓名 Java C语言 Python 2017XXXX 小白 87 68 92 2017XX ...
- 2003031121-浦娟-python数据分析第三周作业-第一次作业
项目 内容 课程班级博客链接 https://edu.cnblogs.com/campus/pexy/20sj 作业链接 https://edu.cnblogs.com/campus/pexy/20s ...
- Python基础 小白[7天]入门笔记
笔记来源 Day-1 基础知识(注释.输入.输出.循环.数据类型.随机数) #-*- codeing = utf-8 -*- #@Time : 2020/7/11 11:38 #@Author : H ...
- 第三周作业、实时操作系统µC/OS介绍及其它内容
作业要求 见<实时控制软件设计>第三周作业 1 阅读笔记--µC/OS 1.1 基本介绍 µC/OS是由Micrium公司研发的实时操作系统,以µC/OS-II或µC/OS-III为内核, ...
- Python编程从入门到实践笔记——类
Python编程从入门到实践笔记——类 #coding=gbk #Python编程从入门到实践笔记——类 #9.1创建和使用类 #1.创建Dog类 class Dog():#类名首字母大写 " ...
- Java第三次作业——面向对象基础(封装)
Java第三次作业--面向对象基础(封装) (一)学习总结 1.什么是面向对象的封装性,Java中是如何实现封装性的?试举例说明. 封装性 封装性是面向对象的方法所应遵循的一个重要原则,它有两个含义: ...
- Python 日期时间处理模块学习笔记
来自:标点符的<Python 日期时间处理模块学习笔记> Python的时间处理模块在日常的使用中用的不是非常的多,但是使用的时候基本上都是要查资料,还是有些麻烦的,梳理下,便于以后方便的 ...
随机推荐
- cesium 圆圈警戒扫描(附源码下载)
前言 cesium 官网的api文档介绍地址cesium官网api,里面详细的介绍 cesium 各个类的介绍,还有就是在线例子:cesium 官网在线例子,这个也是学习 cesium 的好素材. 内 ...
- English:2019100401_Suffix"ery"
Ax_introduction source a Frech mean to "state,quality,act,place where etc" 1)After the ver ...
- 项目中遇到的问题:IDEA maven项目报错:程序包com.sun.image.codec.jpeg不存在
错误截图: 解决方法:在pom.xml文件中间加上以下代码: 代码: <plugin> <groupId>org.apache.maven.plugins</groupI ...
- 重启宝塔面板后提示-ModuleNotFoundError: No module named 'geventwebsocket'
背景: 因服务器部署了flask项目,安装了python3,故重启宝塔面板报错 [Traceback (most recent call last): File , in load_class mod ...
- Docker-compose安装和应用
安装 1.为什么要使用docker-compose? 使用 Docker Compose 可以轻松.高效的管理容器,它是一个用于定义和运行多容器 Docker 的应用程序工具 2.其他前置条件需要 ...
- 使用hutool进行二维码制作
2.在IDEA中使用代码块生成二维码
- linux上安装jenkins过程
最近在学到jenkins分布式构建时,需要一台部署jenkins的主机服务器master,自己用的win10作为slave,所以我想在虚拟机上先部署jenkins. centos还是ubuntu呢,算 ...
- 《DevOps实践:驭DevOps之力强化技术栈并优化IT运行》
DevOps实践:驭DevOps之力强化技术栈并优化IT运行 主旨 这本书并非坐而论道,而是介绍了DevOps全流程中的许多实践,以及相应工具的运用.虽然随着时代的推移,工具将来可能会过时,但是这些实 ...
- 记一次排查jacoco的过程:java.lang.NoSuchMethodException:ApplyOrderdetail.get$jacocoData()
一.事件: 公司BA今日在st2环境提测试单,添加产品时候一直过不去,找我帮忙看,因为关系比较熟,正好也不是非常忙,我就帮忙定位了下.首先,我在生产环境重现了下,没有问题,在dev环境重现,也没有问题 ...
- freemarker从入门到精通
目录 一:概述 二:Freemarker的Helloworld 三:freemarker模板语法 1.访问map中的key 2.访问POJO中的属性 3.取集合中的数据 4.判断 5.日期 6.Nul ...