
利用BeautifulSoup抓取新浪网页新闻的内容
第一次写的小爬虫,python确实功能很强大,二十来行的代码抓取内容并存储为一个txt文本
直接上代码
#coding = 'utf-8'

import requests

from bs4 import BeautifulSoup

import sys

reload(sys)

sys.setdefaultencoding("utf-8")

#抓取web页面

url = "http://news.sina.com.cn/china/"

res = requests.get(url)

res.encoding = 'utf-8'

#放进soup里面进行网页内容剖析

soup = BeautifulSoup(res.text, "html.parser")

elements = soup.select('.news-item')

#抓取需要的内容并且放入文件中

#抓取的内容有时间,内容文本,以及内容的链接

fname = "F:/asdf666.txt"

try:

    f = open(fname, 'w')

    for element in elements:

        if len(element.select('h2')) > 0:

            f.write(element.select('.time')[0].text)

            f.write(element.select('h2')[0].text)

            f.write(element.select('a')[0]['href'])

            f.write('\n\n')

    f.close()

except Exception, e:

    print e

else:

    pass

finally:

    pass
因为这只第一次做的小爬虫,功能很简单也很单一,就是直接抓取新闻页面的部分新闻
然后抓取新闻的时间和超链接
然后按照新闻的顺序整合起来,并且放进文本文件中去存储起来
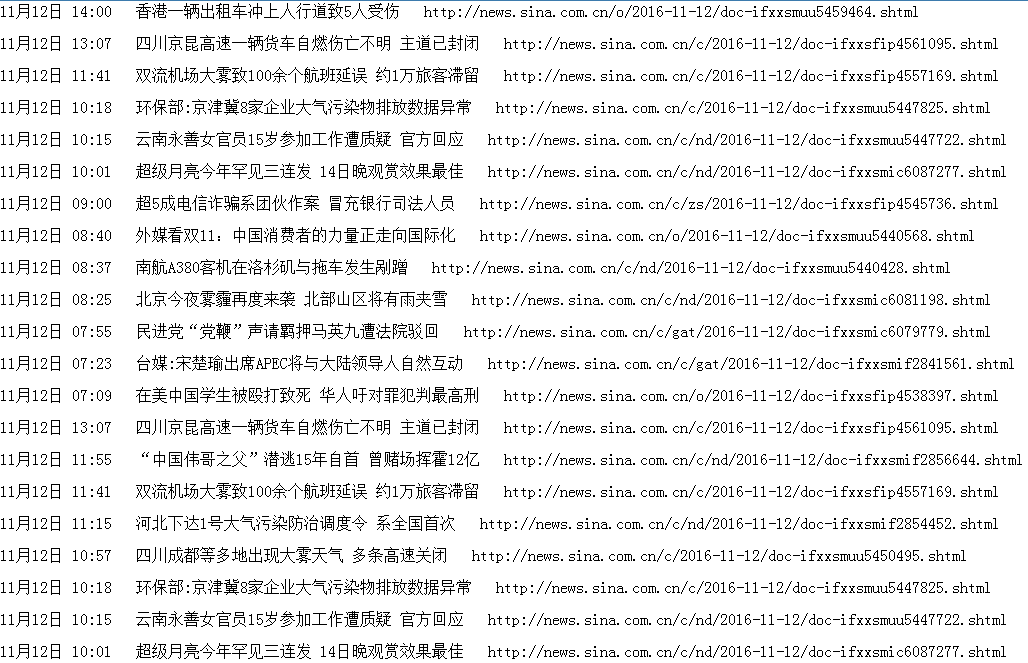
截取一下效果图,效果很简单,就是一条一条的记录,时间,新闻内容,新闻链接(因为是今天才写的,所以新闻都是今天的)
利用BeautifulSoup抓取新浪网页新闻的内容的更多相关文章
- [Python爬虫] :Selenium +phantomjs 利用 pyquery抓取脚本链接对应的内容
抓取上面对应链接的网页的文章的内容 ele = element.attr("onclick") self.driver.execute_script(ele) sub_seleni ...
- Python 利用 BeautifulSoup 爬取网站获取新闻流
0. 引言 介绍下 Python 用 Beautiful Soup 周期性爬取 xxx 网站获取新闻流: 图 1 项目介绍 1. 开发环境 Python: 3.6.3 BeautifulSoup: ...
- BeautifulSoup抓取列表页锚文本
素闻BeautifulSoup提取效率低,艾玛,第一印象果然是很要命的,反正比Re 和 Lxml 是要慢的,不过就无奈Re的正则折腾来折腾去,没写出来,Lxml 的 Xpath 又用得不好. 不过就这 ...
- scrapy抓取中国新闻网新闻
目标说明 利用scrapy抓取中新网新闻,关于自然灾害滑坡的全部国内新闻:要求主题为滑坡类新闻,包含灾害造成的经济损失等相关内容,并结合textrank算法,得到每篇新闻的关键词,便于后续文本挖掘分析 ...
- python实现一个栏目的分页抓取列表页抓取
python实现一个栏目的分页抓取列表页抓取 #!/usr/bin/env python # coding=utf-8 import requests from bs4 import Beautifu ...
- Python爬虫实战八之利用Selenium抓取淘宝匿名旺旺
更新 其实本文的初衷是为了获取淘宝的非匿名旺旺,在淘宝详情页的最下方有相关评论,含有非匿名旺旺号,快一年了淘宝都没有修复这个. 可就在今天,淘宝把所有的账号设置成了匿名显示,SO,获取非匿名旺旺号已经 ...
- 利用Crowbar抓取网页异步加载的内容 [Python俱乐部]
利用Crowbar抓取网页异步加载的内容 [Python俱乐部] 利用Crowbar抓取网页异步加载的内容 在做 Web 信息提取.数据挖掘的过程中,一个关键步骤就是网页源代码的获取.但是出于各种原因 ...
- 利用Fiddler抓取websocket包
一.利用fiddler抓取websockt包 打开Fiddler,点开菜单栏的Rules,选择Customize Rules... 这时会打开CustomRules.js文件,在class Handl ...
- [Python爬虫] 之二十八:Selenium +phantomjs 利用 pyquery抓取网站排名信息
一.介绍 本例子用Selenium +phantomjs爬取中文网站总排名(http://top.chinaz.com/all/index.html,http://top.chinaz.com/han ...
随机推荐
- windows2003 IIS6.0右键属性没有asp.net选项卡的解决办法
windows2003 IIS6.0右键属性没有asp.net选项卡的解决办法 1,如果是只安装了.net framework 1.1 在iis中是不显示那个选项卡的.默认就会支持asp.net1.1 ...
- Elasticsearch mysql 增量同步 三表联合 脚本
在上一篇中简略的说了一下es同步数据脚本的大致情况,但是实际情况里肯定不会像上一篇里面的脚本那么简单.比如目前我就有三张表,两张实体表,一张关联表.大致实现如下: bin目录建立一个statefile ...
- JAVA源码走读(一) HashMap与ArrayList
HashMap 一.HashMap基本概念: HashMap是基于哈希表的Map接口的实现.此实现提供所有可选的映射操作,并允许使用null值和null键.此类不保证映射的顺序,特别是它不保证该顺序恒 ...
- InvocationException: GraphViz's executables not found
当我在visualize决策树,运行以下代码时,报错: InvocationException: GraphViz's executables not found import pydotplus f ...
- boost multi_index
/** boost 多索引容器的一般使用 这里使用google 的gmock 库来验证对boost 多索引模板的使用,并验证. 这里是手敲的,可能会有一些字符敲错的情况,编译错误的放,修改一下,同时链 ...
- [转载]反无人机企业DroneShield利用声音识别侦测无人机
原文:http://www.cnbeta.com/articles/495071.htm 无人机产业正在蓬勃发展,受益的不仅仅是那些生产小型飞行设备的企业.专家估计仅在澳大利亚就有5万架商用无人机以及 ...
- HttpContextBase转换成HttpContext对象
有以下方法: 主要是方式就是通过context获取HttpApplication,然后通过Application获取相应的HttpContext ①HttpContext context=HttpCo ...
- C/C++二维数组分配内存
//C++方式 double **Q=new double*[row]; //初始化Q矩阵 for(int i=0;i<row;++i) Q[i]=new double[POS_NUM]( ...
- 5、IMS网元
1.会话管理和路由类(call session control function,呼叫会话控制功能) (1)代理呼叫会话控制功能P-CSCF 是IMS中与用户的第一个连接点,提供”代理(proxy)“ ...
- Jmeter beanshell 生成手机号加密签名
首先自己写一个根据手机号生成加密字符串的函数,并且导出为Jar包,函数具体内容省略,网上有很多 将Jar包放到Jmeter lib\ext目录下面,然后在user.properties里面把路径加进去 ...