
爬取 豆瓣电影Top250
目标
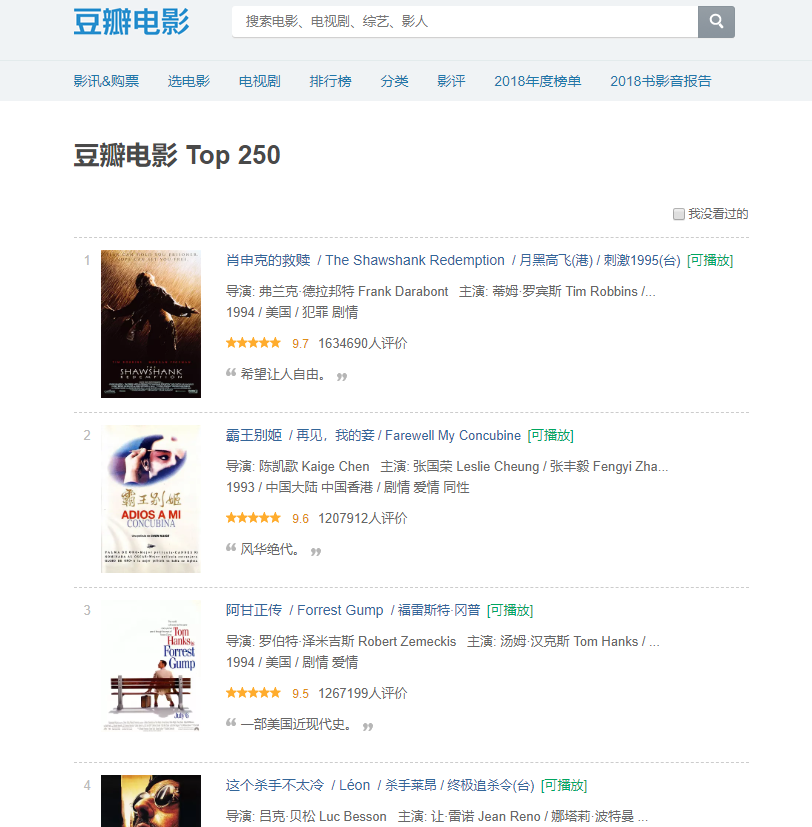
学习爬虫,爬豆瓣榜单,获取爬取静态页面信息的能力
豆瓣电影 Top 250 https://movie.douban.com/top250
代码
import requests

from bs4 import BeautifulSoup

def getHTMLText(url):

    try:

        r = requests.get(url,timeout=30)

        r.raise_for_status()

        r.encoding = r.apparent_encoding

        return r.text

    except:

        return '产生异常'

if __name__ == '__main__':

    i = 0

    urls = ['https://movie.douban.com/top250?start='+str(n)+'&filter=' for n in range(0,250,25)]

    for url in urls:

        r = getHTMLText(url)

        soup = BeautifulSoup(r,'html.parser')

        titles = soup.select('div.hd a')

        rates = soup.select('span.rating_num')

        pics = soup.select('img[width="100"]')

        for title,rate,pic in zip(titles,rates,pics):

            data={'title':list(title.stripped_strings),

                  'rate':rate.get_text(),

                  'pic':pic.get('src')}

            i+=1

            fileName=str(i)+'_'+data['title'][0]+' '+data['rate']+'分.jpg'

            pic1 = requests.get(data['pic'])

            with open('G:\\test\\'+fileName,'wb') as photo:

                photo.write(pic1.content)

            print(data)
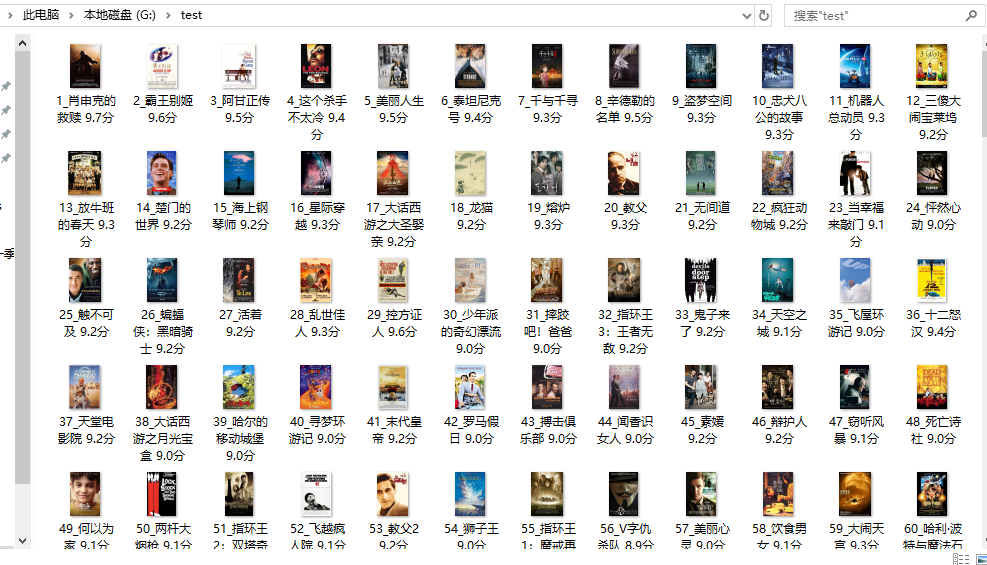
爬取结果
爬取 豆瓣电影Top250的更多相关文章
- urllib+BeautifulSoup无登录模式爬取豆瓣电影Top250
对于简单的爬虫任务,尤其对于初学者,urllib+BeautifulSoup足以满足大部分的任务. 1.urllib是Python3自带的库,不需要安装,但是BeautifulSoup却是需要安装的. ...
- python2.7爬取豆瓣电影top250并写入到TXT,Excel,MySQL数据库
python2.7爬取豆瓣电影top250并分别写入到TXT,Excel,MySQL数据库 1.任务 爬取豆瓣电影top250 以txt文件保存 以Excel文档保存 将数据录入数据库 2.分析 电影 ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
- scrapy爬取豆瓣电影top250
# -*- coding: utf-8 -*- # scrapy爬取豆瓣电影top250 import scrapy from douban.items import DoubanItem class ...
- 一起学爬虫——通过爬取豆瓣电影top250学习requests库的使用
学习一门技术最快的方式是做项目,在做项目的过程中对相关的技术查漏补缺. 本文通过爬取豆瓣top250电影学习python requests的使用. 1.准备工作 在pycharm中安装request库 ...
- python 爬虫&爬取豆瓣电影top250
爬取豆瓣电影top250from urllib.request import * #导入所有的request,urllib相当于一个文件夹,用到它里面的方法requestfrom lxml impor ...
- 【转】爬取豆瓣电影top250提取电影分类进行数据分析
一.爬取网页,获取需要内容 我们今天要爬取的是豆瓣电影top250页面如下所示: 我们需要的是里面的电影分类,通过查看源代码观察可以分析出我们需要的东西.直接进入主题吧! 知道我们需要的内容在哪里了, ...
- Scrapy中用xpath/css爬取豆瓣电影Top250:解决403HTTP status code is not handled or not allowed
好吧,我又开始折腾豆瓣电影top250了,只是想试试各种方法,看看哪一种的方法效率是最好的,一直进行到这一步才知道 scrapy的强大,尤其是和selector结合之后,速度飞起.... 下面我就采用 ...
- Python爬虫入门:爬取豆瓣电影TOP250
一个很简单的爬虫. 从这里学习的,解释的挺好的:https://xlzd.me/2015/12/16/python-crawler-03 分享写这个代码用到了的学习的链接: BeautifulSoup ...
- Scrapy爬虫(4)爬取豆瓣电影Top250图片
在用Python的urllib和BeautifulSoup写过了很多爬虫之后,本人决定尝试著名的Python爬虫框架--Scrapy. 本次分享将详细讲述如何利用Scrapy来下载豆瓣电影To ...
随机推荐
- LeetCode24-Swap_Pairs
swapPairs public ListNode swapPairs(ListNode head) { if(head==null ||head.next==null) return head; L ...
- Golang调用Python
https://yq.aliyun.com/articles/117329 Python是时髦的机器学习御用开发语言,Golang是大红大紫的新时代后端开发语言.Python很适合让搞算法的写写模型, ...
- zzPony.ai 的基础架构挑战与实践
本次分享将从以下几个方面介绍: Pony.ai 基础架构做什么 车载系统 仿真平台 数据基础架构 其他基础架构 1. Pony.ai 基础架构 首先给大家介绍一下 Pony.ai 的基础架构团队做什么 ...
- 论文阅读笔记六十:Squeeze-and-Excitation Networks(SENet CVPR2017)
论文原址:https://arxiv.org/abs/1709.01507 github:https://github.com/hujie-frank/SENet 摘要 卷积网络的关键构件是卷积操作, ...
- java 类的继承
package testpacknm; import java.util.Scanner; import testpacknm.testcnm; class Another { String name ...
- cerely-分布式异步任务队列
Celery 是一个强大的 分布式任务队列 的 异步处理框架,它可以让任务的执行完全脱离主程序,甚至可以被分配到其他主机上运行.我们通常使用它来实现异步任务(async task)和定时任务(cron ...
- ASP.NET Core MVC 中的 Model 模型
ASP.NET Core MVC 中的 Model 我们希望最终从 Student 数据库表中查询特定的学生详细信息并显示在网页上,如下所示. MVC 中的模型包含一组表示数据的类和管理该数据的逻辑. ...
- icon发展史速览
icon 发展史 img 多张图片占用多个请求,想办法减少请求,合并图片,image sprite background-position /* 使用background-position来定位图标 ...
- MACbook安装WIN7后亮度调节的办法
MACbook安装WIN7后亮度调节的办法:1.按WIN+X打开移动中心,第一个就是亮度调节.或者右击托盘区的电池,选择移动中心也可以.2.右击托盘区域的电池,选择电源管理,在界面中调节亮度. 3. ...
- [LeetCode] 505. The Maze II 迷宫之二
There is a ball in a maze with empty spaces and walls. The ball can go through empty spaces by rolli ...