
python爬虫之Splash使用初体验
Splash是什么:
Splash是一个Javascript渲染服务。它是一个实现了HTTP API的轻量级浏览器,Splash是用Python实现的,同时使用Twisted和QT。Twisted(QT)用来让服务具有异步处理能力,以发挥webkit的并发能力。
为什么要有Splash:
为了更加有效的制作网页爬虫,由于目前很多的网页通过javascript模式进行交互,简单的爬取网页模式无法胜任javascript页面的生成和ajax网页的爬取,同时通过分析连接请求的方式来落实局部连接数据请求,相对比较复杂,尤其是对带有特定时间戳算法的页面,分析难度较大,效率不高。而通过调用浏览器模拟页面动作模式,需要使用浏览器,无法实现异步和大规模爬取需求。鉴于上述理由Splash也就有了用武之地。一个页面渲染服务器,返回渲染后的页面,便于爬取,便于规模应用。
安装条件:
操作系统要求:
Docker for Windows requires Windows 10 Pro or Enterprise version 10586, or Windows server 2016 RTM to run
安装:
首先点击下面链接,从docker官网上下载windows下的docker进行安装,不过请注意系统要求是**windows1064位 pro及以上版本或者教育版
官网下载:https://store.docker.com/editions/community/docker-ce-desktop-windows
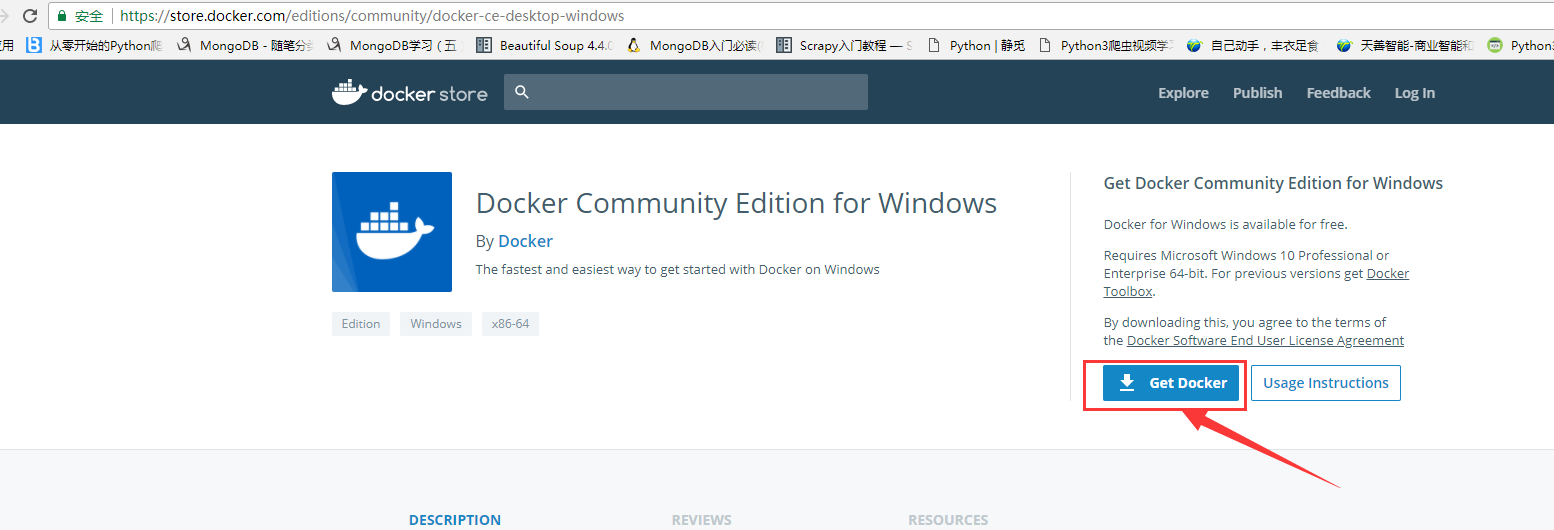
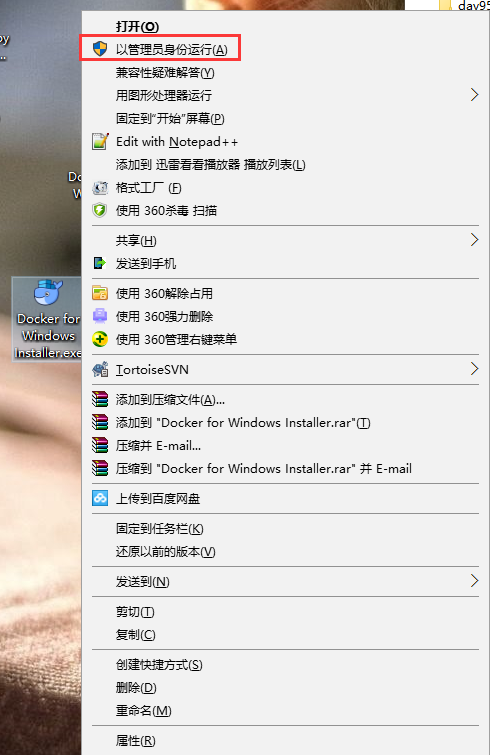
安装包下载完成后以管理员身份运行。
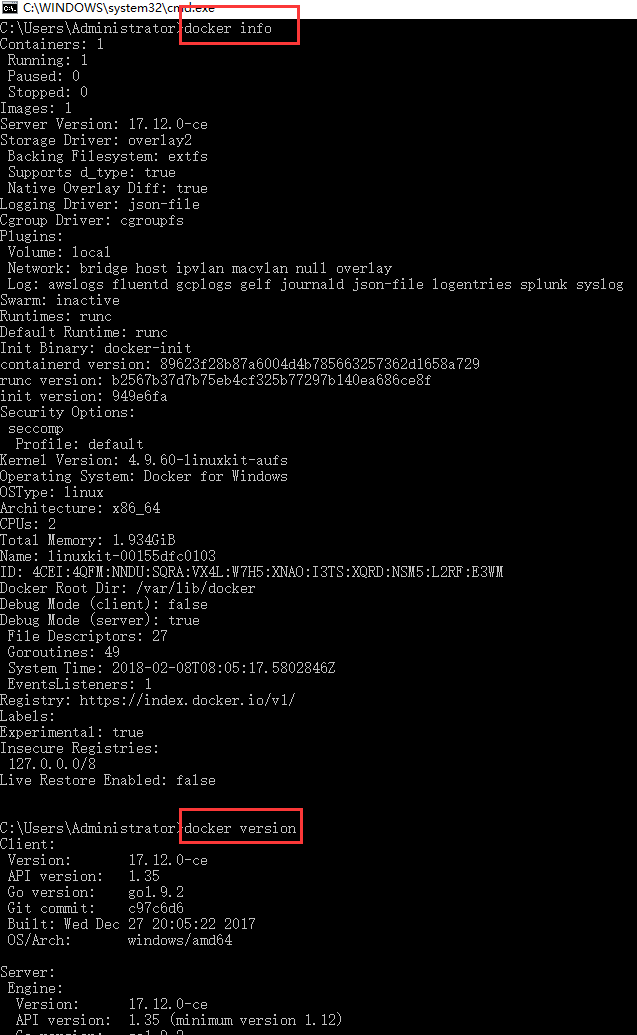
查看信息:
#docker info
#docker version
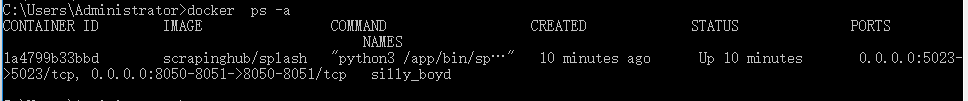
查看启动的容器
在docker中下载安装Splash镜像,并安装
#docker pull scrapinghub/splash
启动splash服务
#启动splash服务,并通过http,https,telnet提供服务

#通常一般使用http模式 ,可以只启动一个8050就好

#Splash 将运行在 0.0.0.0 at ports 8050 (http), 8051 (https) and 5023 (telnet).

docker run -p 5023:5023 -p 8050:8050 -p 8051:8051 scrapinghub/splash
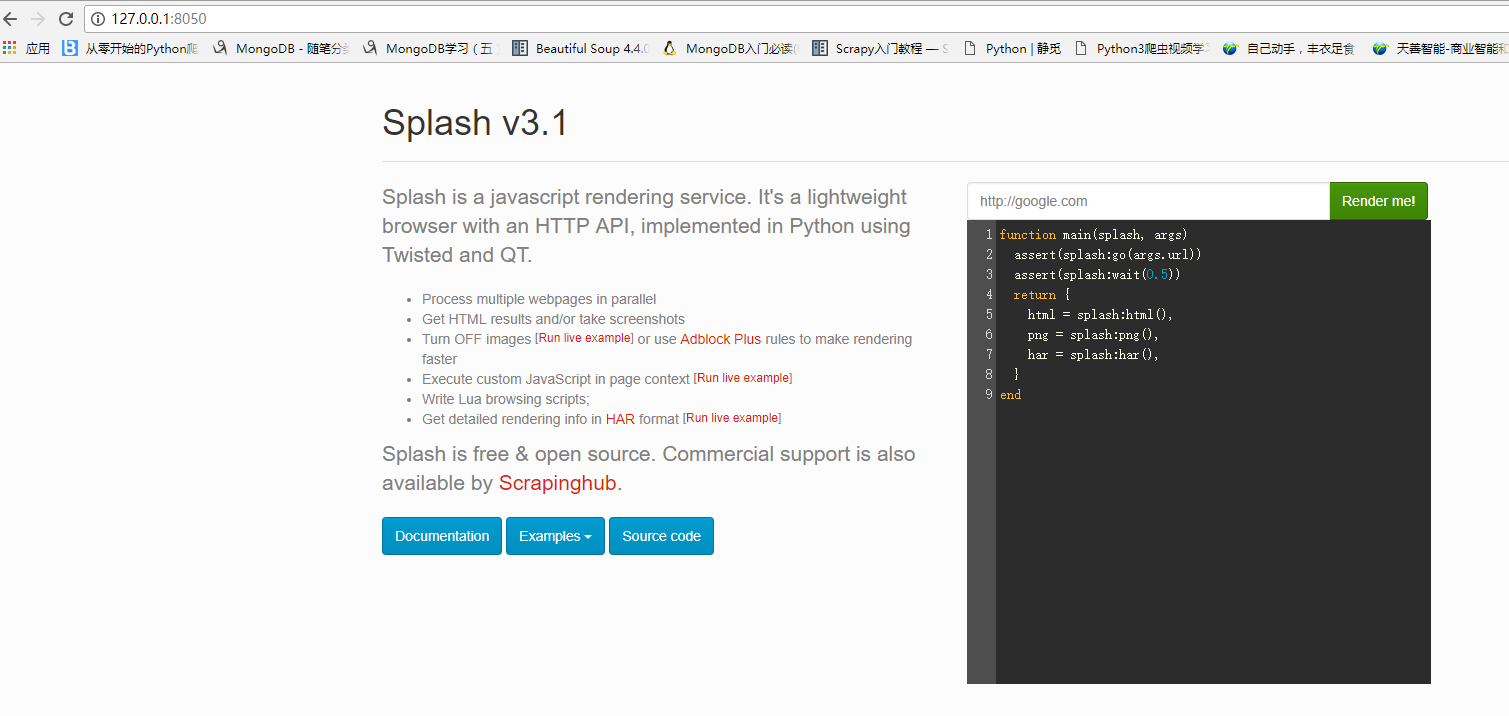
参考链接:https://www.jianshu.com/p/4052926bc12c
Centos7安装:
准备工作
删除原来的docker包,一般情况下不用,保险起见,最好按流程走一下
$ sudo yum -y remove docker docker-common container-selinux删除docker的selinux 同上
$ sudo yum -y remove docker-selinux开始安装了
使用yum 安装yum-utils
$ sudo yum install -y yum-utils增加docker源
$ sudo yum-config-manager \

--add-repo \

https://download.docker.com/linux/centos/docker-ce.repo
查看docker源是否可用
$ sudo yum-config-manager --enable docker-ce-edge

enable 为True就行
创建缓存
$ sudo yum makecache fast使用yum安装
docker现在分为两个版本 EE(企业版) CE(社区版),这里我们选择CE版.
$ sudo yum install docker-ce启动docker
$ sudo systemctl start docker启动一个helloword
$ sudo docker run hello-world这条命令会下载一个测试镜像,并启动一个容器,输出hello world 并退出,如果正常说明docker安装成功.
参考地址:https://www.cnblogs.com/colder219/p/6679255.html
使用
1、配置splash服务(以下操作全部在settings.py):
1)添加splash服务器地址:
SPLASH_URL = 'http://localhost:8050'
2)将splash middleware添加到DOWNLOADER_MIDDLEWARE中:
DOWNLOADER_MIDDLEWARES = {

'scrapy_splash.SplashCookiesMiddleware': 723,

'scrapy_splash.SplashMiddleware': 725,

'scrapy.downloadermiddlewares.httpcompression.HttpCompressionMiddleware': 810,

}
3)Enable SplashDeduplicateArgsMiddleware:
SPIDER_MIDDLEWARES = {

'scrapy_splash.SplashDeduplicateArgsMiddleware': 100,

}
4)Set a custom DUPEFILTER_CLASS:
DUPEFILTER_CLASS = 'scrapy_splash.SplashAwareDupeFilter'
5)a custom cache storage backend:
HTTPCACHE_STORAGE = 'scrapy_splash.SplashAwareFSCacheStorage'
案例:
import scrapy

from scrapy_splash import SplashRequest

class TbtaobaoSpider(scrapy.Spider):

    name = "tbtaobao"

    allowed_domains = ["www.taobao.com"]

    start_urls = ['https://s.taobao.com/search?q=坚果&s=880&sort=sale-desc']

    def start_requests(self):

        for url in self.start_urls:

            # yield Request(url,dont_filter=True)

            yield SplashRequest(url, self.parse, args={'wait': 0.5})

    def parse(self, response):

        print(response.text)
python爬虫之Splash使用初体验的更多相关文章
- python第十七天-----Django初体验
Django是一个MTV框架 M:models(数据库) T:templates(放置html模版) V:views(处理用户请求) 那么传说中的MVC框架又是什么呢? M:models(数据库) V ...
- [转]Python爬虫框架--pyspider初体验
标签: python爬虫pyspider 2015-09-05 10:57 9752人阅读 评论(0) 收藏 举报 分类: Python(8) 版权声明:本文为博主原创文章,未经博主允许不得转载. ...
- 【Python3爬虫】爬取美女图新姿势--Redis分布式爬虫初体验
一.写在前面 之前写的爬虫都是单机爬虫,还没有尝试过分布式爬虫,这次就是一个分布式爬虫的初体验.所谓分布式爬虫,就是要用多台电脑同时爬取数据,相比于单机爬虫,分布式爬虫的爬取速度更快,也能更好地应对I ...
- 【Python3爬虫】学习分布式爬虫第一步--Redis分布式爬虫初体验
一.写在前面 之前写的爬虫都是单机爬虫,还没有尝试过分布式爬虫,这次就是一个分布式爬虫的初体验.所谓分布式爬虫,就是要用多台电脑同时爬取数据,相比于单机爬虫,分布式爬虫的爬取速度更快,也能更好地应对I ...
- 【Go 入门学习】第一篇关于 Go 的博客--Go 爬虫初体验
一.写在前面 其实早就该写这一篇博客了,为什么一直没有写呢?还不是因为忙不过来(实际上只是因为太懒了).不过好了,现在终于要开始写这一篇博客了.在看这篇博客之前,可能需要你对 Go 这门语言有些基本的 ...
- Python导出Excel为Lua/Json/Xml实例教程(二):xlrd初体验
Python导出Excel为Lua/Json/Xml实例教程(二):xlrd初体验 相关链接: Python导出Excel为Lua/Json/Xml实例教程(一):初识Python Python导出E ...
- python窗体——pyqt初体验
连续两周留作业要写ftp的作业,从第一周就想实现一个窗体版本的,但是时间实在太短,qt零基础选手表示压力很大,幸好又延长了一周时间,所以也就有了今天这篇文章...只是为了介绍一些速成的方法,还有初学者 ...
- ipython及Python初体验
阅读目录: Python环境体验 Python编辑器 ipython安装 Python提示符 Python初体验 print和变量 变量操作 内建函数:方法 数学运算:简单算术.随机数 关于模块 一. ...
- Python基础学习参考(一):python初体验
一.前期准备 对于python的学习,首先的有一个硬件电脑,软件python的运行环境.说了一句废话,对于很多初学者而言,安装运行环境配置环境变量的什么的各种头疼,常常在第一步就被卡死了,对于pyth ...
随机推荐
- centos7下安装docker(18docker日志---docker logs)
在微服务架构中,由于容器的数量众多以及快速变化的特性使得记录日志和监控变得越来越重要,考虑到容器的短暂和不固定周期,当我们需要排查问题的时候容器可能不在了.因此,一套集中式的日志管理系统是生产环境中不 ...
- javascript中数组化的一般见解
javascript中数组化的一般见解,数组化浏览器中存在许多类数组对象,往往对类数组操作比较麻烦,没有数组那些非常方便的方法,在这种情况下,就有了数组化方法. 数组化的一般方法 1.第一种也是我们最 ...
- 已使用.netframework,version=v4.6.1 而不是目标框架netcoreapp,version=v2.1 还原包,此包可能与项目不完全兼容
已使用.netframework,version=v4.6.1 而不是目标框架netcoreapp,version=v2.1 还原包,此包可能与项目不完全兼容 NU1202: 包 System.Run ...
- RPC通信原理(未完,先睡觉)
一 背景 OpenStack 各组件之间是通过 REST 接口进行相互通信,比如Nova.Cinder.Neutron.Glance直间的通信都是通过keystone获取目标的endpoint,即ap ...
- Docker镜像存储-overlayfs
一.概述 Docker中的镜像采用分层构建设计,每个层可以称之为“layer”,这些layer被存放在了/var/lib/docker/<storage-driver>/目录下,这里的st ...
- CSS选择器之基本选择器总结
一.元素选择器(所有浏览器支持) 元素选择器(标签名选择器)其实就是文档的元素,如html,body,p,div等等, 下面例子中选择了span元素,并设置了字体颜色为红色. <body> ...
- 自己制作Chrome便携版实现多版本共存
本文只针对Windows下的Chrome浏览器的使用. 有时候我们需要使用老版本Chrome,或者仅仅体验一下最新版. 上古时代有IETester用来测试多个IE版本,和本机的IE不冲突. Chrom ...
- 分布式系统消息中间件——RabbitMQ的使用进阶篇
分布式系统消息中间件--RabbitMQ的使用进阶篇 前言 上一篇文章 (https://www.cnblogs.com/hunternet/p/9668851.html) 简单总结了分布式系 ...
- logstash grok内置规则
logstash grok 内置正则 https://github.com/elastic/logstash/blob/v1.4.2/patterns/grok-patterns USERNAME [ ...
- Vue(二)基础
01-vue的起步 1.引包 a) 直接下载,并用<script>标签引入 b) CDN方式引入: <script src="https://cdn.bootcss.com ...