
用 CNTK 搞深度学习 (一) 入门
Computational Network Toolkit (CNTK) 是微软出品的开源深度学习工具包。本文介绍CNTK的基本内容,如何写CNTK的网络定义语言,以及跑通一个简单的例子。
根据微软开发者的描述,CNTK的性能比Caffe,Theano, TensoFlow等主流工具都要强。它支持CPU和GPU模式,所以没有GPU,或者神经网络比较小的实验,直接用CPU版的CNTK跑就行了。 其开源主页在 https://github.com/Microsoft/CNTK 它把神经网络描述成一个有向图的结构,叶子节点代表输入或者网络参数,其他节点计算步骤。 它支持卷积神经网络和递归神经网络。 由于CNTK刚推出不久,大众教程估计不多,而且bug估计也不少。我学习的时候,主要参考三个资料:
1 官方入门教程 https://github.com/Microsoft/CNTK/wiki/Tutorial 本文也主要以这里的教程为例
2 官方论坛 https://github.com/Microsoft/CNTK/issues
3 官方论文 http://research.microsoft.com/pubs/226641/CNTKBook-20160217..pdf 这个有150页,我是当作字典来用,遇到问题的时候就在里面搜
安装CNTK: https://github.com/Microsoft/CNTK/wiki/CNTK-Binary-Download-and-Configuration 去这个页面找符合自己系统的版本。 我是Windows用户,CNTK有编译好的CPU和GPU版本。由于本人的显卡不是英伟达的,所以无奈只能用CPU版凑合用用。已经编译好的包最方便了,解压,然后把目录(类似%...%、CNTK-2016-02-08-Windows-64bit-CPU-Only\cntk\cntk)添加到PATH变量中就行了。 有条件的人也可以自己编译源代码,稍微麻烦一些,各种依赖关系,好处是源码更新的比较快,CNTK一大特点就是目前各种小bug比较多,比如我现在用的编译好的包还是两个月前发布的,已经自己填了好多坑了。
安装好CNTK之后,运行一个程序,就是一个简单的命令行: CNTK configFile=your_config_file , 其中,your_config_file 是网络的定义文件,大概长这样:
command=Train:Test

Train=[
        action="train"

        NDLNetworkBuilder = [

        ...

        ]

        SGD = [

        ...

        ]

        reader = [

        ...
    ]

]
Test=[ ... ]
运行的入口就是command命令,command后面接需要依次运行的模块,用冒号分开。 每个模块里面需要定义的事情比较类似,主要是定义输入的格式,网络结构,学习算法(目前只有SGD)和参数。 在定义网络结构的时候,会指明哪些节点是优化目标,哪些是评价指标,以及哪些是输出的点。
众所周知,把神经网络的隐藏层去掉之后,输入直接连到输出层,这样就行成了一个logistics regression分类器。所以https://github.com/Microsoft/CNTK/wiki/Tutorial 这个教程就指导大家如何构建一个LR。 我这里稍微变一下,学习一下如何构建带有一层隐藏层的neural network,如下图:

定义网络结构
CNTK用网络描述语言(network description language, NDL)描述一个神经网络。 简单的说,我们要描述输入的feature,输入的label,一些参数,参数和输入之间的计算关系,以及目标节点是什么。
NDLNetworkBuilder=[

    run=ndlLR

    ndlLR=[

      # sample and label dimensions

      SDim=$dimension$

      LDim=

      features=Input(SDim, )

      labels=Input(LDim, )

      # parameters to learn

      B0 = Parameter()

      W0 = Parameter(, SDim)

      B = Parameter(LDim)

      W = Parameter(LDim, )

      # operations

      t0 = Times(W0, features)

      z0 = Plus(t0, B0)

      s0 = Sigmoid(z0)

      t = Times(W, s0)

      z = Plus(t, B)

      s = Sigmoid(z)

      LR = Logistic(labels, s)

      EP = SquareError(labels, s)

      # root nodes

      FeatureNodes=(features)

      LabelNodes=(labels)

      CriteriaNodes=(LR)

      EvalNodes=(EP)

      OutputNodes=(s,t,z,s0,W0)

    ]

  ]
features=Input(SDim, 1)     labels=Input(LDim, 1) 和 B0 = Parameter(4)  等可以想象成是在定义变量。 输入是列向量,CNTK里面的运算全是矩阵运算,所以就把输入当做只有一列的矩阵。  t0 = Times(W0, features) 是做矩阵乘法,t0把输入和权重相乘,z0 是在t0上面加了一个bias,
s0表示经过一个激活函数。 B0,W0,t0,z0,s0构成了隐层的操作,这里定义的隐层有4个节点。 t,z,s是输出层的操作,s就是输出节点的值。 框架定义好之后,还需要指定一些根节点,用来指定特殊的任务,例如 FeatureNodes=(features)  和LabelNodes=(labels)分别规定了输入和输出节点,CriteriaNodes 是训练的
时候优化的目标,EvalNodes 是在做评测的时候输出的参考值。OutputNodes 指定了需要输出到文件的节点。
设置训练算法
SGD = [

        epochSize=     #  每轮迭代使用的样例数,  = 表示使用整个训练集

        minibatchSize=25  # 训练25个样本就更新一次参数

        learningRatesPerMB=0.1                # learning rates per MB

        maxEpochs=50    #迭代50次

    ]
目前只有SGD(以及在SGD上的各种变种),可以在里面设置各种参数。
设置输入格式
reader = [

        #customDelimiter = " "

        readerType = "UCIFastReader"

        file = "Train.txt"

        miniBatchMode = "partial"

        verbosity =

        randomize = "none"

        features=[

            dim = $dimension$

            start =

        ]

        labels=[

            start = $dimension$              # skip $dimension$ elements before reading the label (i.e. the first two dimensions so we have "x1 x2 y" basically)

            dim =                           # label has  dimension

            labelType=regression

            labelMappingFile = "SimpleMapping.txt"

        ]

    ]
这也是CNTK的一个特点(吐槽点), 指定用什么方式读取数据文件。 readerType = "UCIFastReader" 指定用普通的扁平化表格的格式(一行一个样例,同一行内用空格隔开不同的数值),还有别的格式类型,例如图像格式,文本语料格式等。UCIFastReader 是将被弃用的,而且在目前最新的binary包中是有bug的 (所以说,有条件的同学尽量自己编译最新的源码)。 用官方教程里的设置直接跑回出bug,以上是我修改过的代码。 输入格式主要描述了feature是哪几列,维度是多少,label是哪几列, label的类型等等。
综上,Train这个模块就是定义了这几件事情:输入格式,网络内容,训练模式。 运行的时候也是这个步骤: 读取数据-> SGD 训练.
其他
除了Train之外的模块的流程比较类似,它们不需要再定义网络结构和训练模式,但是输入格式还是要指定的。 例如Test模块的流程是: 读取数据->计算网络->得到预测值->评估. 评估针对的是在网络结构中被定义为EvalNodes 的节点。 SquareError 只是其中的一种评估指标。如果想用别的误差函数,可以去查字典http://research.microsoft.com/pubs/226641/CNTKBook-20160217..pdf
Test=[

    action="test"

    reader=[

        readerType="UCIFastReader"

        file="Test.txt"

        features=[

            dim=

            start=

        ]

        labels=[

            start=$dimension$

            dim=

            labelDim=

        ]

    ]

]
Output模块和Test的流程基本一样,只不过最后一个不是评估,而是把属于OutputNodes的值给输出到文件。 Output模块会指定一个输出目录 outputPath = "LR.txt" , 输出的文件以“LR.txt”为前缀,再加上变量命作为文件名。例如"LR.txt.W0"。
# output the results

Output=[

    action="write"

    reader=[

        readerType="UCIFastReader"

        file="Test.txt"

        features=[

            dim=$dimension$

            start=

        ]

        labels=[

            start=

            dim=

            labelType=regression

        ]

    ]

    outputPath = "LR.txt"       # dump the output as text

]
dumpNodeInfo 用来输出参数的值。这在调试中很有用,例如去看看网络的参数是如何变化的:
dumpNodeInfo=[

        action=dumpnode

        printValues=true

    ]

####################################################################

B=LearnableParameter [,]   NeedGradient=true

 -6.67130613

 ####################################################################

EP=SquareError ( labels , s )

features=InputValue [  x  {,} ]

labels=InputValue [  x  {,} ]

LR=Logistic ( labels , s )

s=Sigmoid ( z )

t=Times ( W , features )

W=LearnableParameter [,]   NeedGradient=true

 1.23924482 1.59913719

 ####################################################################

z=Plus ( t , B )
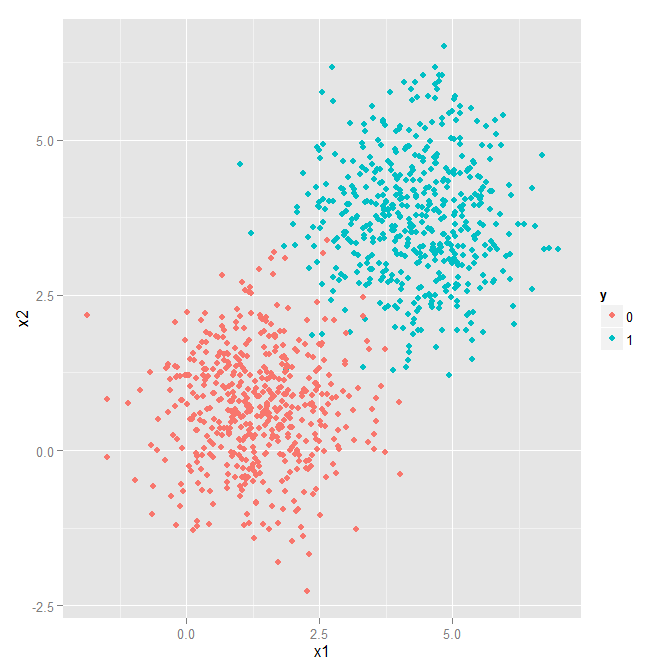
全部的代码如下。 train文件 https://github.com/Microsoft/CNTK/wiki/Tutorial/Train-3Classes.txt test 文件 https://github.com/Microsoft/CNTK/wiki/Tutorial/Test-3Classes.txt。 数据是2维的:
# Copyright (c) Microsoft. All rights reserved.

# Licensed under the MIT license. See LICENSE file in the project root for full license information.

# logistic regression cntk script -- Network Description Language

# which commands to run

command=Train:Output:dumpNodeInfo:Test

#required...

modelPath="Models/LR_reg.dnn"        # where to write the model to

deviceId=-                                # CPU

dimension=                 # input data dimensions

# training config

Train=[

    action="train"

    traceLevel =

    NDLNetworkBuilder=[

    run=ndlLR

    ndlLR=[

      # sample and label dimensions

      SDim=$dimension$

      LDim=

      features=Input(SDim, )

      labels=Input(LDim, )

      # parameters to learn

      B0 = Parameter()

      W0 = Parameter(, SDim)

      B = Parameter(LDim)

      W = Parameter(LDim, )

      # operations

      t0 = Times(W0, features)

      z0 = Plus(t0, B0)

      s0 = Sigmoid(z0)

      t = Times(W, s0)

      z = Plus(t, B)

      s = Sigmoid(z)

      LR = Logistic(labels, s)

      EP = SquareError(labels, s)

      # root nodes

      FeatureNodes=(features)

      LabelNodes=(labels)

      CriteriaNodes=(LR)

      EvalNodes=(EP)

      OutputNodes=(s,t,z,s0,W0)

    ]

  ]

    SGD = [

        epochSize=                              # = means size of the training set

        minibatchSize=

        learningRatesPerMB=0.1                # learning rates per MB

        maxEpochs=

    ]

    # parameter values for the reader

    reader = [

        #customDelimiter = " "

        readerType = "UCIFastReader"

        file = "Train.txt"

        miniBatchMode = "partial"

        verbosity =

        randomize = "none"

        features=[

            dim = $dimension$

            start =

        ]

        labels=[

            start = $dimension$              # skip $dimension$ elements before reading the label (i.e. the first two dimensions so we have "x1 x2 y" basically)

            dim =                           # label has  dimension

            labelType=regression

            labelMappingFile = "SimpleMapping.txt"

        ]

    ]

]

# test

Test=[

    action="test"

    reader=[

        readerType="UCIFastReader"

        randomize = "none"

        file="Test.txt"

        features=[

            dim=$dimension$

            start=

        ]

        labels=[

            start = $dimension$              # skip $dimension$ elements before reading the label (i.e. the first two dimensions so we have "x1 x2 y" basically)

            dim =                           # label has  dimension

            labelType=regression

            labelMappingFile = "SimpleMapping.txt"

        ]

    ]

]

# output the results

Output=[

    action="write"

    reader=[

        readerType="UCIFastReader"

        file="Test.txt"

        randomize = "none"

        features=[

            dim=$dimension$

            start=

        ]

        labels=[

            start = $dimension$              # skip $dimension$ elements before reading the label (i.e. the first two dimensions so we have "x1 x2 y" basically)

            dim =                           # label has  dimension

            labelType=regression

            labelMappingFile = "SimpleMapping.txt"

        ]

    ]

    outputPath = "LR.txt"        # dump the output as text

]

dumpNodeInfo=[

  action=dumpnode

  printValues=false

]
后一篇:
用CNTK搞深度学习 (二) 训练基于RNN的自然语言模型 ( language model )
http://www.cnblogs.com/sylvanas2012/p/5419477.html
原创博客,未经允许,请勿转载。
用 CNTK 搞深度学习 (一) 入门的更多相关文章
- 用CNTK搞深度学习 (二) 训练基于RNN的自然语言模型 ( language model )
前一篇文章 用 CNTK 搞深度学习 (一) 入门 介绍了用CNTK构建简单前向神经网络的例子.现在假设读者已经懂得了使用CNTK的基本方法.现在我们做一个稍微复杂一点,也是自然语言挖掘中很火 ...
- CNTK 搞深度学习-1
CNTK 搞深度学习 Computational Network Toolkit (CNTK) 是微软出品的开源深度学习工具包.本文介绍CNTK的基本内容,如何写CNTK的网络定义语言,以及跑通一个简 ...
- PyTorch 60 分钟入门教程:PyTorch 深度学习官方入门中文教程
什么是 PyTorch? PyTorch 是一个基于 Python 的科学计算包,主要定位两类人群: NumPy 的替代品,可以利用 GPU 的性能进行计算. 深度学习研究平台拥有足够的灵活性和速度 ...
- 深度学习动手入门:GitHub上四个超棒的TensorFlow开源项目
作者简介:akshay pai,数据科学工程师,热爱研究机器学习问题.Source Dexter网站创办人. TensorFlow是Google的开源深度学习库,你可以使用这个框架以及Python编程 ...
- (转)Deep Learning深度学习相关入门文章汇摘
from:http://farmingyard.diandian.com/post/2013-04-07/40049536511 来源:十一城 http://elevencitys.com/?p=18 ...
- go微服务框架go-micro深度学习(二) 入门例子
上一篇帖子简单介绍了go-micro的整体框架结构,这一篇主要写go-micro使用方式的例子,中间会穿插一些go-micro的源码,和调用流程图,帮大家更好的理解go-micro的底层.更详细更具体 ...
- 深度学习之入门Pytorch(1)------基础
目录: Pytorch数据类型:Tensor与Storage 创建张量 tensor与numpy数组之间的转换 索引.连接.切片等 Tensor操作[add,数学运算,转置等] GPU加速 自动求导: ...
- pytorch入门--土堆深度学习快速入门教程
工具函数 dir函数,让我们直到工具箱,以及工具箱中的分隔区有什么东西 help函数,让我们直到每个工具是如何使用的,工具的使用方法 示例:在pycharm的console环境,输入 import t ...
- Computational Network Toolkit (CNTK) 是微软出品的开源深度学习工具包
Computational Network Toolkit (CNTK) 是微软出品的开源深度学习工具包 用 CNTK 搞深度学习 (一) 入门 Computational Network Toolk ...
随机推荐
- CentOS下安装实时检测网络带宽的小工具bmon
首先下载rpmforge-release扩展的rpm包 32位操作系统:wget http://www.sudu.us/Tools/bmon/rpmforge-release-0.3.6-1.el5. ...
- DEV主从表
1.主从表隐藏表格展开按钮. 当主表内容不包含子表时候隐藏,主从表加号图标.效果如下图. 实现代码 private void gvMain_CustomDrawCell(object sender, ...
- Asp.net Identity 2.0 作弊条
Moving ASP.NET Identity model to class library http://stackoverflow.com/questions/23446919/moving-as ...
- poj邮局1160
题目是给出V个村庄,取出P个做为邮局,要求每个村庄到邮局的距离和最小. 先考虑只有一个邮局的情况,不管你怎么放邮局和最小的情况总是在中点的位置. 再来考虑P>1的情况: 假设P-1个邮局已经选好 ...
- android中实现view可以滑动的六种方法续篇(二)
承接上一篇,上一篇中讲解了实现滑动的第五种方法,如果你还没读过,可点击下面链接: http://www.cnblogs.com/fuly550871915/p/4985482.html 这篇文章现在来 ...
- Effective Java 44 Write doc comments for all exposed API elements
Principle You must precede every exported class, interface, constructor, method, and field declarati ...
- 烂泥: KVM虚拟机Linux系统增加硬盘
本文由秀依林枫提供友情赞助,首发于烂泥行天下. Linux虚拟机在使用过程中,硬盘空间不够使用.由于前期没有做LVM,所以只能手动添加新的硬盘. 给虚拟机添加硬盘有两种方法: 1.通过virsh at ...
- windows7+eclipse+hadoop2.5.2环境配置
windows7+eclipse+hadoop2.5.2环境配置 一.hadoop集群环境配置 参考我的前一篇文章(ubuntu + hadoop2.5.2分布式环境配置 http://www. ...
- js控制iframe跳转
网页:<iframe src="" id="iframe_a" name="iframe_a" style="width:1 ...
- SVN同步大坑
遇到的问题 这两天一直在搞svn的主从备份,使用的方法是svnsync做的主从同步,同步大部分的仓库都没有什么问题很顺利的就同步完成了,不了解svnsync同步的可以看我这篇,但是在在同步2个仓库的时 ...