
Jsoup获取全国地区数据(省市县镇村)
最近手头在做一些东西,需要一个全国各地的地域数据,从省市区到县镇乡街道的。各种度娘,各种谷歌,都没找到一个完整的数据。最后功夫不负有心人,总算找到一份相对来说比较完整的数据,但是这里的数据也只是精确到镇级别,没有村一级的数据(后来通过分析数据源我知道了为什么,呵呵),在加上博主提供的有些数据存在冗余,对于有强迫症和追求完美的我,心想着我一定要自己动手去把这部分数据给爬取出来。
上述博文中的内容还算丰富,博主是用的是php来实现的,作为2015年度编程语言排行榜的第一位,我们也不能示弱啊,下面我就带着大家一起来看看用java怎么从网页当中爬取我们想要的数据...
第一步、准备工作(数据源+工具):
数据源(截止目前最全面权威的官方数据):http://www.stats.gov.cn/tjsj/tjbz/tjyqhdmhcxhfdm/2013/
爬取数据的工具(爬虫工具):http://jsoup.org/
第二步、数据源分析:
首先jsoup工具的使用我在这里就不做讲解了,感兴趣的可以自己动手去查阅。
做开发就应该多去了解一些软件工具的使用,在平常开发过程中遇到了才知道从何下手,鼓励大家多平时留意一些身边的软件工具,以备不时之需。在做这个东西以前,我也不知道jsoup要怎么用,但我知道jsoup可以用来干嘛,在我需要的用到的时候,再去查阅资料,自己学习。
上述的数据源是2013年中华人民共和国国家统计局发布的,其准确性和权威性不言而喻。
接下来我们分析一下数据源的结构,先从首页说起: 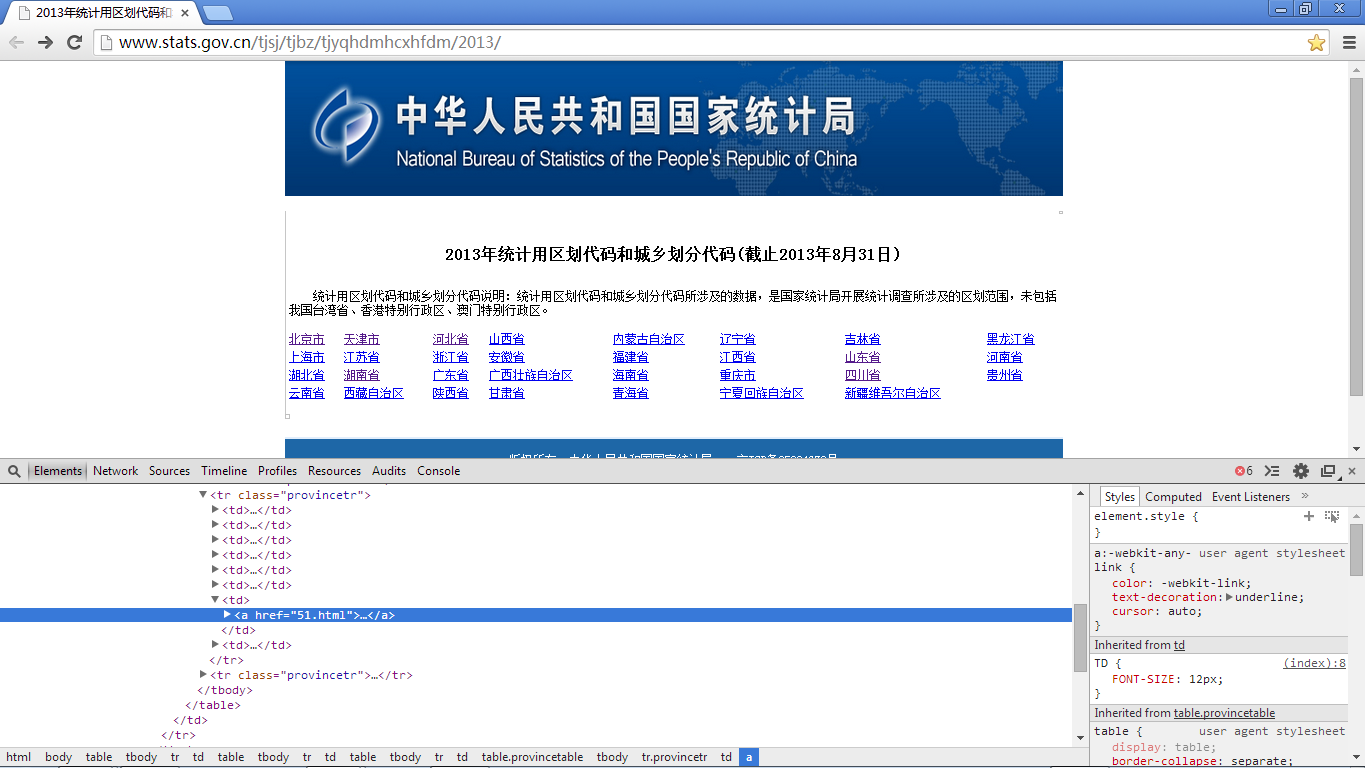
通过分析首页源码我们可以得到如下3点:
- 页面的整个布局是用的table标签来控制的,也就是说我们如果要通过jsoup来选择超链接,那么一定要注意,上图中不是只要标注了省市地区的地方采用的才是表格,整个页面中存在多个表格,因此是不可以直接通过表格
Document connect = connect("http://www.stats.gov.cn/tjsj/tjbz/tjyqhdmhcxhfdm/2013/");

Elements rowProvince = connect.select("table");
来解析数据的。
- 页面中有超链接的部分有多少地方。可能是官方考虑到了你们这种程序员需要获取这样的数据的原因吧,页面很干净,除开下方的备案号是多余的超链接,其他的链接可以直接爬取。
- 省份城市的数据规律。包含有效信息的表格的每一行都有一个class属性provincetr,这个属性很重要,至于为什么重要,请接着往下看;每一行数据中存在多个td标签,每一个td标签中包含一个a超链接,而这个超链接正是我们想要的超链接,超链接的文本即使省份(直辖市等)的名称。
再次我们再看一下一般的数据页面(一般的数据页面包括市级、县级、镇级这三级数据展示页面):
之所以要把上述三个页面放在一起,是因为通过分析我们可以发现,这三级数据的数据页面完全一致,唯一不同的就是在html源码数据表格中的数据行tr的class属性不一致,分别对应为:citytr,countrytrhe towntr。其他均一致。这样我们就可以用一个通用的方法解决这三个页面的数据爬取。 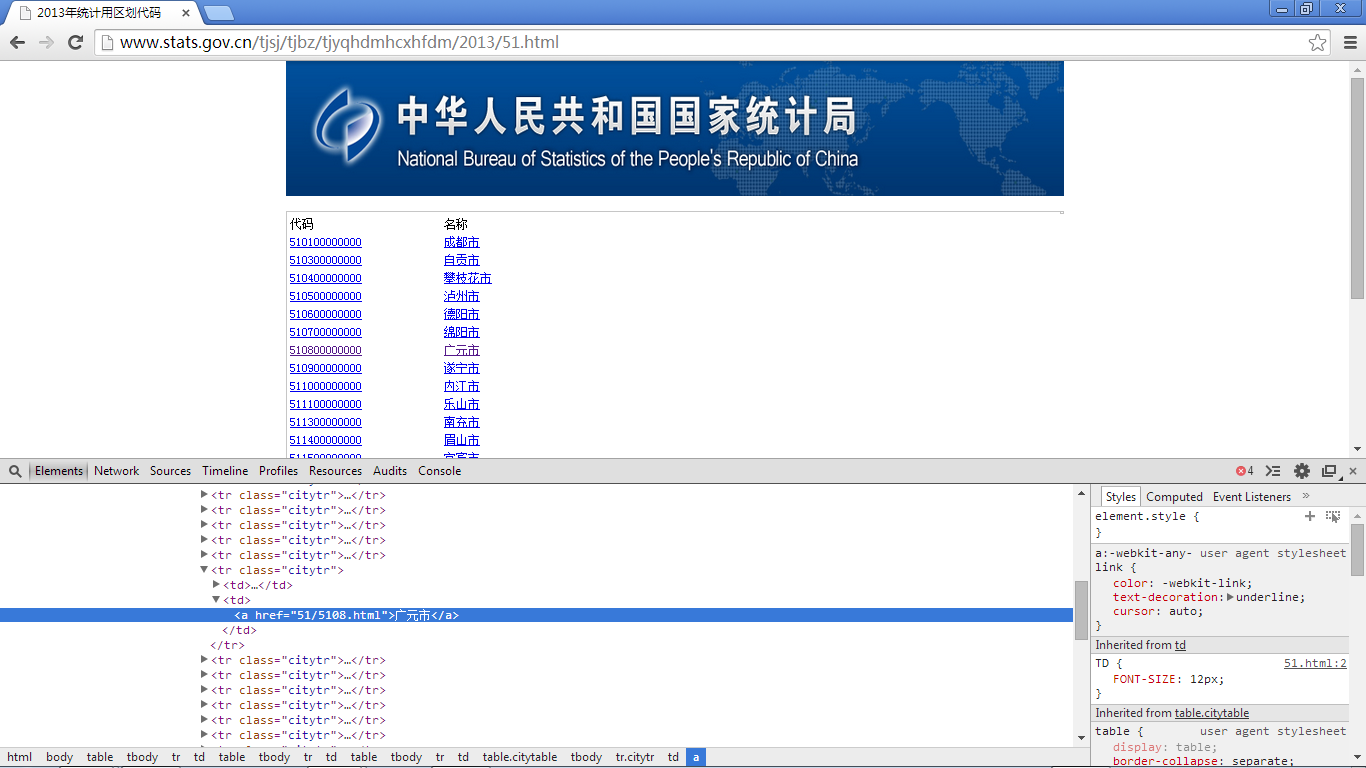
最后看看村一级的数据页面: 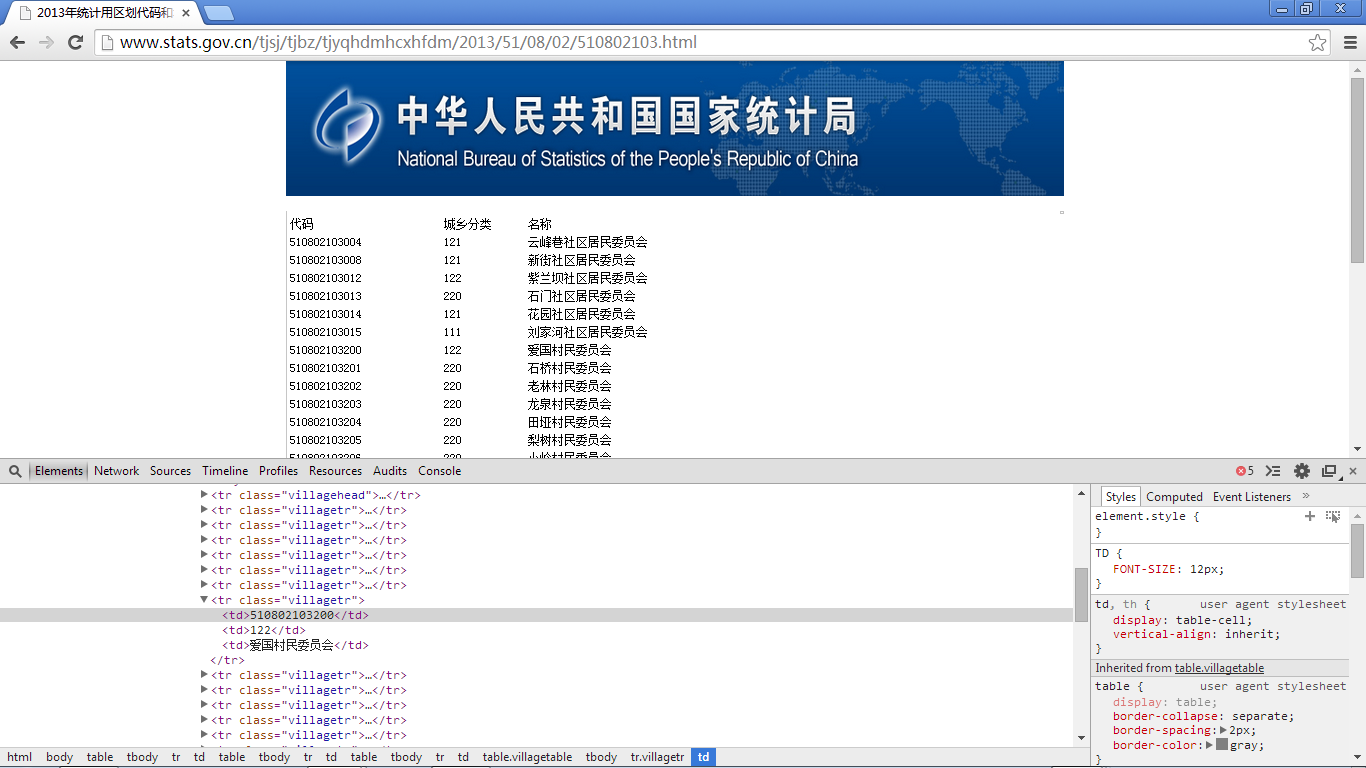
在村一级的数据中,和上述市县镇的数据格式不一致,这一级所表示的数据是最低一级的,所以不存在a链接,因此不能采用上面市县镇数据的爬取方式去爬取;这里展示数据的表格行的class为villagetr,除开这两点以外,在每一行数据中包含三列数据,第一列是citycode,第二列是城乡分类(市县镇的数据格式不存在这一项),第三列是城市名称。
把握了以上各个要点之外,我们就可以开始编码了。
第三步、编码实现:
import java.io.BufferedWriter;

import java.io.File;

import java.io.FileWriter;

import java.io.IOException;

import java.util.HashMap;

import java.util.Map;

import org.jsoup.Jsoup;

import org.jsoup.nodes.Document;

import org.jsoup.nodes.Element;

import org.jsoup.select.Elements;

/**

 * 全国省市县镇村数据爬取

 * @author liushaofeng

 * @date 2015-10-11 上午12:19:39

 * @version 1.0.0

 */

public class JsoupTest

{

    private static Map<Integer, String> cssMap = new HashMap<Integer, String>();

    private static BufferedWriter bufferedWriter = null;

    static

    {

        cssMap.put(, "provincetr");// 省

        cssMap.put(, "citytr");// 市

        cssMap.put(, "countytr");// 县

        cssMap.put(, "towntr");// 镇

        cssMap.put(, "villagetr");// 村

    }

    public static void main(String[] args) throws IOException

    {

        int level = ;

        initFile();

        // 获取全国各个省级信息

        Document connect = connect("http://www.stats.gov.cn/tjsj/tjbz/tjyqhdmhcxhfdm/2013/");

        Elements rowProvince = connect.select("tr." + cssMap.get(level));

        for (Element provinceElement : rowProvince)// 遍历每一行的省份城市

        {

            Elements select = provinceElement.select("a");

            for (Element province : select)// 每一个省份(四川省)

            {

                parseNextLevel(province, level + );

            }

        }

        closeStream();

    }

    private static void initFile()

    {

        try

        {

            bufferedWriter = new BufferedWriter(new FileWriter(new File("d:\\CityInfo.txt"), true));

        } catch (IOException e)

        {

            e.printStackTrace();

        }

    }

    private static void closeStream()

    {

        if (bufferedWriter != null)

        {

            try

            {

                bufferedWriter.close();

            } catch (IOException e)

            {

                e.printStackTrace();

            }

            bufferedWriter = null;

        }

    }

    private static void parseNextLevel(Element parentElement, int level) throws IOException

    {

        try

        {

            Thread.sleep();//睡眠一下,否则可能出现各种错误状态码

        } catch (InterruptedException e)

        {

            e.printStackTrace();

        }

        Document doc = connect(parentElement.attr("abs:href"));

        if (doc != null)

        {

            Elements newsHeadlines = doc.select("tr." + cssMap.get(level));//

            // 获取表格的一行数据

            for (Element element : newsHeadlines)

            {

                printInfo(element, level + );

                Elements select = element.select("a");// 在递归调用的时候,这里是判断是否是村一级的数据,村一级的数据没有a标签

                if (select.size() != )

                {

                    parseNextLevel(select.last(), level + );

                }

            }

        }

    }

    /**

     * 写一行数据到数据文件中去

     * @param element 爬取到的数据元素

     * @param level 城市级别

     */

    private static void printInfo(Element element, int level)

    {

        try

        {

            bufferedWriter.write(element.select("td").last().text() + "{" + level + "}["

                + element.select("td").first().text() + "]");

            bufferedWriter.newLine();

            bufferedWriter.flush();

        } catch (IOException e)

        {

            e.printStackTrace();

        }

    }

    private static Document connect(String url)

    {

        if (url == null || url.isEmpty())

        {

            throw new IllegalArgumentException("The input url('" + url + "') is invalid!");

        }

        try

        {

            return Jsoup.connect(url).timeout( * ).get();

        } catch (IOException e)

        {

            e.printStackTrace();

            return null;

        }

    }

}
数据爬取过程便是一个漫长的过程,只需要慢慢等待吧,呵呵,由于程序运行时间较长,请不要在控制台打印输出,否则可能会影响程序运行....
最终获取到数据的格式如下("{}"中表示城市级别,"[]"中内容表示城市编码):
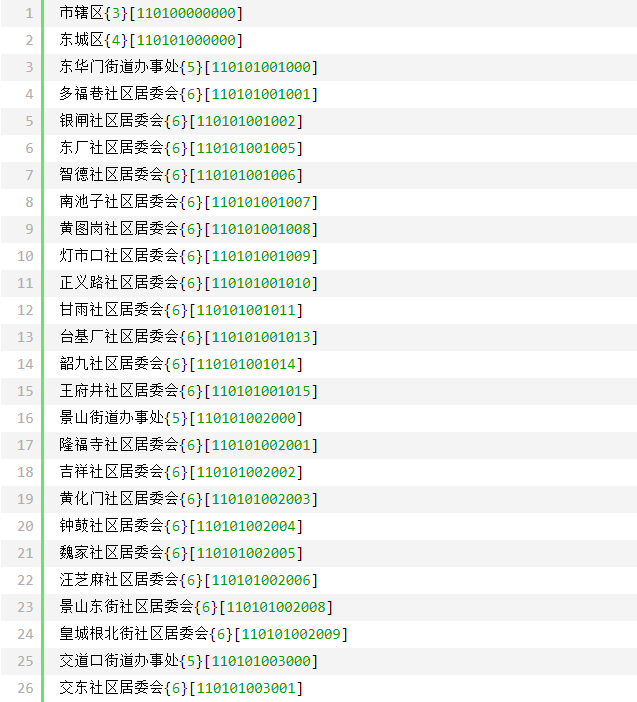
拿到以上数据以后,自己想干什么都可以自我去实现了,以上的代码可以直接运行,从数据源爬取后,可以直接转换成自己所要的格式。
后续处理的最终结果,请参见博文:http://www.cnblogs.com/liushaofeng89/p/4937714.html
如果你觉得本博文对你有所帮助,请记得点击右下方的"推荐"哦,么么哒...
转载请注明出处:http://www.cnblogs.com/liushaofeng89/p/4873086.html
Jsoup获取全国地区数据(省市县镇村)的更多相关文章
- Jsoup获取全国地区数据(省市县镇村)(续) 纯干货分享
前几天给大家分享了一下,怎么样通过jsoup来从国家统计局官网获取全国省市县镇村的数据.错过的朋友请点击这里.上文说到抓取到数据以后,我们怎么转换成我们想要格式呢?哈哈,解析方式可能很简单,但是有一点 ...
- 省市县镇村五级地址智能提取(标准地址源来自国家统计局官网)SpringBoot+Elasticsearch 5.6
项目目的 根据传入的地址,智能提取所属的省市县镇村5级地址.例如:用户输入“江苏南通嗨安李堡镇陈庄村8组88号”,我们需要提取到江苏省 南通市 海安县(即便用户输入了错字,“海”写成了“嗨”) 李 ...
- Jsoup获取部分页面数据失败 org.jsoup.UnsupportedMimeTypeException: Unhandled content type. Must be text/*, application/xml, or application/xhtml+xml.
用Jsoup在获取一些网站的数据时,起初获取很顺利,但是在访问某浪的数据是Jsoup报错,应该是请求头里面的请求类型(ContextType)不符合要求. 请求代码如下: private static ...
- Jsoup获取部分页面数据失败 Unhandled content type. Must be text/*, application/xml, or application/xhtml+xml
用Jsoup在获取一些网站的数据时,起初获取很顺利,但是在访问某浪的数据是Jsoup报错,应该是请求头里面的请求类型(ContextType)不符合要求. 请求代码如下: private static ...
- 全中国的省市县镇乡村数据获取以及展示java源代码
第一步.准备工作(数据源+工具): 数据源(截止目前最全面权威的官方数据):http://www.stats.gov.cn/tjsj/tjbz/tjyqhdmhcxhfdm/2013/ 爬取数据的工具 ...
- 获取上海地区AQI质量数据Python脚本
一个获取上海地区AQI质量的Python脚本 https://github.com/yanyueoo7/Raspberrypi/blob/master/GetPmData_Shanghai.py #! ...
- 获取全国市以及地理坐标,各大坐标系北斗,百度,WGS-84坐标系的转换,有图,有代码
1 先上坐标取到的值: 获取到的坐标部分如下: '北京市':[116.39564503788,39.92998577808], '天津市':[117.21081309155,39.1439299033 ...
- 全国天气预报数据API调用PHP示例
本代码示例是基于PHP的聚合数据全国天气预报API服务请求的代码样例,使用前你需要: ①:通过https://www.juhe.cn/docs/api/id/39 申请一个天气预报API的appkey ...
- 全国地区sql表
/** * 中国省市区--地区SQL表 */ CREATE TABLE `rc_district` ( `id` smallint(5) unsigned NOT NULL AUTO_INCREMEN ...
随机推荐
- IDEA 介绍
转载:https://blog.csdn.net/kanchaishaonian/article/details/81107210 前言:IntelliJ IDEA 如果说IntelliJ IDEA是 ...
- LeetCode--030--串联所有单词的字串(java)
给定一个字符串 s 和一些长度相同的单词 words.找出 s 中恰好可以由 words 中所有单词串联形成的子串的起始位置. 注意子串要与 words 中的单词完全匹配,中间不能有其他字符,但不需要 ...
- 分别用Excel和python进行日期格式转换成时间戳格式
最近在处理一份驾驶行为方面的数据,其中要用到时间戳,因此就在此与大家一同分享学习一下. 1.什么是时间戳? 时间戳是指格林威治时间1970年01月01日00时00分00秒(北京时间1970年01月01 ...
- list内含有元组或字典
a=[(")] for k,v,i in a: print(k,v,i) 结果: 1 21 12 2 31 32 list里含元组,可以用这种遍历输出挨个元素 但list里含字典时,这样就只 ...
- 【Oracle】【9】阅读oracle执行计划
正文: 工具:PLSQL 1,配置执行计划需要显示的项 工具→首选项→窗口类型→计划窗口→根据需要配置要显示在执行计划中的列 2,打开执行计划 在SQL窗口执行完一条select语句后按 F5 即可查 ...
- fetch与XHR的区别与优势
Fetch API更加现代 XHR 和 Fetch API 最显著的区别就是调用方式不同.这一点大家应该都知道吧. 举个例子,下面两端代码完成的是同一功能: // 用 XHR 发起一个GET请求 va ...
- 一个简单的C语言程序(详解)
C Primer Plus之一个简单的C语言程序(详解) #include <stdio.h> int main(void) //一个简单的 C程序 { int num; //定义一个名为 ...
- JS获取访客IP+判断归属地+自动跳转
由于公司业务需要,需要对网站特定地区的访客进行不同跳转.比如,上海的用户跳转到“shanghai.url.cn”,南京的用户跳转到“nanjing.url.cn”.下面就是我的实现方法,分享出来,顺便 ...
- OneNote无法打开链接出现错误:你的组织策略阻止我们为你完成此操作
首先打开注册表编辑器,按键盘win+r,调出运行窗口,输入regedit打开注册表编辑器 打开HKEY_CURRENT_USER\Software 打开\Classes 最后选中.html,在默认选项 ...
- WCF服务无法访问DateTime类型的解决方法
在WCF服务中,如果entity类含有DateTime类型的字段,那么接口将会被执行两次,从而出现无法访问的情况.如下图所示: 原因是WCF中DateTime无法转换成序列化JSON字符串,DateT ...