
redis通过pipeline提升吞吐量
案例目标
简单介绍 redis pipeline 的机制,结合一段实例说明pipeline 在提升吞吐量方面发生的效用。
案例背景
应用系统在数据推送或事件处理过程中,往往出现数据流经过多个网元;
然而在某些服务中,数据操作对redis 是强依赖的,在最近的一次分析中发现:
一次数据推送会对 redis 产生近30次读写操作!
在数据推送业务中的性能压测中,以数据上报 -> 下发应答为一次事务;
而对于这样的读写模型,redis 的操作过于频繁,很快便导致系统延时过高,吞吐量低下,无法满足目标;
优化过程 主要针对业务代码做的优化,其中redis 操作经过大量合并,最终降低到原来的1/5,而系统吞吐量也提升明显。
其中,redis pipeline(管道机制) 的应用是一个关键手段。
pipeline的解释
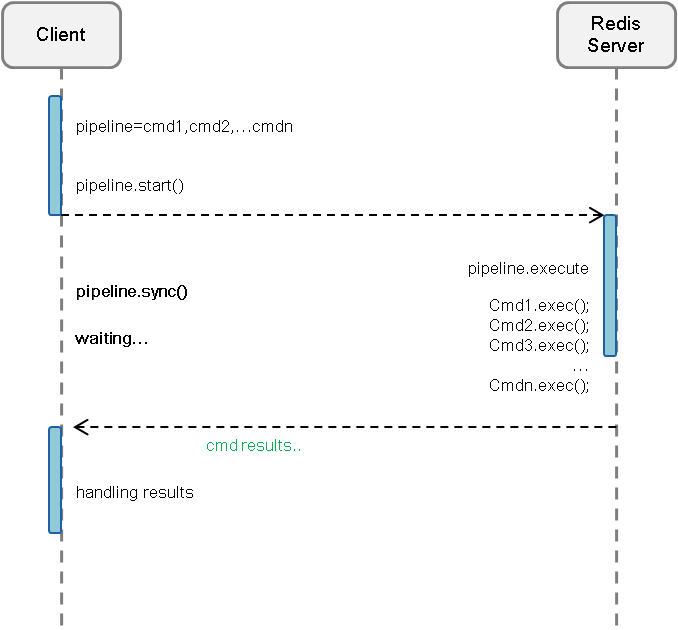
Pipeline指的是管道技术,指的是客户端允许将多个请求依次发给服务器,过程中而不需要等待请求的回复,在最后再一并读取结果即可。
管道技术使用广泛,例如许多POP3协议已经实现支持这个功能,大大加快了从服务器下载新邮件的过程。
Redis很早就支持管道(pipeline)技术。(因此无论你运行的是什么版本,你都可以使用管道(pipelining)操作Redis)
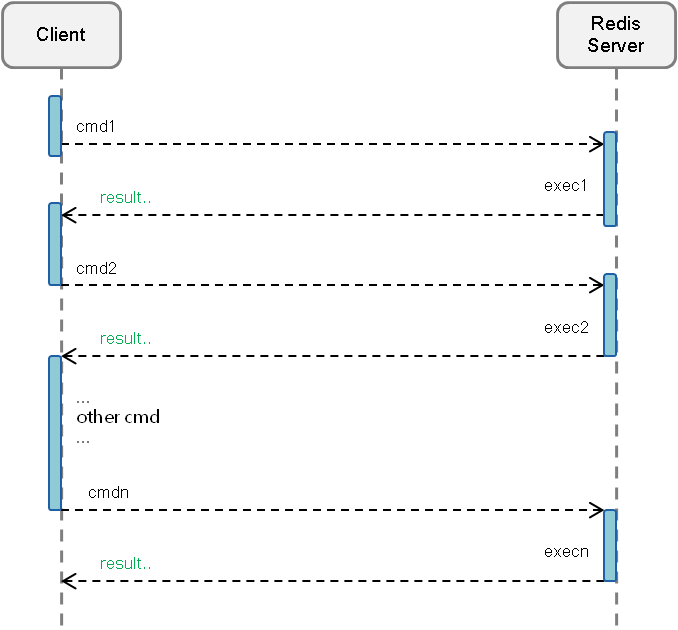
普通请求模型
[图-pipeline1]
Pipeline请求模型
[图-pipeline2]
从两个图的对比中可看出,普通的请求模型是同步的,每次请求对应一次IO操作等待;
而Pipeline 化之后所有的请求合并为一次IO,除了时延可以降低之外,还能大幅度提升系统吞吐量。
代码实例
说明
本地开启50个线程,每个线程完成1000个key的写入,对比pipeline开启及不开启两种场景下的性能表现。
相关常量
   // 并发任务

    private static final int taskCount = 50;

    // pipeline大小

    private static final int batchSize = 10;

    // 每个任务处理命令数

    private static final int cmdCount = 1000;

    private static final boolean usePipeline = true;
初始化连接
        JedisPoolConfig poolConfig = new JedisPoolConfig();

        poolConfig.setMaxActive(200);

        poolConfig.setMaxIdle(100);

        poolConfig.setMaxWait(2000);

        poolConfig.setTestOnBorrow(false);

        poolConfig.setTestOnReturn(false);

        jedisPool = new JedisPool(poolConfig, host, port);
并发启动任务,统计执行时间
public static void main(String[] args) throws InterruptedException {

        init();

        flushDB();

        long t1 = System.currentTimeMillis();

        ExecutorService executor = Executors.newCachedThreadPool();

        CountDownLatch latch = new CountDownLatch(taskCount);

        for (int i = 0; i < taskCount; i++) {

            executor.submit(new DemoTask(i, latch));

        }

        latch.await();

        executor.shutdownNow();

        long t2 = System.currentTimeMillis();

        System.out.println("execution finish time(s):" + (t2 - t1) / 1000.0);

    }
DemoTask 封装了执行key写入的细节,区分不同场景
    public void run() {

            logger.info("Task[{}] start.", id);

            try {

                if (usePipeline) {

                    runWithPipeline();

                } else {

                    runWithNonPipeline();

                }

            } finally {

                latch.countDown();

            }

            logger.info("Task[{}] end.", id);

     }
不使用Pipeline的场景比较简单,循环执行set操作
            for (int i = 0; i < cmdCount; i++) {

                Jedis jedis = get();

                try {

                    jedis.set(key(i), UUID.randomUUID().toString());

                } finally {

                    if (jedis != null) {

                        jedisPool.returnResource(jedis);

                    }

                }

                if (i % batchSize == 0) {

                    logger.info("Task[{}] process -- {}", id, i);

                }

            }
使用Pipeline,需要处理分段,如10个作为一批命令执行
         for (int i = 0; i < cmdCount;) {

                Jedis jedis = get();

                try {

                    Pipeline pipeline = jedis.pipelined();

                    int j;

                    for (j = 0; j < batchSize; j++) {

                        if (i + j < cmdCount) {

                            pipeline.set(key(i + j), UUID.randomUUID().toString());

                        } else {

                            break;

                        }

                    }

                    pipeline.sync();

                    logger.info("Task[{}] pipeline -- {}", id, i + j);

                    i += j;

                } finally {

                    if (jedis != null) {

                        jedisPool.returnResource(jedis);

                    }

                }

            }
运行结果
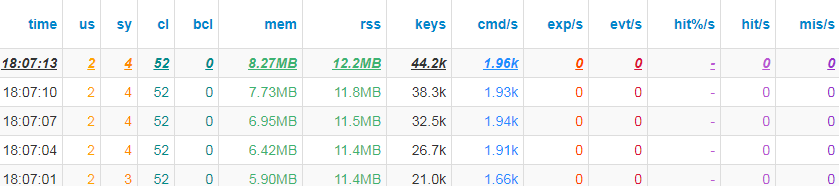
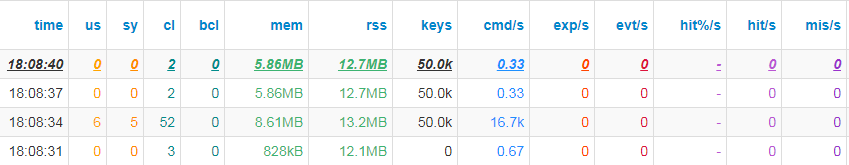
不使用Pipeline,整体执行26s;而使用Pipeline优化后的代码,执行时间仅需要3s!
NoPipeline-stat
[图-nopipeline]
Pipeline-stat
[图-pipeline]
注意事项
- pipeline机制可以优化吞吐量,但无法提供原子性/事务保障,而这个可以通过Redis-Multi等命令实现。
参考这里 - 部分读写操作存在相关依赖,无法使用pipeline实现,可利用Script机制,但需要在可维护性方面做好取舍。
扩展阅读
官方文档-Redis-Pipelining
官方文档-Redis-Transaction
redis通过pipeline提升吞吐量的更多相关文章
- 【redis】pipeline - 管道模型
redis-pipeline 2020-02-10: 因为我把github相关的wiki删了,所以导致破图...待解决.(讲真github-wiki跟project是2个url,真的不好用) 因为用的 ...
- redis 使用管道提升写入的性能[pipeline]
看了手册的都知道multi这个命令的作用就好比是mysql的事务的功能,但是大家都知道事务吗,就是在操作的过程中,把整个操作当作一个原子来处理,避免由于中途出错而导致最后产生的数据不一致,而产生BUG ...
- 分布式缓存Redis之Pipeline(管道)
Redis的pipeline(管道)功能在命令行中没有,但redis是支持pipeline的,而且在各个语言版的client中都有相应的实现. 由于网络开销延迟,就算redis server端有很强的 ...
- Redis大幅性能提升之Batch批量读写
Redis大幅性能提升之Batch批量读写 提示:本文针对的是StackExchange.Redis 一.问题呈现 前段时间在开发的时候,遇到了redis批量读的问题,由于在StackExchange ...
- Jmeter 压力测试笔记(3)--脚本调试/签名/cookie/提升吞吐量/降低异常率/提升单机并发性能
import XXXsign.Openapi2sign;---导入jar包中的签名方法 String str1 = "12121"; ---需要被签名的字段:向开发了解需要哪些哪些 ...
- redis之pipeline使用
redis之pipeline 我们要完成一个业务,可能会对redis做连续的多个操作,这有很多个步骤是需要依次连续执行的.这样的场景,网络传输的耗时将是限制redis处理量的主要瓶颈. 那么此时就可以 ...
- Redis利用Pipeline加速查询速度的方法
1. RTT Redis 是一种基于客户端-服务端模型以及请求/响应协议的TCP服务.这意味着通常情况下 Redis 客户端执行一条命令分为如下四个过程: 发送命令 命令排队 命令执行 返回结果 客户 ...
- Redis 管道pipeline
Redis是一个cs模式的tcp server,使用和http类似的请求响应协议. 一个client可以通过一个socket连接发起多个请求命令. 每个请求命令发出后client通常会阻塞并等待red ...
- 大数据学习day34---spark14------1 redis的事务(pipeline)测试 ,2. 利用redis的pipeline实现数据统计的exactlyonce ,3 SparkStreaming中数据写入Hbase实现ExactlyOnce, 4.Spark StandAlone的执行模式,5 spark on yarn
1 redis的事务(pipeline)测试 Redis本身对数据进行操作,单条命令是原子性的,但事务不保证原子性,且没有回滚.事务中任何命令执行失败,其余的命令仍会被执行,将Redis的多个操作放到 ...
随机推荐
- java 多线程 Callable -- 分段处理一个大的list 然后再合并结果
本文代码参考 http://bbs.csdn.net/topics/391070227?page=1 下面是贴出的代码: public void dealListWithMutiThread(){ L ...
- [翻译]QT core wallet manual 狗狗币核心钱包使用教程
译注:比特币没赶上可以玩狗狗币啊,水电厂包不起可以用CPU挖啊.为了顺应时代潮流,了解一下区(fa)块(heng)链(cai)和加密货币技术,准备从研究狗狗币开始.网上找了一圈没有看到很好的入门级教程 ...
- atom编辑器启动后文件不能编辑的解决办法
今天更新了atom,并且安装了很多插件,突然发现所有页面不能编辑了,如图 这个光标块会自动跳到单词后面,后来发现按一下键盘的字母a就变成正常光标了,至于原因,折腾了一个小时也没发现,后来百度到用Ctr ...
- Angular17 Angular自定义指令
1 什么是HTML HTML文档就是一个纯文本文件,该文件包含了HTML元素.CSS样式以及JavaScript代码:HTML元素是由标签呈现,浏览器会为每个标签创建带有属性的DOM对象,浏览器通过渲 ...
- Java-反射初级知识掌握
PS:本文就Java基础需要掌握的反射知识做下汇总和分析. Java-reflect:java反射,对应我们研究框架.底层框架起到基本的知识储备. Class类Java的世界类,万事皆对象,所有的类都 ...
- Visual Studio 2017 安装后无法创建c++或MFC项目
话话不多说,直接上图
- 微信小程序模板消息详解
先放代码 wxml: <form name='pushMsgFm' report-submit bindsubmit='orderSign'> <view> 单号: 0< ...
- 数据结构与算法(c++)——反转链表
算法概述:要求实现将一条单向链表反转并考虑时间复杂度. 算法分析: 数组法(略): 将列表元素逐个保存进数组,之后再逆向重建列表 点评:实现逻辑最简单,需要额外的内存开销. 移动指针: 通过三个指针逐 ...
- ubuontu16.04安装Opencv库引发的find_package()错误信息处理及其简单使用
在安装完Opencv库之后,打算测试一下Opencv库是否成功安装.下面是用的例子对应的.cpp代码以及对应的CMakeLists.txt代码: .cpp文件: #include <stdio. ...
- JavaScript之事件委托(附原生js和jQuery代码)
事件委托的原理依赖于事件冒泡,可以通过给父元素的事件委托来确定是哪个子元素触发了事件从而做一系列操作. 使用事件委托的优点 1.操作子元素时不用一一遍历,可以根据事件触发的对象而进行相应操作 dom结 ...