
hadoop第二课
1.1为什么需要Hadoop
(1)数据分析者面临的问题
– 数据日趋庞大,读写都出现性能瓶颈;
– 用户的应用和分析结果,对实时性和响应时间 要求越来越高;
– 使用的模型越来越复杂,计算量指数级上升。
(2)期待的解决方案
– 解决性能瓶颈,在可见的未来不会出现新瓶颈 之前的技术可以平稳过渡,如SQL;
– 转移成本,如软硬件成本,开发成本,技能培 养成本,维护成本
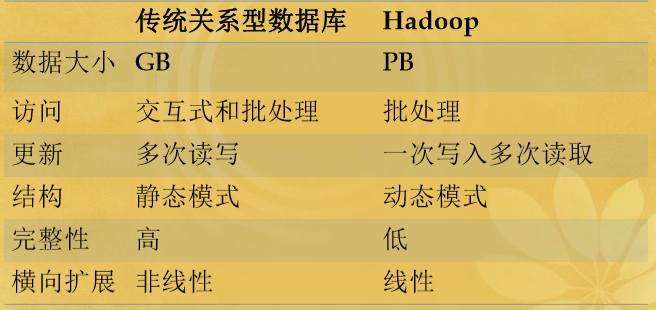
(3)关系型数据库和Hadoop的比较
课堂笔记
关系型数据库属于集中型的数据方案。
数据大小:
1PB=210GB
访问:
交互式处理—处理在线数据,实时处理,通俗一点就是一问一答的意思。
批处理—处理离线数据,举个例子,学生问老师10个问题,老师将这10个问题解决后,一次性将解答打包给学生。
更新:
一次写入多次读写—eg:百度搜索。(倒排索引)
ps:增删改查,Hadoop中没有改,当写错时,就只有直接覆盖。
另外,关系型数据库的数据结构是表,,在建好的表上增加或删除属性,成本是很大的。
结构:
怎么说呢?在传统关系型数据库Mysql中,比如学生管理系统,其中关于学生的一个表,有很多属性,Sno Sname Sage Ssex Sdept,其中,某些属性对应的属性值是null,存储时是会占空间的,而Hadoop的话,null值是不会占空间的。数据一大,那优势就体现出来了。
完整性:
范式是符合某一种级别的关系模式的集合。关系数据库中的关系必须满足一定的要求,满足不同程度要求的为不同范式。
换句话说,就是规则(约束),进而有了完整性一说。
因而在关系型数据库中,因为有外键的存在,在删除某个表时,要删除从表信息,才能删除主表的信息。
Hadoop就不同,它是一张大表,就没有关系型数据库的那些麻烦。
那么,问题来了,既然如此,那么我们的生活中就不需要关系型数据库了吗?
举个例子,教务系统,当中有学生的信息,老师的管理,课程的安排等等,不可能只用一张表能装下如此错综复杂的信息。因而我们生活中还是要用关系型数据库!
横向扩展:
嗯...没有图,将就了吧。想象一下,这里有个二维函数,横坐标是服务器的台数,纵坐标是性能,Hadoop和RDBMS(关系型数据库)在第一区间的函数分别是怎样的呢?前者是一个一次函数,一直上升;后者的函数先极速上升,后趋向平缓,进而无论后面增加多少台服务器,性能都趋于定值。
Hadoop思想-小鱼与鲨鱼,高富帅与屌丝

(4)集群
- 集群的定义
– 集群是一组相互独立的、通过高速网络互联的 计算机,它们构成了一个组,并以单一系统的 模式加以管理。
– 一个客户与集群相互作用时,集群像是一个独 立的服务器。
- 集群的作用
– 在付出较低成本的情况下获得在性能、可靠性、 灵活性方面的相对较高的收益
- 使用集群的目的
– 提高性能(横向扩展)
– 降低成本(买一台百万级的服务器,用分布式10万块就可以办到)
– 提高可扩展性(加一台机器,性能呈 上升)
– 增强可靠性(比如说一台机子宕机了)
- 使用集群的场景
– 科学集群
– 负载均衡集群
– 高可用性集群
- 集群的构建
– 从硬件角度来看可以分为节点机系统、通讯系 统、存储系统等
– 软件角度则主要有操作系统、集群操作系统 (COS)、并行环境、编译环境和用户应用软件等
- 集群的关键技术
– 任务调度——进程迁移
(5)Hadoop体系下的分析手段
– 主流:Java 程序
– 海量离线数据处理技术:MapReduce
– 分布式文件系统:HDFS
– NoSQL(Not Only不止一个数据库的意思)数据库:Hbase
– SQL技巧平稳:Hive
1.2Hadoop2.0生态系统
(1)Hadoop自身包括以下内容:
Hadoop Common: hadoop的基础
Hadoop Distributed File System (HDFS): 分布式文件系统
Hadoop YARN: 集群任务资源管理及任务 调度的框架
Hadoop MapReduce: 基于YARN的分布式计算
(2)与hadoop相关的产品大致上分为两大部分:
- 数据服务(Data Services)
– HBase: 将文件建于HDFS上的分布式KeyValue数据库 要先搭建Hadoop平台!
– Hive: 有比较友好接口(相对来讲)的数据仓 库,它实际上是基于MapReduce的一个应用。搭建Hive之前不必要搭建Hbase,但要搭建Hadoop。
– Pig:它使用一个叫做“Pig Latin”的东西来作为 用户交互语言,底层依然是MapReduce。它与 Hive有类似之处,都是用来做大数据处理,但 它似乎比Hive要简单一些,没有“存储”的概念 (metadata,“表”等), 接口也少。
– HCatalog:这是一个hadoop数据管理层,你 可以用Hive, Pig , MapReduce等来存取 hadoop的数据,而不用关心这些数据是如何存 储的。
- 运行维护(Operational Services)
– ZooKeeper:分布式应用协调器。只能搭建奇数个集群。
- 其他相关产品/项目:
– Mahout: 机器学习和数据挖掘
– Spark:内存计算
– Storm:实时计算
ps:现在其余两个已经被Spark取代。
(3)Hadoop2.0中各种产品的相互关系

灰色的Hadoop自带,绿色的是与Hadoop相关的产品。
Amban:运维工具
Avro:某种协议
Cassandra:最最专业的NoSQL工具
Oozie:向Hadoop提交数据
三大主流的数据库:Cassandra;芒果;Hbase。
hadoop第二课的更多相关文章
- 马士兵hadoop第二课:hdfs集群集中管理和hadoop文件操作
马士兵hadoop第一课:虚拟机搭建和安装hadoop及启动 马士兵hadoop第二课:hdfs集群集中管理和hadoop文件操作 马士兵hadoop第三课:java开发hdfs 马士兵hadoop第 ...
- 马士兵hadoop第二课:hdfs集群集中管理和hadoop文件操作(转)
马士兵hadoop第一课:虚拟机搭建和安装hadoop及启动 马士兵hadoop第二课:hdfs集群集中管理和hadoop文件操作 马士兵hadoop第三课:java开发hdfs 马士兵hadoop第 ...
- Hadoop第二课:Hadoop集群环境配置
一.Yum配置 1.检查Yum是否安装 rpm -qa|grep yum 2.修改yum源,我使用的是163的镜像源(http://mirrors.163.com/),根据自己的系统选择源, #进入目 ...
- 马士兵hadoop第一课:虚拟机搭建和安装hadoop及启动(转)
马士兵hadoop第一课:虚拟机搭建和安装hadoop及启动 马士兵hadoop第二课:hdfs集群集中管理和hadoop文件操作 马士兵hadoop第三课:java开发hdfs 马士兵hadoop第 ...
- CI(CodeIgniter)框架入门教程——第二课 初始MVC
本文转载自:http://www.softeng.cn/?p=53 今天的主要内容是,使用CodeIgniter框架完整的MVC内容来做一个简单的计算器,通过这个计算器,让大家能够体会到我在第一节课中 ...
- OpenCV 第二课 认识图像的存储结构
OpenCV 第二课 认识图像的存储结构 Mat Mat 类包含两部分,矩阵头和矩阵体.矩阵头包含矩阵的大小,存储方式和矩阵体存储空间的指针.因此,Mat中矩阵头的大小是固定的,矩阵体大小是不定的. ...
- Kali Linux Web 渗透测试视频教程— 第二课 google hack 实战
Kali Linux Web 渗透测试— 第二课 代理简介 文/玄魂 课程地址: http://edu.51cto.com/course/course_id-1887.html 目录 shellKal ...
- 【第二课】深入理解Handler
简要讲解Handler是做什么的 我们知道,在Android中,app启动会启动一个进程一个线程——UI线程,UI线程是主线程,并且不允许这个线程阻塞超过5秒,一旦超过5秒就会ANR. 所以较为耗时的 ...
- ruby代码重构第二课
(文章都是从我的个人主页上粘贴过来的, 大家也可以访问我的主页 www.iwangzheng.com) 在第一课里提取出了相通的代码,第二课里就把常量提取出来吧 一般把常量的定义写的对应的app/mo ...
随机推荐
- 洛谷 P2194 HXY烧情侣【Tarjan缩点】 分析+题解代码
洛谷 P2194 HXY烧情侣[Tarjan缩点] 分析+题解代码 题目描述: 众所周知,HXY已经加入了FFF团.现在她要开始喜(sang)闻(xin)乐(bing)见(kuang)地烧情侣了.这里 ...
- Mock摆脱后端拖拉(借鉴官网)(一)
mock是一个模拟数据生成器,旨在帮助前端独立于后端进行开发,帮助编写单元测试.mock有如下功能 根据数据模板生成模板数据 模拟ajax请求,生成请求数据 基于html模板生成模拟数据 下载安装 n ...
- 【学习笔记】 使用XML配置和注解实现Spring的依赖注入DI (2-3-2)
Spring的四个核心组件 1.beans Bean是包装应用程序自定义对象Object的 Object中保存数据 2.core 3.context 一个Bean的关系集合 4.expression ...
- spring 组件@Scope(request,session)示例
上回说到, spring组件的注解Scope大约有singleton.prototype.request.session.global session 这么几种常用的场景.这里需要特别说明一下,根据源 ...
- Docker 入门之创建service(一)
在一个分布式应用中,我们把应用的不同层叫做"Services".比如,一个视频共享应用,它包含存储数据到数据库的服务,用户上载后后台进行的视频解码服务,前端服务等等. 然而,一个服 ...
- Linux(ubuntu)安装redis集群,redis集群搭建
今天学习一下redis集群的搭建.redis在现在是很常用的数据库,在nosql数据库中也是非常好用的,接下来我们搭建一下redis的集群. 一.准备 首先我们要安装c语言的编译环境,我们要安装red ...
- nyoj720 项目安排 二分+dp
思路:dp(i)表示前i个项目的最大收益,转移方程很好写dp(i) = max{ dp(k) + val(i) },val(i)表示第i个项目的价值,dp(k)表示前k个的最佳收益,k满足ed(k) ...
- Tomcat重定向
tomcat默认情况下不带www的域名是不会跳转到带www的域名的,而且也无法像apache那样通过配置.htaccess来实现.如果想要把不带"www'的域名重定向到带"www& ...
- AFDX总线协议规范
AFDX总线协议规范 1.概述 2. AFDX简介 3.AFDX的在数据传输性能的改进 3.1 AFDX以太网帧格式 3.2 AFDX以太网冗余备份 3.3 虚拟连接 3.4 数据交换处理 4.航空计 ...
- Android项目中的各个模块框架设计
作为Android开发,现对项目开发中的各个模块搭建,梳理如下: Android UI框架,开发人员需要达到专家级 网络框架 浏览框架 图片加载框架 图片裁剪压缩工具类 客户端并发框架 线程池设计 ( ...