
Scrapy定时执行爬取任务与定时关闭任务
当我们利用Python scrapy框架写完脚本后,脚本已经可以稳定的进行数据的爬取,但是每次需要手动的执行,太麻烦,如果能自动运行,在自动关闭那就好了,经过小编研究,完全是可以实现的,今天小编介绍2种方案来解决这个问题
由于scrapy框架本身没有提供这样的功能,所以小编采用了linux 中crontab的方式进行定时任务的爬取
方案一:
编写shell脚本文件cron.sh
#! /bin/bash

export PATH=$PATH:/usr/local/bin

cd /home/python3/scrapydemo/Ak17/AK17/spiders

nohup scrapy crawl novel >> novel.log 2>&1 &
终端执行命令crontab -e,规定crontab要执行的命令和要执行的时间频率,这里我需要每5分钟就执行scrapy crawl novel 这条爬取命令:
# daemon's notion of time and timezones.

#

# Output of the crontab jobs (including errors) is sent through

# email to the user the crontab file belongs to (unless redirected).

#

# For example, you can run a backup of all your user accounts

# at 5 a.m every week with:

# 0 5 * * 1 tar -zcf /var/backups/home.tgz /home/

#

# For more information see the manual pages of crontab(5) and cron(8)

#

# m h  dom mon dow   command

*/5 * * * * sh /home/python3/scrapydemo/Ak17/cron.sh
* 如果报错No MTA installed, discarding output,可以重定向到/dev/null,这个文件是一个无底洞,无法打开
例如:*/5 * * * * sh /home/python3/scrapydemo/Ak17/cron.sh > /dev/null 2>&1
如果输入crontab -e后显示如下,直接随便输入一个数字即可,小编这里输入的2
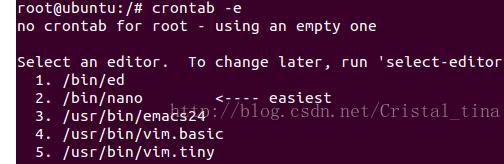
编辑好后,执行命令打开crontab的日志,默认linux系统是不开启的,将cron.*这一行前的注释打开:
vi /etc/rsyslog.d/50-default.conf

重启系统日志服务
sudo service rsyslog restart
最后就可以使用tail –f /var/log/cron.log查看crontab的日志了
方案二:
和方案一唯一的区别是没有日志的输出信息,直接修改定时任务即可
终端执行命令crontab -e,规定crontab要执行的命令和要执行的时间频率
# daemon's notion of time and timezones.

#

# Output of the crontab jobs (including errors) is sent through

# email to the user the crontab file belongs to (unless redirected).

#

# For example, you can run a backup of all your user accounts

# at 5 a.m every week with:

# 0 5 * * 1 tar -zcf /var/backups/home.tgz /home/

#

# For more information see the manual pages of crontab(5) and cron(8)

#

# m h  dom mon dow   command

*/5 * * * * cd /home/python3/scrapydemo/Ak17/AK17/spiders && /usr/local/bin/scrapy crawl novel
关闭定时任务:
scrapy的setting中添加一个配置项
CLOSESPIDER_TIMEOUT = 82800 # 23小时后结束爬虫
解释一下
CLOSESPIDER_TIMEOUT
默认值: 0
一个整数值,单位为秒。如果一个spider在指定的秒数后仍在运行, 它将以 closespider_timeout 的原因被自动关闭。 如果值设置为0(或者没有设置),spiders不会因为超时而关闭。
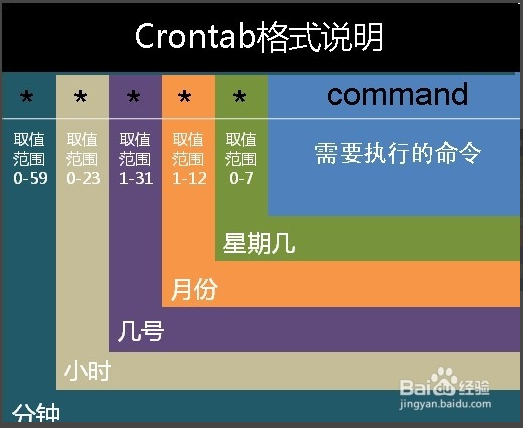
顺便说一下crontab的常见格式:
每分钟执行  */1 * * * *

每小时执行     0 * * * *

每天执行        0 0 * * *

每周执行       0 0 * * 0

每月执行        0 0 1 * *

每年执行       0 0 1 1 *
Scrapy定时执行爬取任务与定时关闭任务的更多相关文章
- scrapy定时执行抓取任务
在ubuntu环境下,使用scrapy定时执行抓取任务,由于scrapy本身没有提供定时执行的功能,所以采用了crontab的方式进行定时执行: 首先编写要执行的命令脚本cron.sh #! /bin ...
- node.js爬取数据并定时发送HTML邮件
node.js是前端程序员不可不学的一个框架,我们可以通过它来爬取数据.发送邮件.存取数据等等.下面我们通过koa2框架简单的只有一个小爬虫并使用定时任务来发送小邮件! 首先我们先来看一下效果图 差不 ...
- 爬虫系列5:scrapy动态页面爬取的另一种思路
前面有篇文章给出了爬取动态页面的一种思路,即应用Selenium+Firefox(参考<scrapy动态页面爬取>).但是selenium需要运行本地浏览器,比较耗时,不太适合大规模网页抓 ...
- 安居客scrapy房产信息爬取到数据可视化(下)-可视化代码
接上篇:安居客scrapy房产信息爬取到数据可视化(下)-可视化代码,可视化的实现~ 先看看保存的数据吧~ 本人之前都是习惯把爬到的数据保存到本地json文件, 这次保存到数据库后发现使用mongod ...
- python 3.6 urllib库实现天气爬取、邮件定时给妹子发送天气
#由于每天早上要和妹子说早安,于是做个定时任务,每天早上自动爬取天气,发送天气问好邮件##涉及模块:#(1)定时任务:windows的定时任务# 配置教程链接:http://b ...
- nutch的定时增量爬取
译文来着: http://wiki.apache.org/nutch/Crawl 介绍(Introduction) 注意:脚本中没有直接使用Nutch的爬去命令(bin/nutch crawl或者是& ...
- scrapy爬虫案例--爬取阳关热线问政平台
阳光热线问政平台:http://wz.sun0769.com/political/index/politicsNewest?id=1&page=1 爬取最新问政帖子的编号.投诉标题.投诉内容以 ...
- Scrapy实战篇(八)之Scrapy对接selenium爬取京东商城商品数据
本篇目标:我们以爬取京东商城商品数据为例,展示Scrapy框架对接selenium爬取京东商城商品数据. 背景: 京东商城页面为js动态加载页面,直接使用request请求,无法得到我们想要的商品数据 ...
- Scrapy实战篇(六)之Scrapy配合Selenium爬取京东信息(上)
在之前的一篇实战之中,我们已经爬取过京东商城的文胸数据,但是前面的那一篇其实是有一个缺陷的,不知道你看出来没有,下面就来详细的说明和解决这个缺陷. 我们在京东搜索页面输入关键字进行搜索的时候,页面的返 ...
随机推荐
- 使用Listview控件显示数据
1.图像列表控件 ImageList是含有图像对象的集合,可以通过索引或关键字引用该集合中的每个对象. ImageList空间的属性 属性 说明 Images 存储在图像列表中的所有图像 ImageS ...
- Jquery判断checkbox是否被选中
jQuery中: $("input[type='checkbox']").is(':checked') 返回true或false 1.attr()方法 设置或者返回备选元素的值 ...
- web服务器学习3---httpd 2.4.29日志处理
.rotarelogs分割工具 如果有虚拟主机在虚拟主机配置文件中配置,否则在主配置文件中修改. 1.1修改配置文件 vi /usr/local/httpd/conf/conf.d/vhosts.co ...
- 系统右键添加cmd命令
我们运行cmd.exe时,会发现刚刚打开时,一般提示在默认路径下: 有时候我们希望直接能够切换到某个路径下运行程序或者做某些工作,那么切换路径可能就会比较麻烦.下面我们介绍一种比较实用的方法,用鼠标右 ...
- 个人作业2——NBA 2k18案例分析
产品:篮球体育类游戏NBA 2k18 选择理由:这款游戏是<NBA 2k>的正统续作,自己和身边的朋友都对篮球比较感兴趣,经常看NBA,所以近几年的版本都有购买下载,加上游戏中人物动作比较 ...
- TCP和UDP的最完整的区别
TCP UDP TCP与UDP基本区别 1.基于连接与无连接 2.TCP要求系统资源较多,UDP较少: 3.UDP程序结构较简单 4.流模式(TCP)与数据报模式(UDP); ...
- Vim 中文社区:期待你的加入
我们的愿景 Vim 中文社区一直比较零散,缺少凝聚力,现有的一些群经常也是水的可以的,讨论各种无关紧要的内容,于是导致很大一部分人,将这些群丢入了群助手,渐渐地他们也淡出了 vim 中文社区. 而我理 ...
- python之路--day11---迭代器和生成器
迭代: 迭代是一个重复的过程,每次重复即一次迭代,并且每次迭代的结果都是下一次迭代的初始值 为什么要有迭代器: 数据类型的取值,字符串,列表,元组依靠索引可以取值,但是字典,集合,文件这些数据类型无法 ...
- Linux进程管理:查杀进程
一.查看进程 Linux下显示系统进程的命令ps,最常用的有ps -ef 和ps aux.这两个到底有什么区别呢? 两者没太大差别,讨论这个问题,要追溯到Unix系统中的两种风格,System V风格 ...
- Spring Security入门(1-13)Spring Security的投票机制和投票器
1.三种表决方式,默认是 一票制AffirmativeBased public interface AccessDecisionManager { /** * 通过传递的参数来决定用户是否有访问对应受 ...