
Spark core 总结
Spark
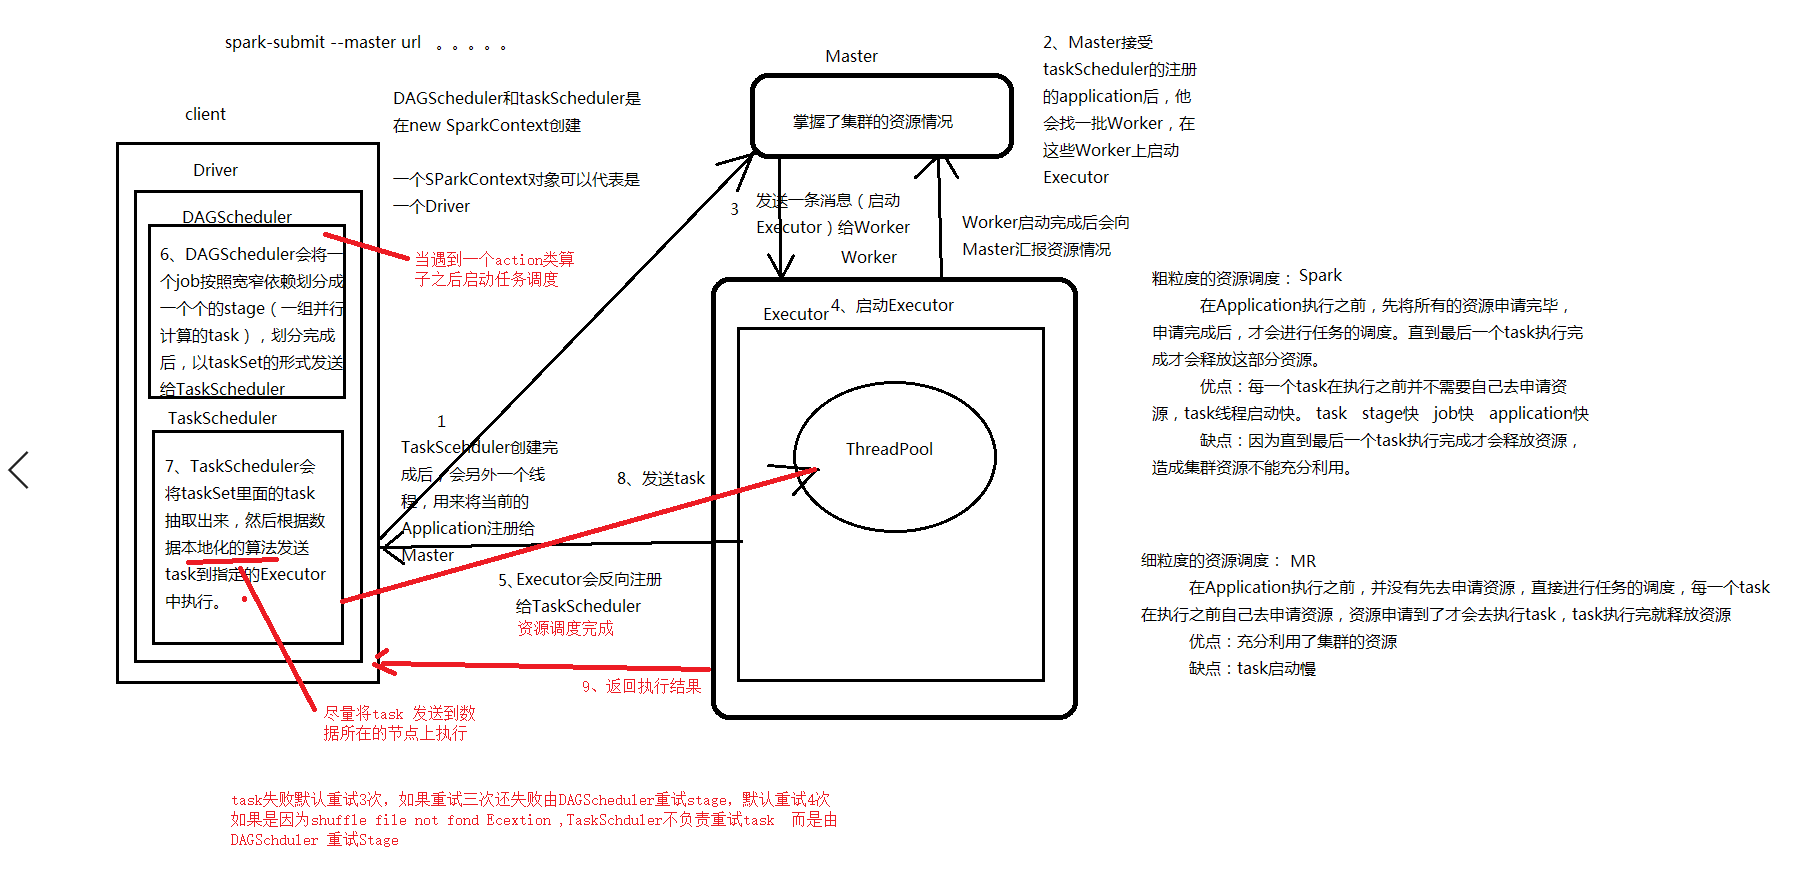
RDD五大特性
1、RDD由一组partition组成
2、每一个分区由一个task来处理
3、RDD之间有一些列依赖关系
4、分区类算子必须作用在kv格式得RDD上
5、spark为task执行提供了最佳计算位置,尽量将task发送到数据所在节点执行
spark 快的原因
1、spark 尽量将数据放在内存
spark容易出现OOM
2、粗粒度资源申请
在应用程序启动的时候就会申请所有资源
3、DAG有向无环图
优化转换过程
Driver
spark 程序的主程序
1、负责申请资源
new SparkContext
2、负责任务调度
发送task到Excutor中执行
Excutor
spark应用程序执行器
standalone
worker所在节点启动
yarn
NodeManager所在节点启动
执行task任务,向Driver汇报task执行情况
环境搭建
local
本地测试
需要本地安装hadoop
standalone
使用spark自带资源管理框架
Driver向Master申请资源
节点组成
master
管理资源和分配资源
存在单点问题
client
在本地打印运行日志
一般用于上线前测试
Driver在本地(提交任务的节点)启动
Driver即负责资源申请也负责任务调度
cluster
日志不再本地打印
Driver在集群中启动
随便选择一个Worker中启动Driver
一般用于上线运行
yarn
使用hadoop的yarn作为资源管理框架
提交任务 Driver去ResourceManasger中申请资源
通过实现applicationMaster接口往yarn里面提交任务
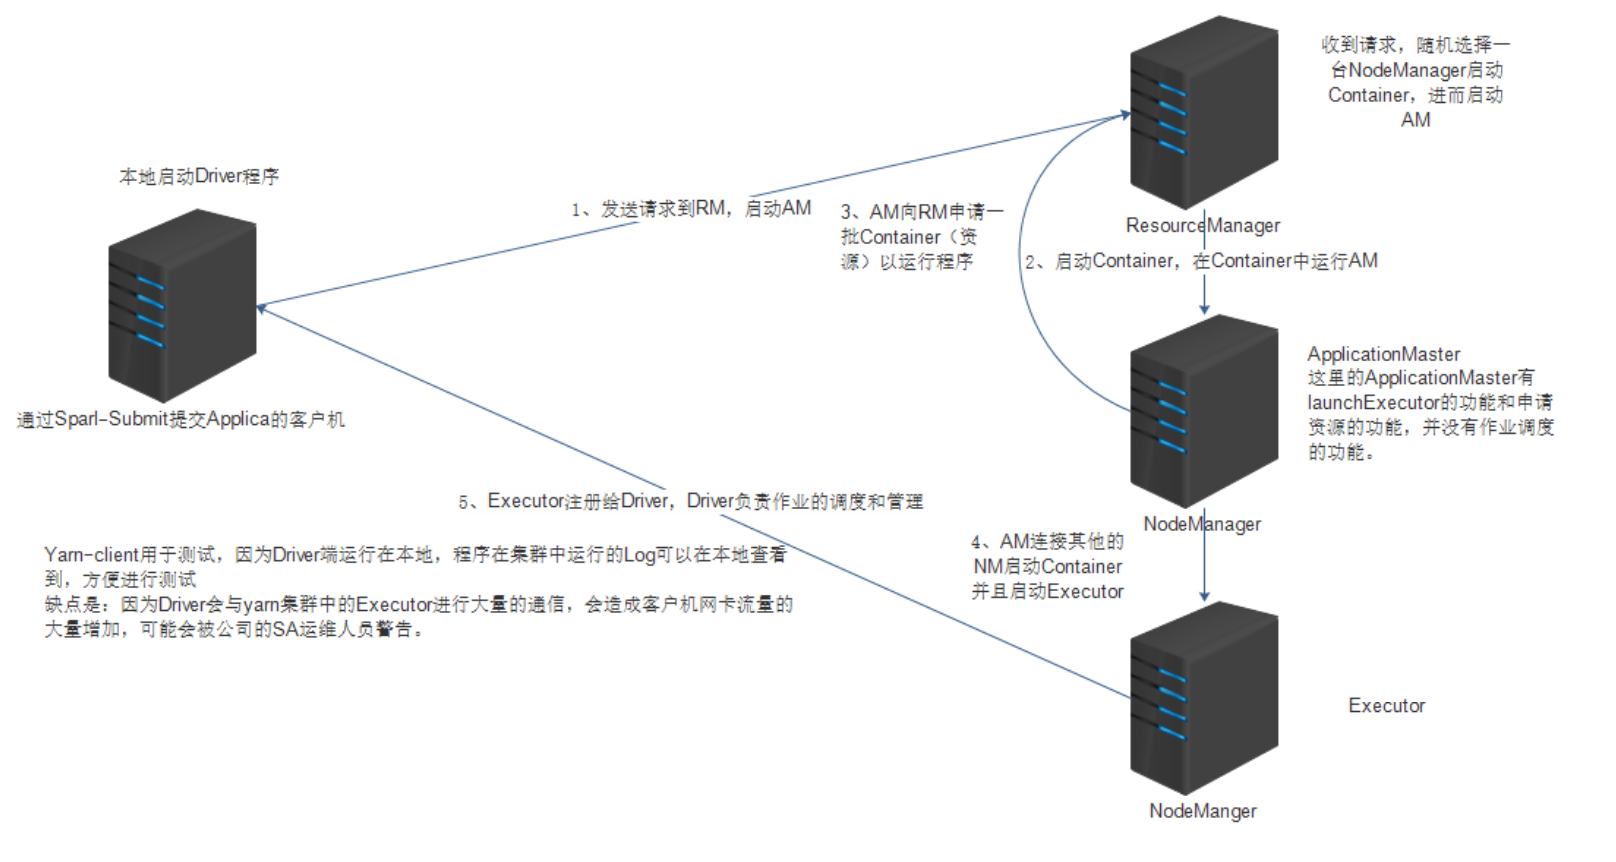
yarn-client
在本地打印运行日志
一般用于上线前测试
Driver在本地(提交任务的节点)启动
Driver只负责任务调度
启动ApplicationMaster 为spark应用程序申请资源
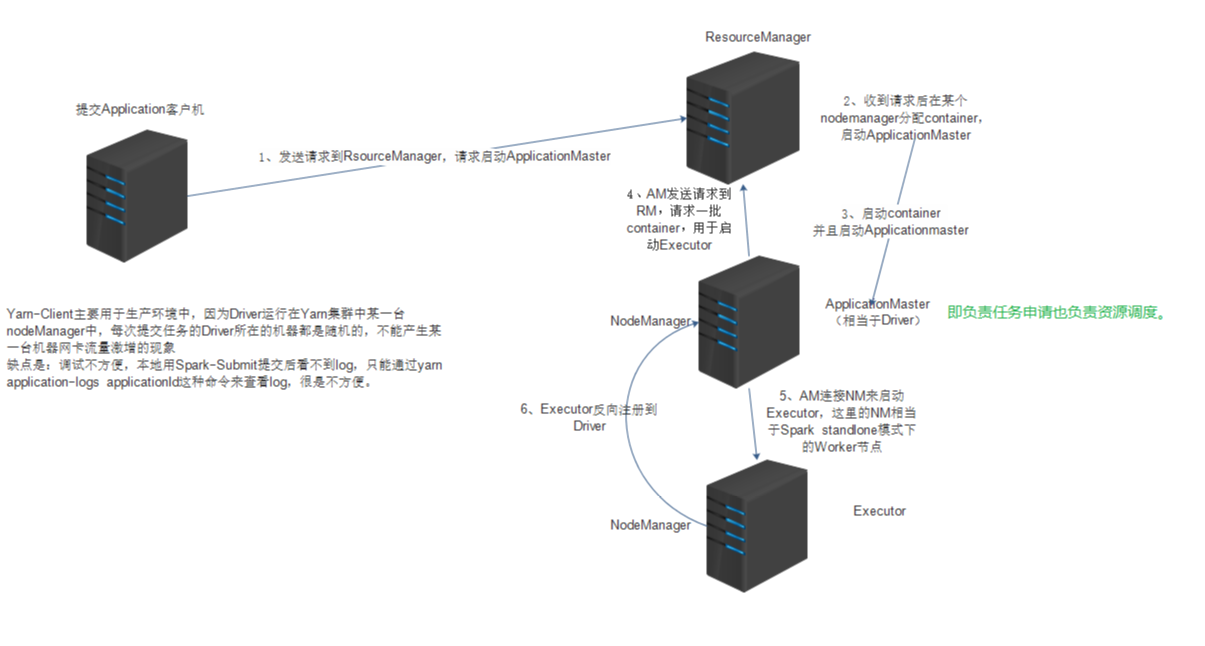
yarn-cluster
日志不再本地打印
一般用于上线运行
Driver(ApplicationMaster)在集群启动
Driver即负责资源申请也负责任务调度
常用算子
transformations算子
map
传入一个对象返回一个对象
flatMap
Filter
返回true保留数据,返回false过滤数据
groupByKey,groupBy
reduceBykey
reduceByKey在map端进行预聚合
union
join
sample
sortBy, sortByKey
rePartition ,partitionBy(自定义分区器)
重新分区,会产生shuffle
mapValues
action算子
foreach
reduce
在map预聚合
save
collect collectAsMap
分区
1、第一个RDD分区数有block数量决定(和mr一样), inputformat
2、后续rdd分区数量
1、默认数去数量等于前一个rdd分区数量
2、在使用shuffle类算子得时候可以执行分区数量
缓存
1、RDD默认不保存数据 2,懒执行
cache
是一个转换算子,不会触发job,需要接收
将数据放Excutor内存中, persist(StorageLevel.MEMORY_ONLY)
persist
可以指定缓存级别
1、是否放内存
2、是否放磁盘
3、是否放堆外内存
4、是否序列化
压缩
1、好处:数据量变小,占用空间更小
2、缺点:序列化和反序列化需要浪费cpu执行时间
5、副本数
选择缓存级别
1、内存充足
MEMORY_ONLY
2、内存不是很多
MEMORY_AND_DISK_SER
尽量将数据压缩之后i放内存
3、内存不足
DISK_ONLY
既然已经放磁盘了,就不必要压缩了
checkpoint
1、将RDD得数据写入hdfs
2,checkpoing会切断RDD依赖关系
3、从最后一个RDD向前回溯,对checkpoint的RDD进行标记,另启动一个job重新计算rdd的数据,并rdd数据写入hdfs(也就是遇到actions算子后启动一个job进行回溯,遇到checkpoint再次启动一个job)
优化:在checkpoint之前先进行cache(避免重读计算)

pagerank
网页排名
计算过程
1、每个网页一个初始值
2、通过不断迭代计算新的pr值
资源调度和任务调度
资源调度
1、细粒度资源调度
MapReduce
每一个task都需要单独申请资源
task启动速度较慢
资源充分利用
2、粗粒度资源调度
spark
在应用程序启动的时候就会将所有需要的资源全部申请下来,后面task执行变快
资源浪费(资源没有充分的利用,在执行的过程中无法进行释放,只有当作业全部进行完毕后才释放)
3、spark资源调度流程 yarn-cluster
1、通过spark-submit提交任务
2、在本地启动Driver val sc = new SparkContext(conf)
3、Driver发请求给RM 启动AM
4、RM分配资源启动AM
5、AM向RM申请资源启动Excutor
6、AM分配资源启动Excutor
7、Excutor反向注册给Driver
8、开始任务调度(action算子触发)
任务调度
1、当遇到一个action算子,启动job,开始任务调度
2、构建DAG有向无环图
3、DAGScheduler 根据宽窄依赖切分Stage (stage是一个可以并行计算的task)
4、DAGScheduler 将stage以taskSet的形式发送给TaskScheduler
5、TaskScheduler 根据本地化算法将task发送到数据所在节点去执行
6、TaskScheduler收集tasK执行情况
如果task失败TaskScheduler默认重试3次
如果重试3次之后还失败,由DAGScheduler重试stage 默认重试4次
如果是因为shuffle过程中拉去文件失败发生的异常,TaskScheduler不负责重试task,而是由DAGScheduler重试上一个stage
TaskScheduler 推测执行
如果有一个task执行很慢,TaskScheduler会在启动一个task去竞争,谁先执行完,以谁的为准
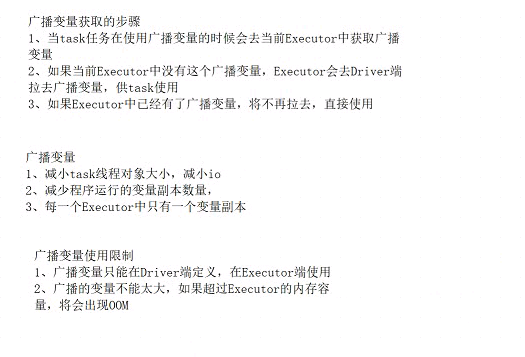
广播变量
如果不使用广播变量变量副本等于task数量
如果使用广播变量变量副本等于Executor数量
广播变量只能在Driver定义,在Executor端读取
rdd 算子里面不能使用其它rdd
累加器
全局累加变量
1、只能在Driver端定义
2、只能Executor端累加
3、只能在Driver读取
spark shuffle
hash shuffle
产生小文件的数量:m*r
hash shuffle manager
产生小文件的数量:c*r
sort shuffle 默认
产生小文件的数量:2*m
sort shuffle bypass机制
产生小文件的数量:2*m
数据在map端不会排序
当 reduce数量小于 spark.shuffle.sort.bypassMergeThreshold=200触发bypass机制
快的原因
尽量将数据放到内存里面进行计算
粗粒度资源调度
DAG有向无环图
切分Stoge
RDD五大特性
1、RDD由一组partition组成
2、函数操作实际是作用在每个partition上
3、RDD之间由一系列依赖关系
4、分区类算子必须作用在kv格式的rdd上
reducebeykey,groupbykey
5、spark为task执行提供了最佳计算位置
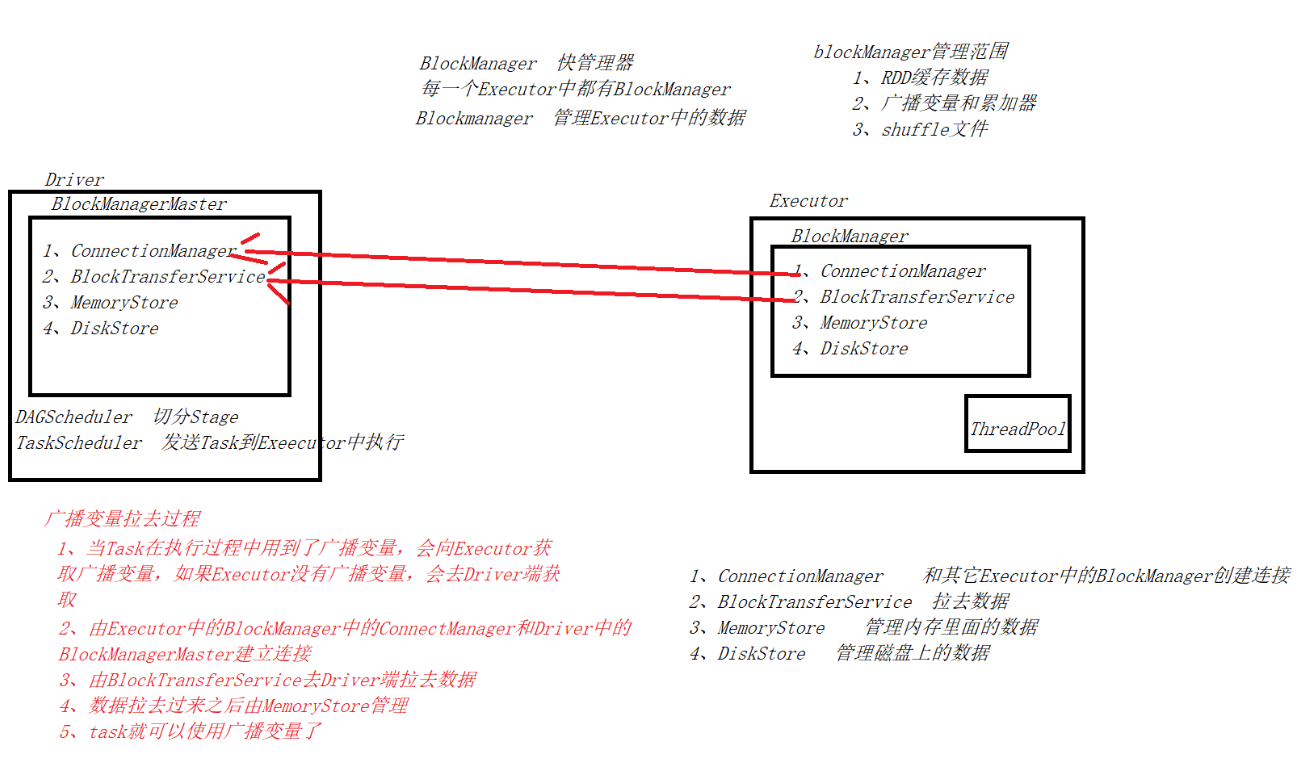
BlockManager
每个Executor中都有一个
管理数据
1、RDD缓存数据
2、shuffle数据
3、广播变量和累加器

Spark core 总结的更多相关文章
- Spark Streaming揭秘 Day35 Spark core思考
Spark Streaming揭秘 Day35 Spark core思考 Spark上的子框架,都是后来加上去的.都是在Spark core上完成的,所有框架一切的实现最终还是由Spark core来 ...
- 【Spark Core】任务运行机制和Task源代码浅析1
引言 上一小节<TaskScheduler源代码与任务提交原理浅析2>介绍了Driver側将Stage进行划分.依据Executor闲置情况分发任务,终于通过DriverActor向exe ...
- TypeError: Error #1034: 强制转换类型失败:无法将 mx.controls::DataGrid@9a7c0a1 转换为 spark.core.IViewport。
1.错误描述 TypeError: Error #1034: 强制转换类型失败:无法将 mx.controls::DataGrid@9aa90a1 转换为 spark.core.IViewport. ...
- Spark Core
Spark Core DAG概念 有向无环图 Spark会根据用户提交的计算逻辑中的RDD的转换(变换方法)和动作(action方法)来生成RDD之间的依赖关系,同时 ...
- spark core (二)
一.Spark-Shell交互式工具 1.Spark-Shell交互式工具 Spark-Shell提供了一种学习API的简单方式, 以及一个能够交互式分析数据的强大工具. 在Scala语言环境下或Py ...
- Spark Core 资源调度与任务调度(standalone client 流程描述)
Spark Core 资源调度与任务调度(standalone client 流程描述) Spark集群启动: 集群启动后,Worker会向Master汇报资源情况(实际上将Worker的资 ...
- 大数据技术之_27_电商平台数据分析项目_02_预备知识 + Scala + Spark Core + Spark SQL + Spark Streaming + Java 对象池
第0章 预备知识0.1 Scala0.1.1 Scala 操作符0.1.2 拉链操作0.2 Spark Core0.2.1 Spark RDD 持久化0.2.2 Spark 共享变量0.3 Spark ...
- SparkSQL 与 Spark Core的关系
不多说,直接上干货! SparkSQL 与 Spark Core的关系 Spark SQL构建在Spark Core之上,专门用来处理结构化数据(不仅仅是SQL). Spark SQL在Spark C ...
- Spark Core知识点复习-1
Day1111 Spark任务调度 Spark几个重要组件 Spark Core RDD的概念和特性 生成RDD的两种类型 RDD算子的两种类型 算子练习 分区 RDD的依赖关系 DAG:有向无环图 ...
- Spark Core知识点复习-2
day1112 1.spark core复习 任务提交 缓存 checkPoint 自定义排序 自定义分区器 自定义累加器 广播变量 Spark Shuffle过程 SparkSQL 一. Spark ...
随机推荐
- COSBrowser文件编辑-随时随地在线编辑
本文介绍如何通过COSBrowser文件在线编辑功能更方便的使用云上存储的数据. 痛点分析 日常工作和生活中,我们需要把记录的文档.编写的文案.音视频文件保存管理好,又担心设备损坏.文件丢失或是更换设 ...
- VB 不应该是这副模样出现
和同时代的其它语言比,VB 设计的太烂了,应景之作,充满了各种小聪明. 当时有 JS, 有 python,VB 的设计者不懂参考借鉴,给出的是一个连继承都没有的设计. VB 的语言设计问题极多, 首选 ...
- Linux 网络设置及管理
Linux 网络管理 网络管理 1.使用NetworkManager管理网络 NetworkManager(网络管理器)是一个动态网络的控制器与配置系统,它用于当网络设备可用时保持设备连接和开启并激活 ...
- Linux readonly
1. 概念readonly在shell脚本中,用来标记变量是只读的,后续执行过程中就不能对其值进行改变,这个用来定义一些常量类的变量. 如果对其进行重新赋值,会提示错误 [root@localhost ...
- mapstruct坑:Internal error in the mapping processor: java.lang.NullPointerException at org.mapstruct.
错误描述 项目中如果使用了mapstruct框架,在使用Idea新版本后,启动会报错! Internal error in the mapping processor: java.lang.NullP ...
- 【转载】 DirectByteBuffer内存释放
http://www.tianshouzhi.com/api/tutorials/netty/331 我们已经知道,在网络编程中,为了避免频繁的在用户空间与内核空间拷贝数据,通常会直接从内核空间中申请 ...
- Qt开发经验小技巧246-250
在编写类中有时候需要对变量进行赋值和取值,这时候一般用 setxxx.getxxx 之类的函数进行处理,而且往往里面就一行代码,这时候你可能会思考为何不直接将变量改成public暴露出来使用,还可以省 ...
- 【OpenCV】features2d_converters.cpp:2:10: fatal error: common.h: 没有那个文件或目录
Linux环境下使用opencv的dnn模块调用yolov4遇到的坑(纯CPU)一.问题描述Ubuntu安装opencv4.4,第一次编译完成安装成功,发现编译时少加了几个选项,于是重新编译,结果报如 ...
- 大端地址 小端地址 网络字节序 intel主机字节序
小端字节序:低字节数据存放在内存低地址处,高字节数据存放在内存高地址处:大端字节序:高字节数据存放在内存低地址处,低字节数据存放在内存高地址处. 网络字节序: MSB 高字节前存法 Most Sign ...
- 史上最通俗Netty入门长文:基本介绍、环境搭建、动手实战
原作者江成军,原题"还在被Java NIO虐?该试试Netty了",收录时有修订和改动. 1.阅读对象 本文适合对Netty一无所知的Java NIO网络编程新手阅读,为了做到这一 ...