
Flink-cdc同步mysql到iceberg丢失数据排查
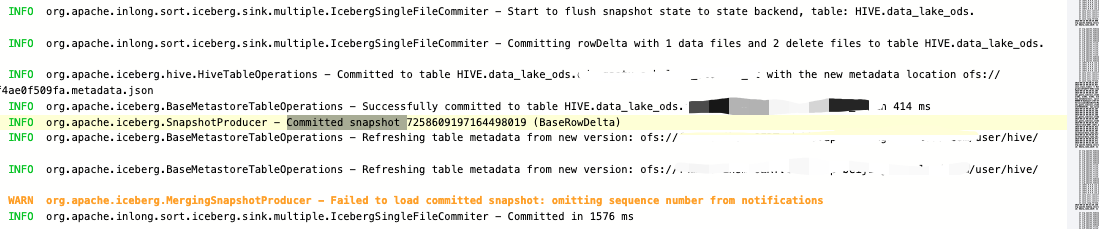
Emit iceberg write result dataFiles: [

GenericDataFile{content=data, file_path=ofs://sss/test1235/data/00000-0-8a53aa17-c767-47bd-b865-32e13d54bd8e-02520.parquet, file_format=PARQUET, spec_id=0, partition=PartitionData{}, record_count=592, file_size_in_bytes=1067447, column_sizes={1=2113, 2=2077, 3=2393, 4=3018, 5=1667, 6=166, 7=95, 8=1412, 9=1121, 10=163, 11=1409}, value_counts={1=592, 2=592, 3=592, 4=592, 5=592, 6=592, 7=592, 8=592, 9=592, 10=592, 11=592}, null_value_counts={1=0, 2=0, 3=0, 4=0, 5=0, 6=0, 7=0, 8=0, 9=0, 10=0, 11=0}, nan_value_counts={}, lower_bounds=org.apache.iceberg.SerializableByteBufferMap@fcc2b49e, upper_bounds=org.apache.iceberg.SerializableByteBufferMap@1b557080, key_metadata=null, split_offsets=[4], equality_ids=null, sort_order_id=0}],

result.deleteFiles [GenericDeleteFile{content=equality_deletes, file_path=ofs://sss/test1235/data/00000-0-8a53aa17-c767-47bd-b865-32e13d54bd8e-02521.parquet, file_format=PARQUET, spec_id=0, partition=PartitionData{}, record_count=534, file_size_in_bytes=1050981, column_sizes={1=1931}, value_counts={1=534}, null_value_counts={1=0}, nan_value_counts={}, lower_bounds=org.apache.iceberg.SerializableByteBufferMap@471b5f22, upper_bounds=org.apache.iceberg.SerializableByteBufferMap@9fc9501c, key_metadata=null, split_offsets=null, equality_ids=[1], sort_order_id=0},

GenericDeleteFile{content=position_deletes, file_path=ofs://sss/test1235/data/00000-0-8a53aa17-c767-47bd-b865-32e13d54bd8e-02522.parquet, file_format=PARQUET, spec_id=0, partition=PartitionData{}, record_count=58, file_size_in_bytes=2004, column_sizes={2147483546=239, 2147483545=153}, value_counts={2147483546=58, 2147483545=58}, null_value_counts={2147483546=0, 2147483545=0}, nan_value_counts={}, lower_bounds=org.apache.iceberg.SerializableByteBufferMap@c337bae4, upper_bounds=org.apache.iceberg.SerializableByteBufferMap@c337baa5, key_metadata=null, split_offsets=null, equality_ids=null, sort_order_id=null}] 
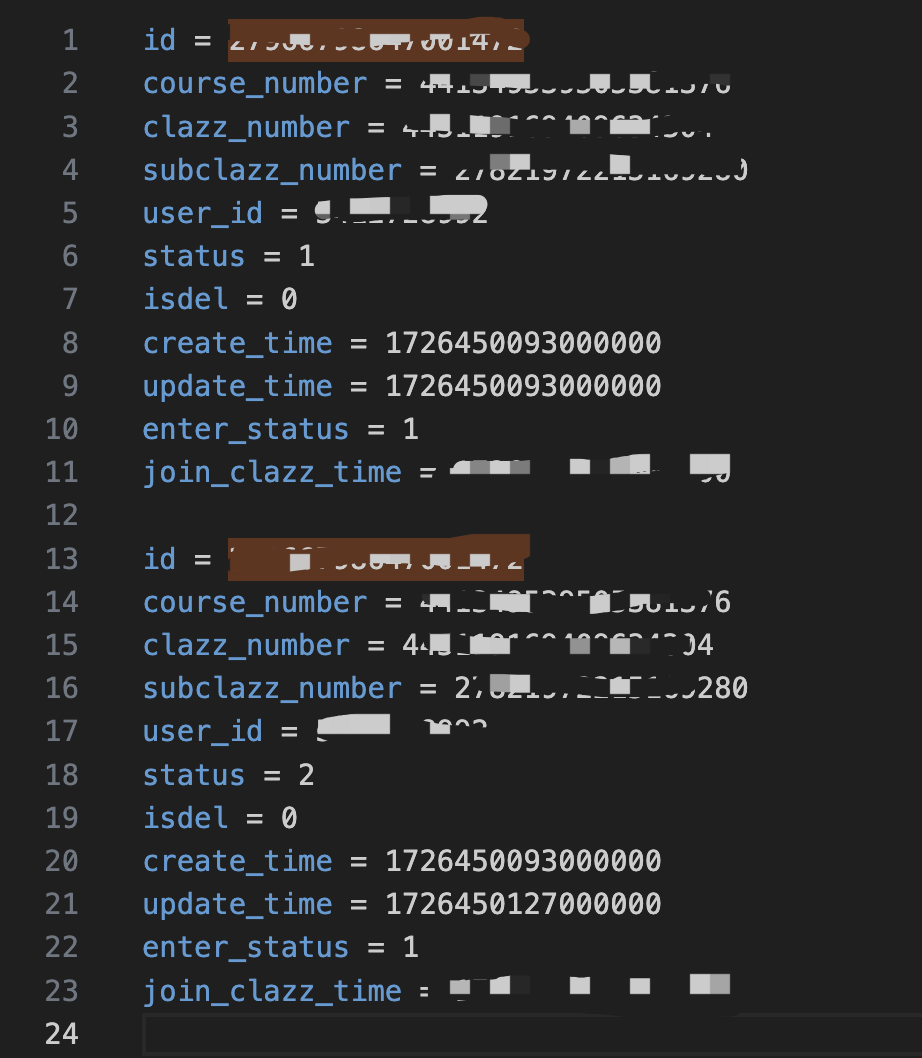
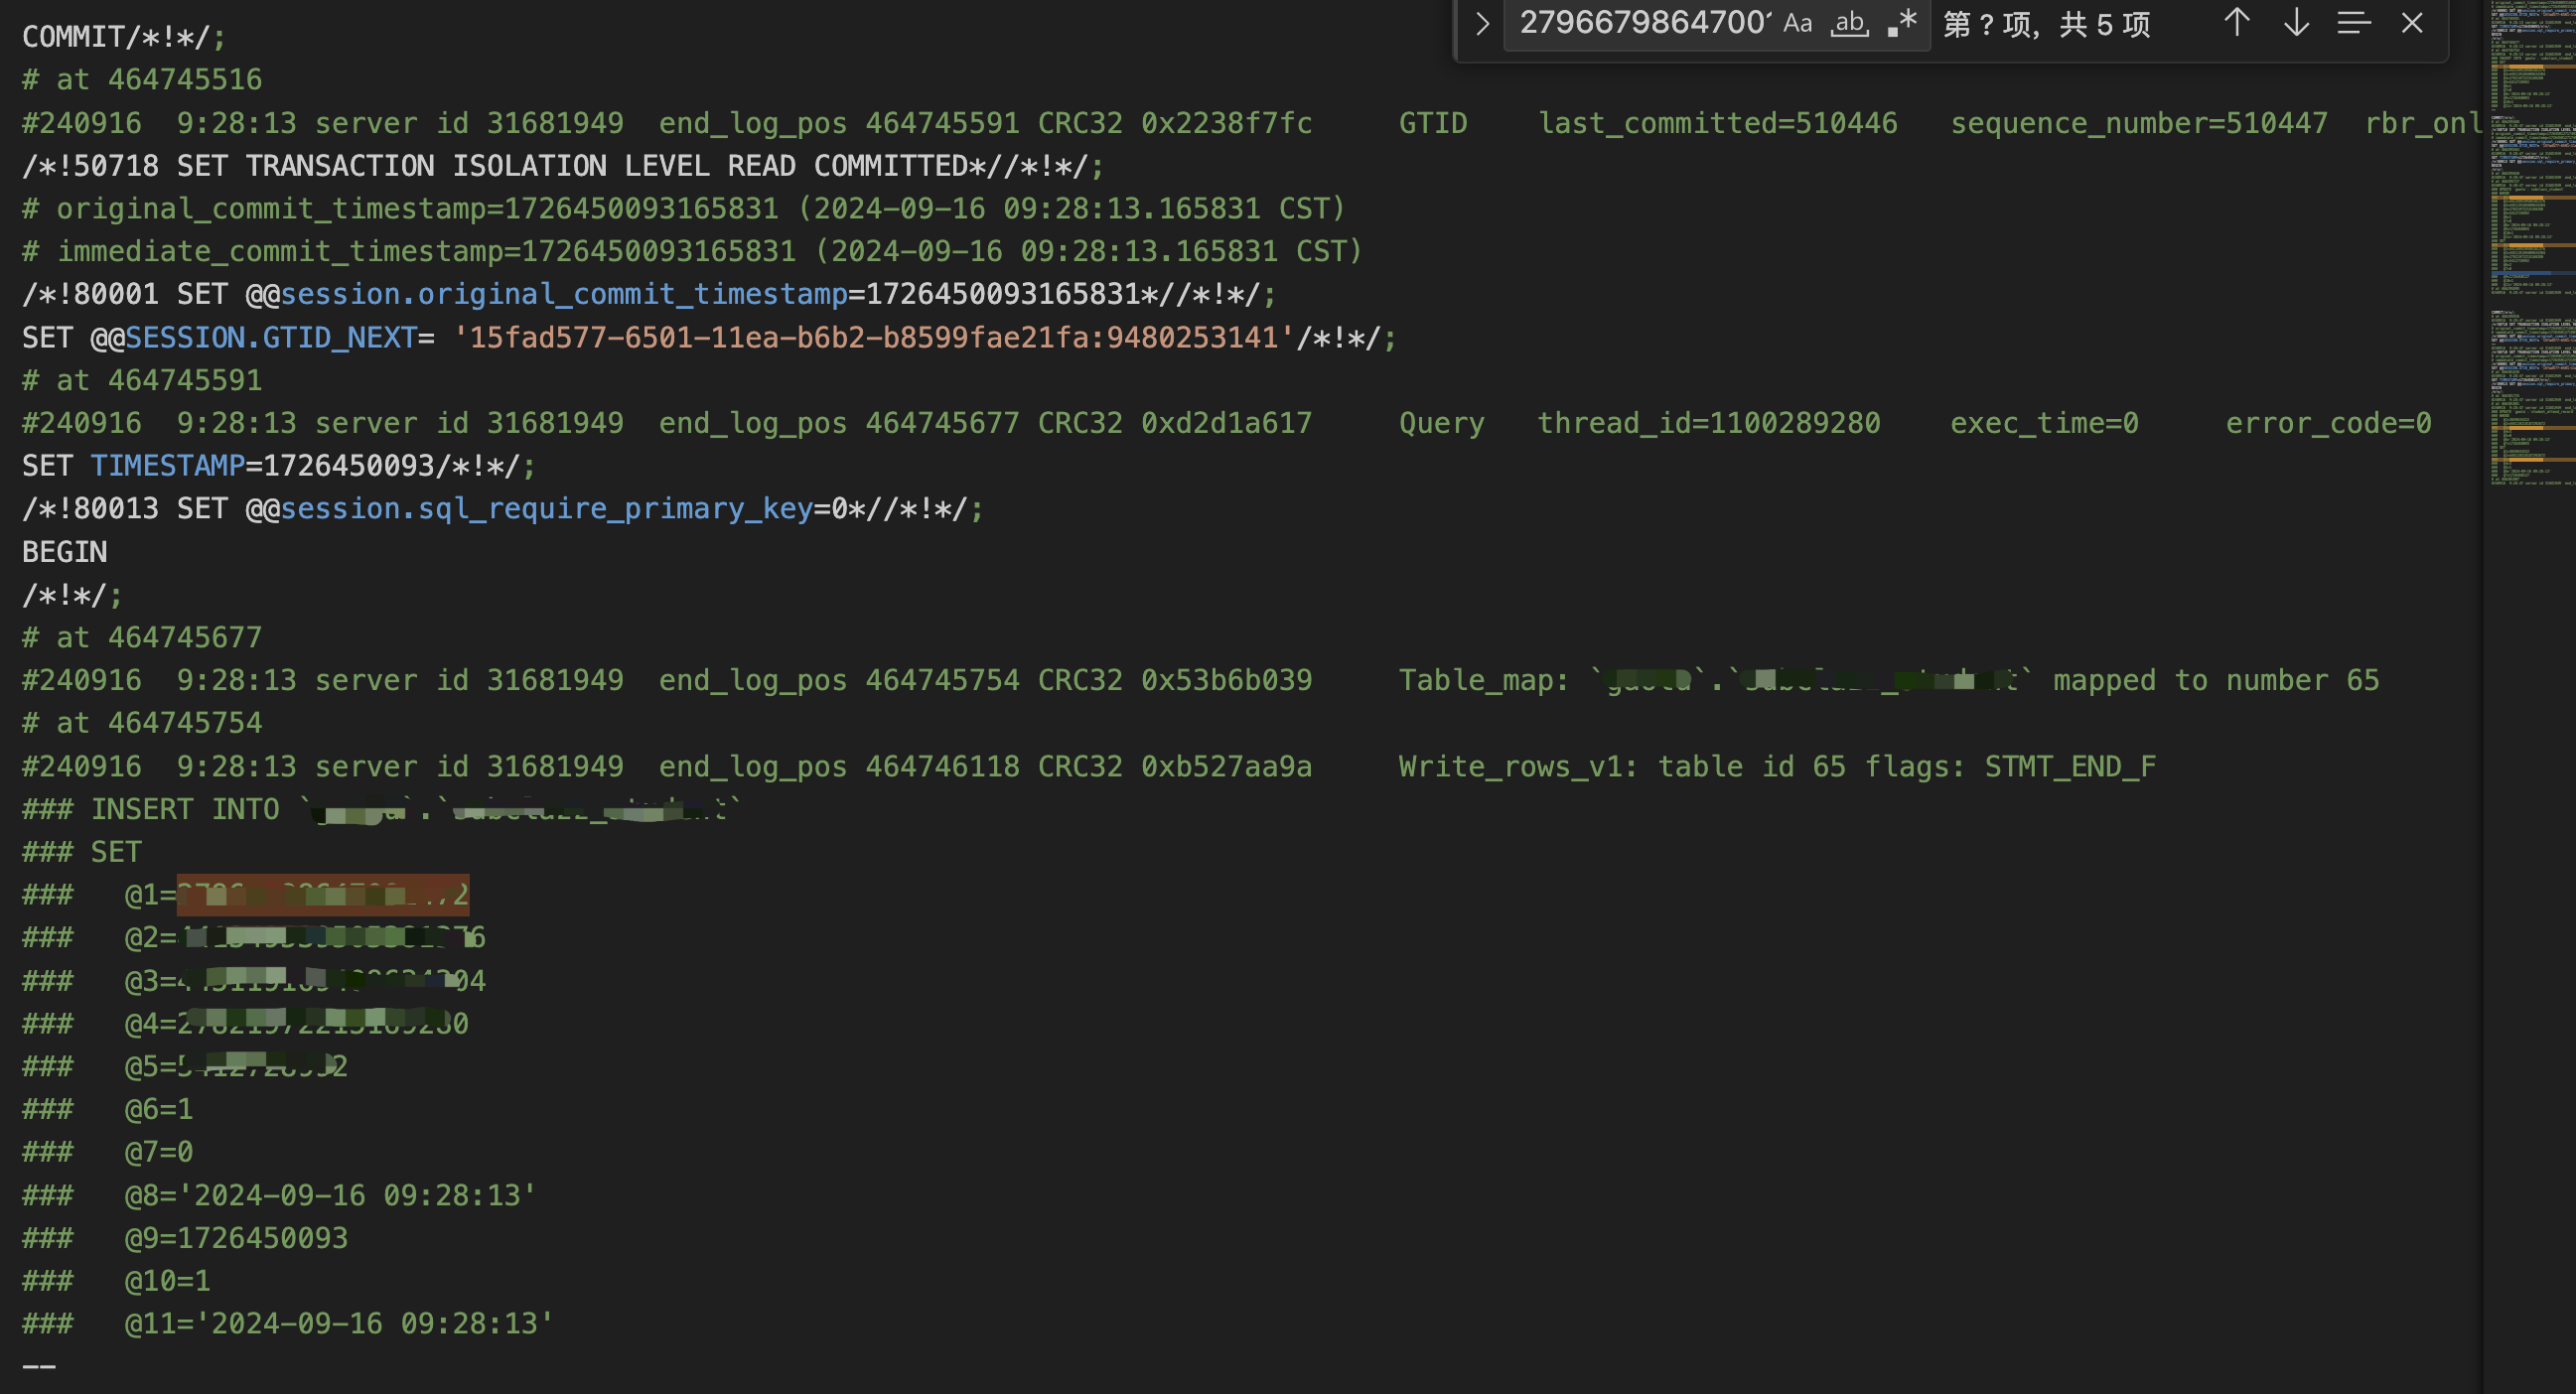
2024-09-16 09:25:53.026 [Source: MySQL-CDC- -> Calc(select=[id, course_number, clazz_number, subclazz_number, user_id, CAST(status) AS status, CASE(isdel IS NOT NULL, CASE(isdel, 1, 0), null:INTEGER) AS isdel, CAST(create_time) AS create_time, CAST(update_time) AS update_time, enter_status, CAST(join_clazz_time) AS join_clazz_time]) -> NotNullEnforcer(fields=[id]) (1/1)#0] INFO

com.ververica.cdc.connectors.mysql.source.reader.MySqlSourceReader - Binlog offset on checkpoint 859: {transaction_id=null, ts_sec=1726449952, file=mysql-bin.022296, pos=459680089, kind=SPECIFIC, gtids=15fad577-6501-11ea-b6b2-b8599fae21fa:9456479883-9480246523, row=1, event=2, server_id=31681949}

2024-09-16 09:30:53.037 [Source: MySQL-CDC- -> Calc(select=[id, course_number, clazz_number, subclazz_number, user_id, CAST(status) AS status, CASE(isdel IS NOT NULL, CASE(isdel, 1, 0), null:INTEGER) AS isdel, CAST(create_time) AS create_time, CAST(update_time) AS update_time, enter_status, CAST(join_clazz_time) AS join_clazz_time]) -> NotNullEnforcer(fields=[id]) (1/1)#0] INFO

com.ververica.cdc.connectors.mysql.source.reader.MySqlSourceReader - Binlog offset on checkpoint 860: {transaction_id=null, ts_sec=1726450252, file=mysql-bin.022296, pos=474797741, kind=SPECIFIC, gtids=15fad577-6501-11ea-b6b2-b8599fae21fa:9456479883-9480269403, row=1, event=2, server_id=31681949}

Flink-cdc同步mysql到iceberg丢失数据排查的更多相关文章
- Elasticsearch的快速使用——Spring Boot使用Elastcisearch, 并且使用Logstash同步mysql和Elasticsearch的数据
我主要是给出一些方向,很多地方没有详细说明.当时我学习的时候一直不知道怎么着手,花时间找入口点上比较多,你们可以直接顺着方向去找资源学习. 如果不是Spring Boot项目,那么根据Elastics ...
- MySQL不会丢失数据的秘密,就藏在它的 7种日志里
本文收录在 GitHub 地址 https://github.com/chengxy-nds/Springboot-Notebook 进入正题前先简单看看MySQL的逻辑架构,相信我用的着. MySQ ...
- Canal:同步mysql增量数据工具,一篇详解核心知识点
老刘是一名即将找工作的研二学生,写博客一方面是总结大数据开发的知识点,一方面是希望能够帮助伙伴让自学从此不求人.由于老刘是自学大数据开发,博客中肯定会存在一些不足,还希望大家能够批评指正,让我们一起进 ...
- 电商网站垮IDC数据备份,MySql主从同步,图片及其它数据文件的同步
原文网址:http://www.bzfshop.net/article/180.html 对一个电子商务网站而言,最宝贵的资源就是数据.服务器是很廉价的东西,即使烧了好几个也问题不大,但是用户数据如果 ...
- 基于 MySQL Binlog 的 Elasticsearch 数据同步实践 原
一.背景 随着马蜂窝的逐渐发展,我们的业务数据越来越多,单纯使用 MySQL 已经不能满足我们的数据查询需求,例如对于商品.订单等数据的多维度检索. 使用 Elasticsearch 存储业务数据可以 ...
- 基于MySQL Binlog的Elasticsearch数据同步实践
一.为什么要做 随着马蜂窝的逐渐发展,我们的业务数据越来越多,单纯使用 MySQL 已经不能满足我们的数据查询需求,例如对于商品.订单等数据的多维度检索. 使用 Elasticsearch 存储业务数 ...
- 通过Gearman实现MySQL到Redis的数据同步
对于变化频率非常快的数据来说,如果还选择传统的静态缓存方式(Memocached.File System等)展示数据,可能在缓存的存取上会有很大的开销,并不能很好的满足需要,而Redis这样基于内存的 ...
- 快速同步mysql数据到redis中
MYSQL快速同步数据到Redis 举例场景:存储游戏玩家的任务数据,游戏服务器启动时将mysql中玩家的数据同步到redis中. 从MySQL中将数据导入到Redis的Hash结构中.当然,最直接的 ...
- Gearman + Nodejs + MySQL UDF异步实现 MySQL 到 Redis 的数据同步
[TOC] 1, 环境 CentOS, MySQL, Redis, Nodejs 2, Redis简介 Redis是一个开源的K-V内存数据库,它的key可以是string/set/hash/list ...
- TiDB 作为 MySQL Slave 实现实时数据同步
由于 TiDB 本身兼容绝大多数的 MySQL 语法,所以对于绝大多数业务来说,最安全的切换数据库方式就是将 TiDB 作为现有数据库的从库接在主 MySQL 库的后方,这样对业务方实现完全没有侵入性 ...
随机推荐
- Win10多用户同时登陆
1. 说明: (1)Win服务器版默认是支持多用户登陆的,甚至可以在主机上用不同用户自己远程登陆自己,如window server 2016. (2)Win10正常情况下是不允许用户同时远程的,即一个 ...
- 全网最详细的Spring入门教程
为什么用Spring 什么是Spring Spring 是一款开源的轻量级 Java 开发框架,旨在提高开发人员的开发效率以及系统的可维护性. Spring的一个最大的目的就是使JAVA EE开发更加 ...
- 使用arcpy向server端发布服务
import arcpy import os # Set output file names outdir = r"D:" service = "MapImageShar ...
- sql 依据时间间隔分组,获取第一条数据
时序数据的数据量比较大,抛去异常点外,变化相对比较有线性规律,业务上需要对结果进行抽取显示. 原始数据时序标签(部分示例) 根据时间字段,计算时间字段和指定时间的时间戳差值,然后除以固定间隔(示例中间 ...
- 人工智能大语言模型起源篇(二),从通用语言微调到驾驭LLM
上一篇:<人工智能大语言模型起源篇(一),从哪里开始> (5)Howard 和 Ruder 于2018年发表的<Universal Language Model Fine-tunin ...
- 入门 .NET Aspire: 使用 .NET 简化云原生应用开发
入门 .NET Aspire: 使用 .NET 简化云原生应用开发 https://devblogs.microsoft.com/dotnet/introducing-dotnet-aspire-si ...
- 中电金信:GienTech动态|中标、入选、参会...近期精彩呈现!
中电金信参编业内首个银行核心系统分级度量标准 2024年6月6日,由中国信息通信研究院云计算与大数据研究所主办的"应用现代化赋能银行核心系统升级"交流会议在京召开.会议发布了业内首 ...
- cocos2d 的故事
https://en.wikipedia.org/wiki/Cocos2d The history of Cocos2d in a glimpse – RETRO.MOE http://los-coc ...
- django介绍及基本使用
目录 一.python主流web框架 二.django简介 1.版本问题 2.运行django注意事项 三.django基本使用 1.下载模块 2.验证 3.常见命令 4.pycharm自动创建dja ...
- 体验.NET与文件存储服务MinIO
对象文件存储服务(OSS)主要用于存储零散的文件,和直接存储到本地文件系统中相比,有以下的几个优势: 跨服务器可用 兼容Amazon S3 API 横向扩容 高可用 支持加密 MinIO就是一个高性能 ...