
urllib模块提供的urlretrieve()函数使用
urllib模块提供的urlretrieve()函数,urlretrieve()方法直接将远程的数据下载到本地
注意:若是网站有反爬虫的话这个函数会返回 403 Forbidden
参数url:传入的网址,网址必须得是个字符串
参数filename:指定了保存本地路径(如果参数未指定,urllib会生成一个临时文件保存数据。)
参数reporthook:是一个回调函数,当连接上服务器、以及相应的数据块传输完毕时会触发该回调,我们可以利用这个回调函数来显示当前的下载进度。
参数data:指 post 到服务器的数据,该方法返回一个包含两个元素的(filename, headers)元组,filename 表示保存到本地的路径,header 表示服务器的响应头。
下面例子将表情包下载到本地
import requests

from lxml import etree

from urllib import request

import os

import re

def page(url):

    headers = {

        'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.100 Safari/537.36'

    }

    res = requests.get(url,headers=headers)

    text = res.text

    html = etree.HTML(text)

    imgs = html.xpath("//div[@class='tagbqppdiv']//img")

    for img in imgs:

        img_url = img.get('data-original')

        alt =img.get('alt')

        sufixx = os.path.splitext(img_url)[1]#切割文件后缀名

        alt = re.sub(r'[\??\.。\!\!]',"",alt)

        filename = alt + sufixx

        request.urlretrieve(img_url,r"F:\pacong\hr class\xpath\images\\"+filename)

        # print(etree.tostring(img))

    # imgs = html.xpath("//div[@class='page-content text-center']//@href")#取出所有href里的链接

    #print(text)

def main():

    for i in range(1,101):

        url = 'https://www.fabiaoqing.com/biaoqing/lists/page/%d.html'%i

        page(url)

        break

if __name__ == '__main__':

    main()
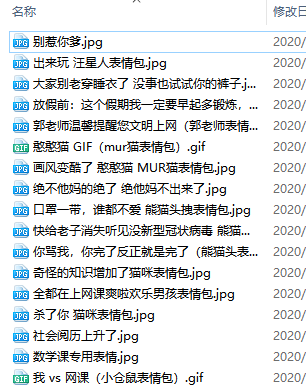
运行结果:
urllib模块提供的urlretrieve()函数使用的更多相关文章
- Python基础之 urllib模块urlopen()与urlretrieve()的使用方法详解。
Python urllib模块urlopen()与urlretrieve()的使用方法详解 1.urlopen()方法urllib.urlopen(url[, data[, proxies]]) ...
- Python urllib模块urlopen()与urlretrieve()详解
1.urlopen()方法urllib.urlopen(url[, data[, proxies]]) :创建一个表示远程url的类文件对象,然后像本地文件一样操作这个类文件对象来获取远程数据.参数u ...
- Python urllib的urlretrieve()函数解析 (显示下载进度)
#!/usr/bin/python #encoding:utf-8 import urllib import os def Schedule(a,b,c): ''''' a:已经下载的数据块 b:数据 ...
- Python:urllib模块的urlretrieve方法
转于:https://blog.csdn.net/fengzhizi76506/article/details/59229846 博主:fengzhizi76506 1)功能: urllib模块提供的 ...
- Python爬虫之urllib模块1
Python爬虫之urllib模块1 本文来自网友投稿.作者PG,一个待毕业待就业二流大学生.玄魂工作室未对该文章内容做任何改变. 因为本人一直对推理悬疑比较感兴趣,所以这次爬取的网站也是平时看一些悬 ...
- Python urllib urlretrieve函数解析
Python urllib urlretrieve函数解析 利用urllib.request.urlretrieve函数下载文件 觉得有用的话,欢迎一起讨论相互学习~Follow Me 参考文献 Ur ...
- Python核心模块——urllib模块
现在Python基本入门了,现在开始要进军如何写爬虫了! 先把最基本的urllib模块弄懂吧. urllib模块中的方法 1.urllib.urlopen(url[,data[,proxies]]) ...
- python爬虫-urllib模块
urllib 模块是一个高级的 web 交流库,其核心功能就是模仿web浏览器等客户端,去请求相应的资源,并返回一个类文件对象.urllib 支持各种 web 协议,例如:HTTP.FTP.Gophe ...
- [转]Python核心模块——urllib模块
现在Python基本入门了,现在开始要进军如何写爬虫了! 先把最基本的urllib模块弄懂吧. urllib模块中的方法 1.urllib.urlopen(url[,data[,proxies]]) ...
随机推荐
- HttpClient学习整理(一)
Http协议的重要性相信不用我多说了,HttpClient相比传统JDK自带的URLConnection,增加了易用性和灵活性(具体区别,日后我们再讨论),它不仅是客户端发送Http请求变得容易,而且 ...
- python os和sys模块使用
python os和sys模块使用 os.getcwd() 获取当前工作目录,即当前python脚本工作的目录路径 os.chdir("dirname") 改变当前脚本工作目录:相 ...
- Bookshelf 2 01背包
B - Bookshelf 2 Time Limit:1000MS Memory Limit:65536KB 64bit IO Format:%lld & %llu Submi ...
- 【5min+】 设计模式的迷惑?Provider vs Factory
系列介绍 [五分钟的dotnet]是一个利用您的碎片化时间来学习和丰富.net知识的博文系列.它所包含了.net体系中可能会涉及到的方方面面,比如C#的小细节,AspnetCore,微服务中的.net ...
- Windows更改、自定义键盘功能键
为什么要改? 使用mac盘习惯之后回到Windows感觉实盘使用起来很是别扭,所以... 开始行动 新建一个.reg后缀的文件,文件名称随意,编辑输入一下内容:(以下内容是把键盘左侧的CTRL和ALT ...
- new function 到底做了什么?如何自己实现new function
前言 这是继function 与 Function 关系后写下的. 写这个起源于,我无聊的时候看到一道题目: 'foo' == new function() { var temp=String('fo ...
- 深入源码分析SpringMVC执行过程
本文主要讲解 SpringMVC 执行过程,并针对相关源码进行解析. 首先,让我们从 Spring MVC 的四大组件:前端控制器(DispatcherServlet).处理器映射器(HandlerM ...
- java工作流系统jflow表单引擎字段扩展组件介绍
关键词:工作流快速开发平台 工作流流设计 业务流程管理 asp.net 开源工作流 bpm工作流系统 java工作流主流框架 自定义工作流引擎 表单设计器 流程设计器 装饰类图片 用于 ...
- Mac下升级ruby至最新版本
Mac自身的ruby 版本 2.x,通过ruby -v可以查看版本号. 为更新到ruby的最新版本,可通过以下命令解决: brew update brew install ruby 执行完命令后,ru ...
- 此Flash Player 与您的地区不相容,请重新安装Adobe Flash Player问题解决
flash29老版本安装说明: 如果你是Google Chrome 54及以上版本,那么直接安装 install_flash_player_**_ppapi.exe 即可,Chrome 能识别加载,无 ...