
Spark 基本概念 & 安装
1. Spark 基本概念
1.0 官网
1.1 简介
Spark 是用于大规模数据处理的快如闪电的统一分析引擎。
1.2 速度
Spark 可以获得更高的性能,针对 batch 计算和流计算都可以。
用到了 DAG scheduler (有向无环图调度器)、查询优化器、物理执行引擎
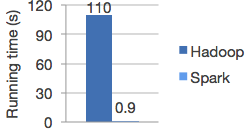
同 Hadoop 进行逻辑回归测试,Spark 速度超过 Hadoop 100x 倍。
1.3 易用性
Spark 提供了 80+ 个高级算子,可以轻松构建并行 app
支持多种语言,Java、Scala、Python、R 和 SQL shell
1.4 通用性
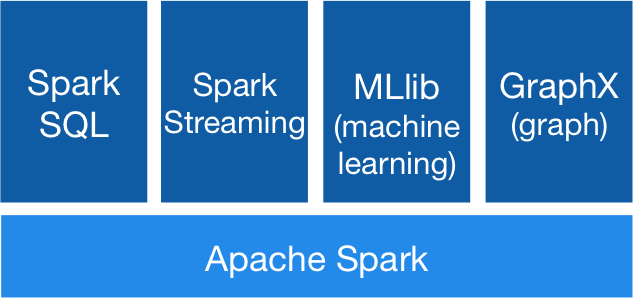
Spark 有5大模块,Core 、SQL 、Streaming 、MLlib 、GraphX
可以对 SQL 和 Streaming 以及复杂分析进行组合应用。
1.5 执行场景
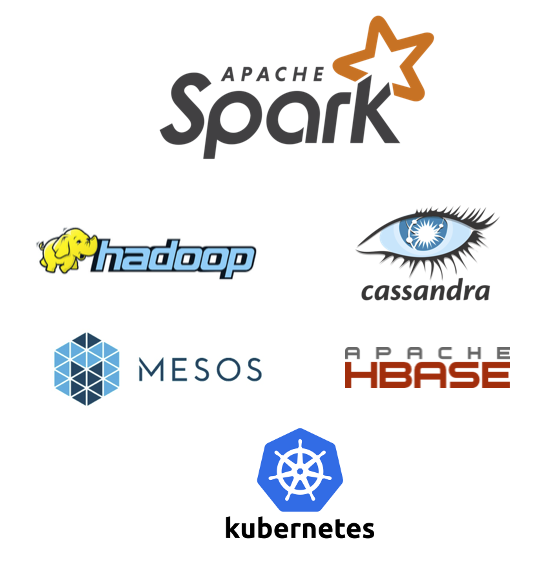
spark可以运行在 Hadoop 、Mesos 、standalone 、云上。
可以访问多种数据源。
2. 安装 Spark
2.1 解压
tar -xzvf spark-2.1.-bin-hadoop2..tgz -C /soft/
2.2 创建符号链接
ln -s /soft/spark-2.1.-bin-hadoop2. /soft/spark
2.3 配置环境变量
# 编辑环境变量配置文件
sudo vi /etc/profile

# spark 环境变量

export SPARK_HOME=/soft/spark

export PATH=$SPARK_HOME/bin:$SPARK_HOME/sbin:$PATH
2.4 生效环境变量
source /etc/profile
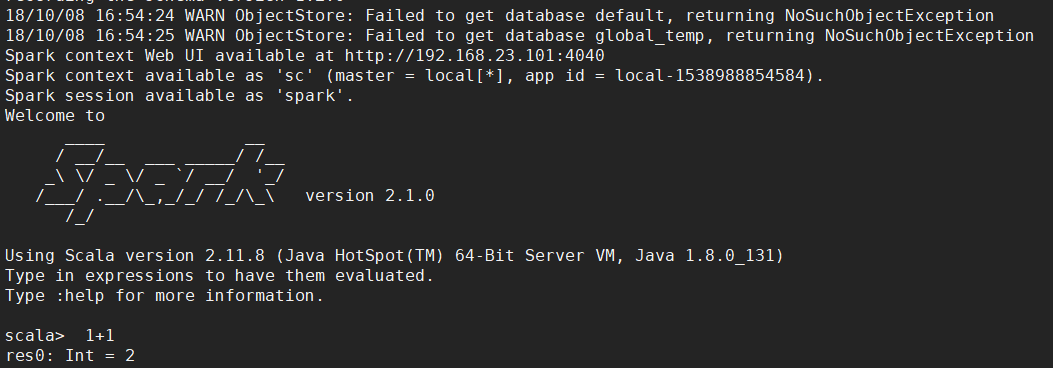
2.5 启动 spark shell
【启动前提】
# 启动 ZooKeeper 集群

xzk.sh start

# 启动 HDFS

start-dfs.sh

# 启动 Spark 服务,在 spark/sbin 目录下执行

 ./start-all.sh
【启动】
[centos@s101 /soft/spark/bin]$ spark-shell
Spark 基本概念 & 安装的更多相关文章
- 大数据技术之_19_Spark学习_01_Spark 基础解析 + Spark 概述 + Spark 集群安装 + 执行 Spark 程序
第1章 Spark 概述1.1 什么是 Spark1.2 Spark 特点1.3 Spark 的用户和用途第2章 Spark 集群安装2.1 集群角色2.2 机器准备2.3 下载 Spark 安装包2 ...
- 【Spark深入学习-11】Spark基本概念和运行模式
----本节内容------- 1.大数据基础 1.1大数据平台基本框架 1.2学习大数据的基础 1.3学习Spark的Hadoop基础 2.Hadoop生态基本介绍 2.1Hadoop生态组件介绍 ...
- [bigdata] spark集群安装及测试
在spark安装之前,应该已经安装了hadoop原生版或者cdh,因为spark基本要基于hdfs来进行计算. 1. 下载 spark: http://mirrors.cnnic.cn/apache ...
- Win7 单机Spark和PySpark安装
欢呼一下先.软件环境菜鸟的我终于把单机Spark 和 Pyspark 安装成功了.加油加油!!! 1. 安装方法参考: 已安装Pycharm 和 Intellij IDEA. win7 PySpark ...
- spark集群安装配置
spark集群安装配置 一. Spark简介 Spark是一个通用的并行计算框架,由UCBerkeley的AMP实验室开发.Spark基于map reduce 算法模式实现的分布式计算,拥有Hadoo ...
- spark基本概念及入门
spark spark背景 什么是spark Spark是一种快速.通用.可扩展的大数据分析引擎,2009年诞生于加州大学伯克利分校AMPLab,2010年开源,2013年6月成为Apache孵化项目 ...
- Spark学习笔记——安装和WordCount
1.去清华的镜像站点下载文件spark-2.1.0-bin-without-hadoop.tgz,不要下spark-2.1.0-bin-hadoop2.7.tgz 2.把文件解压到/usr/local ...
- CentOS6安装各种大数据软件 第十章:Spark集群安装和部署
相关文章链接 CentOS6安装各种大数据软件 第一章:各个软件版本介绍 CentOS6安装各种大数据软件 第二章:Linux各个软件启动命令 CentOS6安装各种大数据软件 第三章:Linux基础 ...
- hadoop环境的安装 和 spark环境的安装
hadoop环境的安装1.前提:安装了java spark环境的安装1.前提:安装了java,python2.直接pip install pyspark就可以安装完成.(pip是python的软件安装 ...
随机推荐
- Apache运维中常用功能配置笔记梳理
Apache 是一款使用量排名第一的 web 服务器,LAMP 中的 A 指的就是它.由于其开源.稳定.安全等特性而被广泛使用.下边记录了使用 Apache 以来经常用到的功能,做此梳理,作为日常运维 ...
- 通过HttpServletRequest获取服务器路径
String scheme = request.getScheme(); String serverName = request.getServerName(); int port = request ...
- CentOS MPlayer
.准备软件 mplayer官网:http://www.mplayerhq.hu/design7/news.html RPM Fusion网址:http://rpmfusion.org/ EPEL网址: ...
- tcp/ip通信中tcp头部结构tcphdrp->check校验计算
通过raw socket修改通信数据后,可通过函数 set_tcp_checksum1(iph); 重新校验计算iph->check值 在http://www.cnblogs.com/dpf-1 ...
- 基于C++ Qt实现的红色警戒3修改器
前言 这部修改器制作有一段时间了,但是一直没出教程.今天利用周末空闲写篇教程,给后来者指路的同时也加深自己对游戏修改器的理解,大佬就随便看看吧 浏览了一下网络,形形色色的单机游戏修改器教程,但是基本只 ...
- 【SpringBoot系列4】SpringBoot定制自己的bean
起因:SpringBoot我是越用越喜欢,但当SpringBoot出了问题的时候,我却无从下手,因为封装实在是太高度化了.然后之前有一个需求,使用SpringBoot提供的StringRedisTem ...
- Netty 核心组件 Pipeline 源码分析(二)一个请求的 pipeline 之旅
目录大纲: 前言 针对 Netty 例子源码做了哪些修改? 看 pipeline 是如何将数据送到自定义 handler 的 看 pipeline 是如何将数据从自定义 handler 送出的 总结 ...
- [转]关于Linux安装mysql默认配置文件位置
本文转自:https://blog.csdn.net/smile___you/article/details/54409073 在linux下面安装mysql如果在/etc下面没有存在my.cnf配置 ...
- (译文)The Linux Programming Interface:第1章(历史和标准)
1 HISTORY AND STANDARDS (译者:鱼时代 校对:fgn) Linux 是UNIX操作系统家族中的一员,在计算机出现以来,UNXI已经有很长的历史了.在这一章中的第一部分将对Un ...
- [日常] Linux下的docker实践
1.Linux 发展出了另一种虚拟化技术:Linux 容器(Linux Containers,缩写为 LXC) 2.Linux 容器不是模拟一个完整的操作系统,而是对进程进行隔离 3.Docker 属 ...