
大数据学习——yum练习安装jdk
yum list | grep jdk
安装jdk-1.8.0版本
yum -y install java-1.8.-openjdk*
安装后,执行java -version

配置环境变量
使用vim /etc/profile 编辑profile文件 输入: vim /etc/profile
向文件里面追加以下内容:
#set java environment
JAVA_HOME=/usr/java/jdk1.8.0_191
JRE_HOME=$JAVA_HOME/jre
PATH=$PATH:$JAVA_HOME/bin:$JRE_HOME/bin
CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar:$JRE_HOME/lib
export JAVA_HOME JRE_HOME PATH CLASSPATH
注释:
JAVA_HOME指明JDK安装路径,就是刚才安装时所选择的路径,此路径下包括lib,bin,jre等文件夹(tomcat,Eclipse的运行都需要依靠此变量)。
CLASSPATH为java加载类(class or lib)路径,只有类在classpath中,java命令才能识别,设:.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar:$JRE_HOME/lib。CLASSPATH变量值中的.表示当前目录
PATH使得系统可以在任何路径下识别java命令,设为:$JAVA_HOME/bin:$JRE_HOME/bin。
特别注意:环境变量值的结尾没有任何符号,不同值之间用:隔开(windows中用;)。
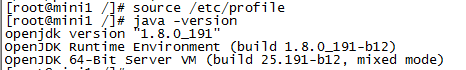
使配置文件生效:source /etc/profile
测试配置是否成功
大数据学习——yum练习安装jdk的更多相关文章
- 大数据学习——yum练习安装mysql
1. 安装mysql 服务器端: yum install mysql-server yum install mysql-devel 2. 安装mysql客户端: yum install mysql 3 ...
- 大数据学习——yum安装tomcat
https://www.cnblogs.com/jtlgb/p/5726161.html 安装tomcat6 yum install tomcat6 tomcat6-webapps tomcat6-a ...
- 大数据学习day31------spark11-------1. Redis的安装和启动,2 redis客户端 3.Redis的数据类型 4. kafka(安装和常用命令)5.kafka java客户端
1. Redis Redis是目前一个非常优秀的key-value存储系统(内存的NoSQL数据库).和Memcached类似,它支持存储的value类型相对更多,包括string(字符串).list ...
- 大数据学习day26----hive01----1hive的简介 2 hive的安装(hive的两种连接方式,后台启动,标准输出,错误输出)3. 数据库的基本操作 4. 建表(内部表和外部表的创建以及应用场景,数据导入,学生、分数sql练习)5.分区表 6加载数据的方式
1. hive的简介(具体见文档) Hive是分析处理结构化数据的工具 本质:将hive sql转化成MapReduce程序或者spark程序 Hive处理的数据一般存储在HDFS上,其分析数据底 ...
- 大数据学习系列之四 ----- Hadoop+Hive环境搭建图文详解(单机)
引言 在大数据学习系列之一 ----- Hadoop环境搭建(单机) 成功的搭建了Hadoop的环境,在大数据学习系列之二 ----- HBase环境搭建(单机)成功搭建了HBase的环境以及相关使用 ...
- 大数据学习系列之六 ----- Hadoop+Spark环境搭建
引言 在上一篇中 大数据学习系列之五 ----- Hive整合HBase图文详解 : http://www.panchengming.com/2017/12/18/pancm62/ 中使用Hive整合 ...
- 大数据学习系列之七 ----- Hadoop+Spark+Zookeeper+HBase+Hive集群搭建 图文详解
引言 在之前的大数据学习系列中,搭建了Hadoop+Spark+HBase+Hive 环境以及一些测试.其实要说的话,我开始学习大数据的时候,搭建的就是集群,并不是单机模式和伪分布式.至于为什么先写单 ...
- 大数据学习之Hadoop快速入门
1.Hadoop生态概况 Hadoop是一个由Apache基金会所开发的分布式系统集成架构,用户可以在不了解分布式底层细节情况下,开发分布式程序,充分利用集群的威力来进行高速运算与存储,具有可靠.高效 ...
- 大数据学习笔记——Linux完整部署篇(实操部分)
Linux环境搭建完整操作流程(包含mysql的安装步骤) 从现在开始,就正式进入到大数据学习的前置工作了,即Linux的学习以及安装,作为运行大数据框架的基础环境,Linux操作系统的重要性自然不言 ...
随机推荐
- 147 Insertion Sort List 链表插入排序
用插入排序对链表进行排序. 详见:https://leetcode.com/problems/insertion-sort-list/description/ Java实现: 链表的插入排序实现原理很 ...
- CF963A Alternating Sum
思路:利用周期性转化为等比数列求和. 注意当a != b的时候 bk * inv(ak) % (109 + 9)依然有可能等于1,不知道为什么. 实现: #include <bits/stdc+ ...
- Java练习题01
问题: 利用二维非矩阵数组输出下面的数字 0 1 2 2 3 4 3 4 5 6 代码: public class Page98{ public static void main(String ...
- hdu 3232 Crossing Rivers 过河(数学期望)
题意:你在点A,目的地是点B,A和B的距离为D.中间隔了好多条河(所有河不会重叠),每条河有3个参数(P,L,V),其中P表示距离A点的长度,L表示河的长度,V表示河里的船的速度.假设每条河中仅有1条 ...
- vs2010 在函数级别设置优化
平时开发的时候,为了方便调试,visual studio 的Configuration 设置成Release. 同时为了事后调试,Optimization总是设置成Disabled.这样做是方便查看变 ...
- github 下载全部项目
从github下载资料过程中,有些项目含有子模块,有时通过git clone 或者下载zip方式项目可能会缺少文件,因此需要执行 git submodule update --init --recur ...
- Python3简明教程(十四)—— Collections模块
collections 是 Python 内建的一个集合模块,提供了许多有用的集合类. 在这个实验我们会学习 Collections 模块.这个模块实现了一些很好的数据结构,它们能帮助你解决各种实际问 ...
- uva11925 Generating Permutations
逆序做,逆序输出 紫书上的描述有点问题 感觉很经典 ans.push_back(2); a.insert(a.begin(),a[n-1]); a.erase(a.end()-1); a.push_b ...
- idea创建和部署tomcat项目
小编今天花费了一上午,参悟出了如何快速的在idea上面创建并部署一个属于自己的maven项目,很荣幸能将自己的开发经验推而广之,希望能够帮助到大家! 前言 小编参考博文: Intellij Idea ...
- java GZIP压缩与解压缩
1.GZIP压缩 public static byte[] compress(String str, String encoding) { if (str == null || str.length( ...