
tensorflow分布式运行
1、知识点
"""

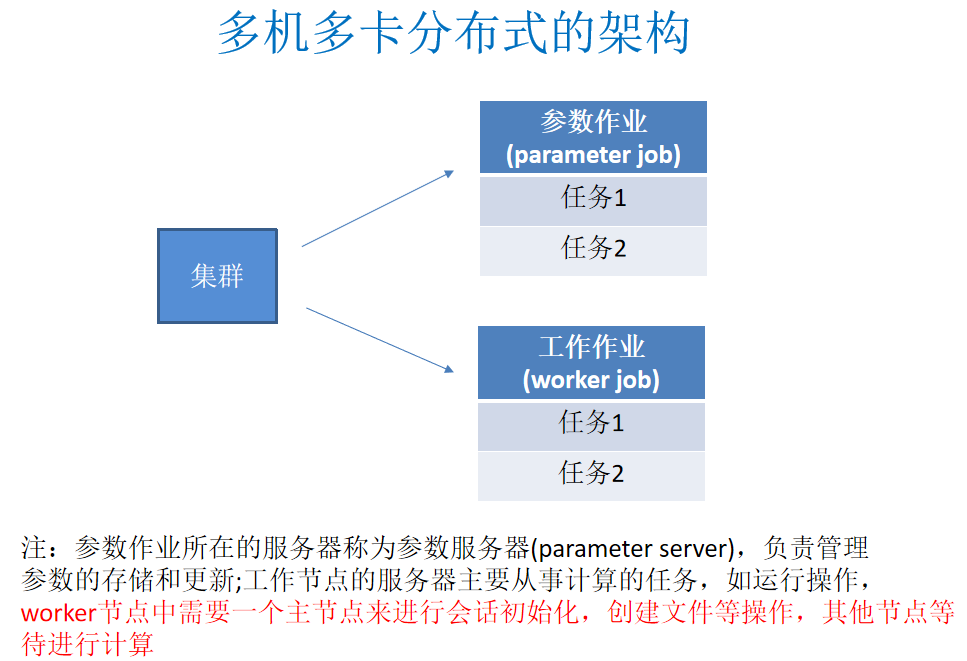
单机多卡:一台服务器上多台设备(GPU)

参数服务器:更新参数,保存参数

工作服务器:主要功能是去计算

更新参数的模式:

    1、同步模型更新

    2、异步模型更新

工作服务器会默认一个机器作为老大,创建会话

tensorflow设备命名规则:

    /job:ps/task:0   job:ps,服务器类型   task:0,服务器第几台

    /job:worker/task:0/cpu:0

    /job:worker/task:0/gpu:0

    /job:worker/task:0/gpu:1

设备使用:

    1、对集群当中的一些ps,worker进行指定

    2、创建对应的服务, ps:创建ps服务  join()

        worker创建worker服务,运行模型,程序,初始化会话等等

        指定一个默认的worker去做

    3、worker使用设备:

        with tf.device("/job:worker/task:0/gup:0"):

            计算操作

     4、分布式使用设备:

        tf.train.replica_device_setter(worker_device=worker_device,cluster=cluster)

                作用:通过此函数协调不同设备上的初始化操作

                worker_device:为指定设备, “/job:worker/task:0/cpu:0” or "/job:worker/task:0/gpu:0"

                cluster:集群描述对象

API:

    1、分布式会话函数:MonitoredTrainingSession(master="",is_chief=True,checkpoint_dir=None,

                    hooks=None,save_checkpoint_secs=600,save_summaries_steps=USE_DEFAULT,save_summaries_secs=USE_DEFAULT,config=None)

            参数:

                master:指定运行会话协议IP和端口(用于分布式) "grpc://192.168.0.1:2000"

                is_chief:是否为主worker(用于分布式)如果True,它将负责初始化和恢复基础的TensorFlow会话。

                        如果False,它将等待一位负责人初始化或恢复TensorFlow会话。

                checkpoint_dir:检查点文件目录,同时也是events目录

                config:会话运行的配置项, tf.ConfigProto(log_device_placement=True)

                hooks:可选SessionRunHook对象列表

                should_stop():是否异常停止

                run():跟session一样可以运行op

    2、tf.train.SessionRunHook

            Hook to extend calls to MonitoredSession.run()

            1、begin():在会话之前,做初始化工作

            2、before_run(run_context)在每次调用run()之前调用,以添加run()中的参数。

            ARGS:

            run_context:一个SessionRunContext对象,包含会话运行信息

            return:一个SessionRunArgs对象,例如:tf.train.SessionRunArgs(loss)

            3、after_run(run_context,run_values)在每次调用run()后调用,一般用于运行之后的结果处理

            该run_values参数包含所请求的操作/张量的结果 before_run()。

            该run_context参数是相同的一个发送到before_run呼叫。

             ARGS:

            run_context:一个SessionRunContext对象

            run_values一个SessionRunValues对象, run_values.results

        注:再添加钩子类的时候,继承SessionRunHook

    3、tf.train.StopAtStepHook(last_step=5000)指定执行的训练轮数也就是max_step,超过了就会抛出异常

            tf.train.NanTensorHook(loss)判断指定Tensor是否为NaN,为NaN则结束

            注:在使用钩子的时候需要定义一个全局步数:global_step = tf.contrib.framework.get_or_create_global_step()

"""
2、代码
import tensorflow as tf

FLAGS = tf.app.flags.FLAGS

tf.app.flags.DEFINE_string("job_name", " ", "启动服务的类型ps or  worker")

tf.app.flags.DEFINE_integer("task_index", 0, "指定ps或者worker当中的那一台服务器以task:0 ,task:1")

def main(argv):

    # 定义全集计数的op ,给钩子列表当中的训练步数使用

    global_step = tf.contrib.framework.get_or_create_global_step()

    # 1、指定集群描述对象, ps , worker

    cluster = tf.train.ClusterSpec({"ps": ["10.211.55.3:2223"], "worker": ["192.168.65.44:2222"]})

    # 2、创建不同的服务, ps, worker

    server = tf.train.Server(cluster, job_name=FLAGS.job_name, task_index=FLAGS.task_index)

    # 根据不同服务做不同的事情 ps:去更新保存参数 worker:指定设备去运行模型计算

    if FLAGS.job_name == "ps":

        # 参数服务器什么都不用干,是需要等待worker传递参数

        server.join()

    else:

        worker_device = "/job:worker/task:0/cpu:0/"

        # 3、可以指定设备取运行

        with tf.device(tf.train.replica_device_setter(

            worker_device=worker_device,

            cluster=cluster

        )):

            # 简单做一个矩阵乘法运算

            x = tf.Variable([[1, 2, 3, 4]])

            w = tf.Variable([[2], [2], [2], [2]])

            mat = tf.matmul(x, w)

        # 4、创建分布式会话

        with tf.train.MonitoredTrainingSession(

            master= "grpc://192.168.65.44:2222", # 指定主worker

            is_chief= (FLAGS.task_index == 0),# 判断是否是主worker

            config=tf.ConfigProto(log_device_placement=True),# 打印设备信息

            hooks=[tf.train.StopAtStepHook(last_step=200)]

        ) as mon_sess:

            while not mon_sess.should_stop():

                print(mon_sess.run(mat))

if __name__ == "__main__":

    tf.app.run()
3、分布式架构图
tensorflow分布式运行的更多相关文章
- [源码解析] TensorFlow 分布式环境(1) --- 总体架构
[源码解析] TensorFlow 分布式环境(1) --- 总体架构 目录 [源码解析] TensorFlow 分布式环境(1) --- 总体架构 1. 总体架构 1.1 集群角度 1.1.1 概念 ...
- [源码解析] TensorFlow 分布式环境(5) --- Session
[源码解析] TensorFlow 分布式环境(5) --- Session 目录 [源码解析] TensorFlow 分布式环境(5) --- Session 1. 概述 1.1 Session 分 ...
- TensorFlow分布式在Amazon AWS上运行
TensorFlow分布式在Amazon AWS上运行 Amazon AWS 提供采用 NVIDIA K8 GPU 的 P2.x 机器.为了能够使用,第一步还需要创建一个 Amazon AWS 账户, ...
- TensorFlow分布式(多GPU和多服务器)详解
本文介绍有关 TensorFlow 分布式的两个实际用例,分别是数据并行(将数据分布到多个 GPU 上)和多服务器分配. 玩转分布式TensorFlow:多个GPU和一个CPU展示一个数据并行的例子, ...
- [翻译] TensorFlow 分布式之论文篇 "TensorFlow : Large-Scale Machine Learning on Heterogeneous Distributed Systems"
[翻译] TensorFlow 分布式之论文篇 "TensorFlow : Large-Scale Machine Learning on Heterogeneous Distributed ...
- [翻译] TensorFlow 分布式之论文篇 "Implementation of Control Flow in TensorFlow"
[翻译] TensorFlow 分布式之论文篇 "Implementation of Control Flow in TensorFlow" 目录 [翻译] TensorFlow ...
- [源码解析] TensorFlow 分布式环境(2)---Master 静态逻辑
[源码解析] TensorFlow 分布式环境(2)---Master 静态逻辑 目录 [源码解析] TensorFlow 分布式环境(2)---Master 静态逻辑 1. 总述 2. 接口 2.1 ...
- [源码解析] TensorFlow 分布式环境(3)--- Worker 静态逻辑
[源码解析] TensorFlow 分布式环境(3)--- Worker 静态逻辑 目录 [源码解析] TensorFlow 分布式环境(3)--- Worker 静态逻辑 1. 继承关系 1.1 角 ...
- [源码解析] TensorFlow 分布式环境(4) --- WorkerCache
[源码解析] TensorFlow 分布式环境(4) --- WorkerCache 目录 [源码解析] TensorFlow 分布式环境(4) --- WorkerCache 1. WorkerCa ...
随机推荐
- MacOs上的Intellij idea高频快捷键总结(2018.1版本)
高频快捷键 查找类快捷键 command + F12 查看当前类方法变量 command + E 查看最近文件 Alt+F1 ...
- linux 启动tomcat
操作步骤: 第一步:进入tomcat的bin目录 cd /usr/local/tomcat/bin 第二步:使用tomcat关闭命令 ./shutdown.sh 第三步:查看tomcat是否关闭 ps ...
- 自学python:python学习笔记之Ubuntu 16.04网络的配置
Ubuntu 作为一个Linux的发行版,在桌面环境的易用性上做了很多改善,对推动Linux的推广做了很大的贡献.同时,它作为服务器的操作系统也越来越多的被使用.当然,服务器端可能更多的人在使用Red ...
- libusb 3.0
1)usb3.0 在windows使用winusb时,出现ReadFile的input buffer 太大时,读不到数据问题? 2)linux下,usb 3.0 libusb_claim_interf ...
- Ubuntu18.04安装破解版MATLAB2018b
参考链接: Ubuntu 18.04安装破解Matlab 2018b及创建快捷方式的详细教程(附图) Linux下安装JDK遇到的问题之cp: 无法获取"jdk-8u191-linux-i5 ...
- Nginx location模块整理
location模块 Nginx location location 指令的作用是根据用户请求的URI来执行不同的应用,URI就是根据用户请求到的网址URL进行匹配,匹配成功了进行相关的操作. loc ...
- pro git 读书笔记 2
Git 2 - Git Basics 1 add github 上建立新的 repository,命名 demo git clone 到本地 github 目录 将自己之前的项目 copy 到该 de ...
- mina客户端发送消息延迟问题分析
原文:http://www.cnblogs.com/haiq/archive/2011/08/01/2124292.html (写的蛮好,保存下来) 由于项目需要,用到了 mina 框架进行 tcp ...
- CDOJ 1264 人民币的构造 区间问题+数论
人民币的构造 Time Limit: 3000/1000MS (Java/Others) Memory Limit: 65535/65535KB (Java/Others) Submit Status ...
- cogs服务点设置(不凶,超乖) x
cogs3. 服务点设置 ★ 输入文件:djsa.in 输出文件:djsa.out 简单对比时间限制:1 s 内存限制:128 MB 问题描述为了进一步普及九年义务教育,政府要在某乡镇 ...