
06_Hive分桶机制及其作用
1.Clustered By
对于每一个表(table)或者分区, Hive可以进一步组织成桶,也就是说桶是更为细粒度的数据范围划分。
Hive也是针对某一列进行桶的组织。Hive采用对列值哈希,然后除以桶的个数求余的方式决定该条记录存放在
哪个桶当中。
把表(或者分区)组织成桶(Bucket)有两个理由:
(1)获得更高的查询处理效率。桶为表加上了额外的结构,Hive 在处理有些查询时能利用这个结构。具体
而言,连接两个在(包含连接列的)相同列上划分了桶的表,可以使用 Map 端连接 (Map-side join)高效的
实现。比如JOIN操作。对于JOIN操作两个表有一个相同的列,如果对这两个表都进行了桶操作。那么将保存相同
列值的桶进行JOIN操作就可以,可以大大较少JOIN的数据量。
(2)使取样(sampling)更高效。在处理大规模数据集时,在开发和修改查询的阶段,如果能在数据集的一
小部分数据上试运行查询,会带来很多方便。
2.分桶
分桶是相对分区进行更细粒度的划分,它是相当于MapReduce中的分区,分桶将整个数据按照某列属性值的hash
值进行区分,例如如果根据id属性分为3个桶,就是对id属性值的hash值对3取摸,按照取模结果对数据分桶。如取
模结果为0的数据记录存放到一个文件,取模为1的数据存放到一个文件,取模为2的数据存放到一个文件
1.创建带桶的表:导入的数据已经是被分好桶和排好序的
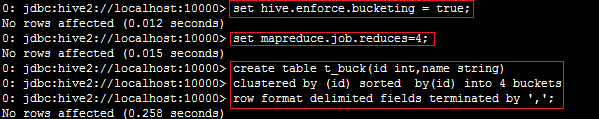
在分桶之前要执行命令:set hive.enforce.bucketing = true; set mapreduce.job.reduces=4;从而设置分桶
为true,并且reduce数量是分桶的数量个数;
关键字clustered by 指定分区依据的列名;
与分区不同的是,分区依据的不是真实数据表文件中的列,而是我们指定的伪列,但是分桶是依据数据表中真实
的列而不是伪列。所以在指定分区依据的列的时候要指定列的类型,因为在数据表文件中不存在这个列,相当于新建
一个列。而分桶依据的是表中已经存在的列,这个列的数据类型显然是已知的,所以不需要指定列的类型
如上只是说明了表会分桶,具体的分区需要在插入数据时产生。最好的插入数据方式是insert into table;
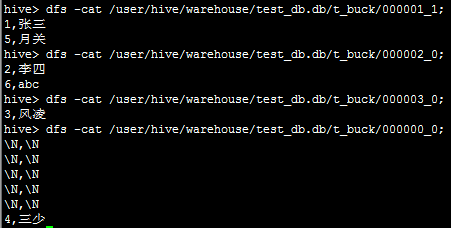
2.带桶的表中插入select数据(Cluster by(id)):表示根据id分桶并排序
cluster by和sort by不能放在一起查询

按照上面的分桶结果会在表目录下产生多个文件:/user/hive/warehouse/test_db/t_buk/
查看文件信息:
3.带桶的表中插入select数据(distribute by (id) sort by (id)):

按照上面的分桶结果会在表目录下产生多个文件:/user/hive/warehouse/test_db/t_buk/
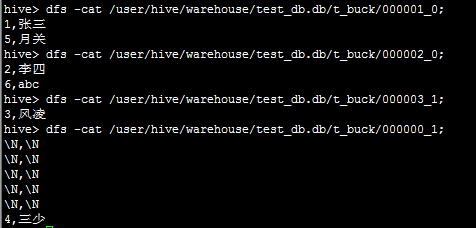
如上的的sql查询语句实际上是根据id作为key进行key.hashcode%4产生四个区,即就是用distribute by (id)
来指定分区字段,使用sort by (id)指定排序字段
总结:
因此,如果分桶和sort字段是同一个时,此时,cluster by = distribute by + sort by
如果将reduce数量设置为4,使用select * from t_test order by name;就会强制将reduce设置为1,会得到全局结果;
SELECT语法操作:

  SELECT [ALL | DISTINCT] select_expr, select_expr, ...

  FROM table_reference

  [WHERE where_condition]

  [GROUP BY col_list [HAVING condition]]

  [CLUSTER BY col_list

    | [DISTRIBUTE BY col_list] [SORT BY| ORDER BY col_list]

  ]

  [LIMIT number]

注:1、order by 会对输入做全局排序,因此只有一个reducer,会导致当输入规模较大时,需要较长的计算时间。

  2、sort by不是全局排序,其在数据进入reducer前完成排序。因此,如果用sort by进行排序,并且设置mapred.reduce.tasks>1,
则sort by只保证每个reducer的输出有序,不保证全局有序。

  3、distribute by(字段)根据指定的字段将数据分到不同的reducer,且分发算法是hash散列。

  4、Cluster by(字段) 除了具有Distribute by的功能外,还会对该字段进行排序。

  因此,如果分桶和sort字段是同一个时,此时,cluster by = distribute by + sort by

分桶表的作用:最大的作用是用来提高join操作的效率;

(思考这个问题:select a.id,a.name,b.addr from a join b on a.id = b.id;

如果a表和b表已经是分桶表,而且分桶的字段是id字段,那么做这个操作的时候就不需要再进行全表笛卡尔积了。但是如果标注了分桶但是实际上数据并没有分桶,那么结果就会出问题。
06_Hive分桶机制及其作用的更多相关文章
- Hive为什么要分桶
对于每一个表(table)或者分区, Hive可以进一步组织成桶,也就是说桶是更为细粒度的数据范围划分.Hive也是针对某一列进行桶的组织.Hive采用对列值哈希,然后除以桶的个数求余的方式决定该条记 ...
- Hive学习笔记——Hive中的分桶
对于每一个表(table)或者分区, Hive可以进一步组织成桶,也就是说桶是更为细粒度的数据范围划分.Hive也是针对某一列进行桶的组织.Hive采用对列值哈希,然后除以桶的个数求余的方式决定该条记 ...
- HIVE—索引、分区和分桶的区别
一.索引 简介 Hive支持索引,但是Hive的索引与关系型数据库中的索引并不相同,比如,Hive不支持主键或者外键. Hive索引可以建立在表中的某些列上,以提升一些操作的效率,例如减少MapRed ...
- Hive里的分区、分桶、视图和索引再谈
福利 => 每天都推送 欢迎大家,关注微信扫码并加入我的4个微信公众号: 大数据躺过的坑 Java从入门到架构师 人工智能躺过的坑 Java全栈大联盟 ...
- Hive(六)【分区表、分桶表】
目录 一.分区表 1.本质 2.创建分区表 3.加载数据到分区表 4.查看分区 5.增加分区 6.删除分区 7.二级分区 8.分区表和元数据对应得三种方式 9.动态分区 二.分桶表 1.创建分桶表 2 ...
- hive从入门到放弃(四)——分区与分桶
今天讲讲分区表和分桶表,前面的文章还没看的可以点击链接: hive从入门到放弃(一)--初识hive hive从入门到放弃(二)--DDL数据定义 hive从入门到放弃(三)--DML数据操作 分区 ...
- Hive 的分桶 & Parquet 概念
分区 & 分桶 都是把数据划分成块.分区是粗粒度的划分,桶是细粒度的划分,这样做为了可以让查询发生在小范围的数据上以提高效率. 分区之后,分区列都成了文件目录,从而查询时定位到文件目录,子数据 ...
- linux_shell_根据网站来源分桶
应用场景: 3kw行url+\t+html记录 [网站混合] 需要:按照网站来源分桶输出 执行shell cat */*pack.html|awk -F '\t' '{ split($1,arr,&q ...
- Hive分桶
1.简介 分桶表是对列值取哈希值的方式将不同数据放到不同文件中进行存储.对于hive中每一个表,分区都可以进一步进行分桶.由列的哈希值除以桶的个数来决定数据划分到哪个桶里. 2.适用场景 1.数据抽样 ...
随机推荐
- 学用 ASP.Net 之 System.Collections.ArrayList 类
ArrayList 是 .Net 的动态数组. 主要成员: /* 静态方法 */ ArrayList.Adapter() //把其他 IList 对象包装为 ArrayList 使用 ArrayLis ...
- SpringBoot: 16.整合junit单元测试(转)
1.创建maven项目,修改pom.xml文件 <!--springboot项目依赖的父项目--> <parent> <groupId>org.springfram ...
- QFramework 使用指南 2020 (一): 概述
大家好,我是 QFramework 的作者 凉鞋,QFramework 从第一次代码提交到现在快 5 年了,期间陆陆续续增加了很多功能,在使用体验上做了大量的改进. 而市面上关于 QFramework ...
- 使用canal通过mysql复制协议从binlog实现热数据nosql缓存(1)
binlog: mysql在运行过程中执行的DML(增删改)操作都会以二进制形式记录在binlog中 canal server: canal server作为从数据库(slave)向主数据库发送dum ...
- C/C++.字符串分割
1.ZC:只测试使用了 自己改编的函数SplitStr_ZZ(...),其它的 未测试 #include <string> #include <vector> #include ...
- 最新 快乐阳光java校招面经 (含整理过的面试题大全)
从6月到10月,经过4个月努力和坚持,自己有幸拿到了网易雷火.京东.去哪儿.快乐阳光等10家互联网公司的校招Offer,因为某些自身原因最终选择了快乐阳光.6.7月主要是做系统复习.项目复盘.Leet ...
- spring中的bean的生命周期
bean的生命周期:bean的创建 —— 初始化 ——销毁的过程 容器管理bean的生命周期,我们可以自定义初始化和销毁方法,容器在bean进行到当前生命周期就会调用我们的方法 在xml配置文件中是在 ...
- layui layer.open弹出框获取不了 input框的值
layer.open({ title:'添加管理员', type: 1, content: $('.add_html').html(), btn:['添加', '取消'], btnAlign:'c', ...
- PHP新特性
1.太空船操作符<=> 2.变量类型限定 3.$a = $b??$c 4.常量数组,define($arr,['a','b']) 5.namespace批量导入 等等
- Orderly Class
题目链接: https://nanti.jisuanke.com/t/40449 题目大意:给出两个长度相同的不同字符串A, B.可以对A的任意长度区间进行一次翻转,问有多少种方法可以使得翻转后两字符 ...