
Pandas中DataFrame数据合并、连接(concat、merge、join)之concat
一、concat:沿着一条轴,将多个对象堆叠到一起
concat(objs, axis=0, join='outer', join_axes=None, ignore_index=False,

       keys=None, levels=None, names=None, verify_integrity=False, copy=True):
objs:需要连接的对象集合,一般是列表或字典;
axis:连接轴向;
join:参数为‘outer’或‘inner’;
join_axes=[]:指定自定义的索引;
keys=[]:创建层次化索引;
ignore_index=True:重建索引
pd.concat()只是单纯的把两个表拼接在一起,参数axis是关键,它用于指定是行还是列,axis默认是0。
当axis=0时,pd.concat([obj1, obj2])的效果与obj1.append(obj2)是相同的;
当axis=1时,pd.concat([obj1, obj2], axis=1)的效果与pd.merge(obj1, obj2, left_index=True, right_index=True, how='outer')是相同的。merge方法的介绍请参看下文。
import  pandas as pd

import numpy  as np

random = np.random.RandomState(0)  #随机数种子,相同种子下每次运行生成的随机数相同

df1=pd.DataFrame(random.randn(3,4),columns=['a','b','c','d'])

df1
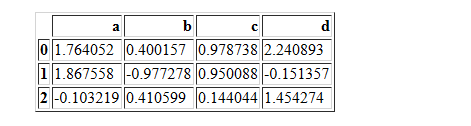
random = np.random.RandomState(0)

df2=pd.DataFrame(random.randn(2,3),columns=['b','d','a'],index=["a1","a2"])

df2

random = np.random.RandomState(1)

df22=pd.DataFrame(random.randn(3,3),columns=['b','d','a'],index=['',"a1","a2"])

df22

当axis=0时
pd.concat([df1,df2],axis=0)
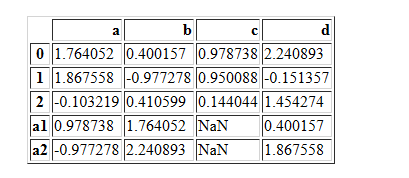
pd.concat([df1,df2],axis=0,join="outer")

df12=df1.append(df2)

df12

pd.concat([df1,df2],axis=0,join="inner")

当axis=1时
pd.concat([df1,df2],axis=1,join='inner')
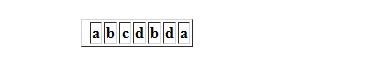
pd.concat([df1,df1],axis=1,join='inner') #和outer一样
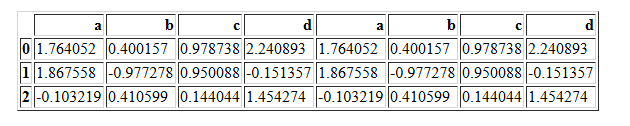
pd.concat([df1,df2],axis=1,join="outer")
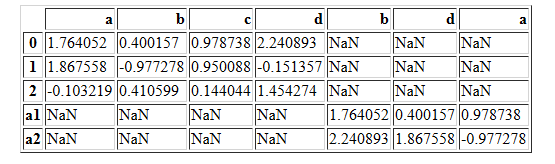
pd.concat([df1,df22],axis=1,join="inner")
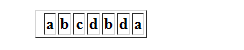
pd.concat([df1,df22],axis=1,join="outer")

pd.concat([df1,df1],axis=1,join="outer")

Pandas中DataFrame数据合并、连接(concat、merge、join)之concat的更多相关文章
- Pandas中DataFrame数据合并、连接(concat、merge、join)之merge
二.merge:通过键拼接列 类似于关系型数据库的连接方式,可以根据一个或多个键将不同的DatFrame连接起来. 该函数的典型应用场景是,针对同一个主键存在两张不同字段的表,根据主键整合到一张表里面 ...
- Pandas中DataFrame数据合并、连接(concat、merge、join)之join
pandas.DataFrame.join 自己弄了很久,一看官网.感觉自己宛如智障.不要脸了,直接抄 DataFrame.join(other, on=None, how='left', lsuff ...
- 排序合并连接(sort merge join)的原理
排序合并连接(sort merge join)的原理 排序合并连接(sort merge join)的原理 排序合并连接(sort merge join) 访问次数:两张表都只会访 ...
- Python基础 | pandas中dataframe的整合与形变(merge & reshape)
目录 行的union pd.concat df.append 列的join pd.concat pd.merge df.join 行列转置 pivot stack & unstack melt ...
- Spark与Pandas中DataFrame对比
Pandas Spark 工作方式 单机single machine tool,没有并行机制parallelism不支持Hadoop,处理大量数据有瓶颈 分布式并行计算框架,内建并行机制paral ...
- Spark与Pandas中DataFrame对比(详细)
Pandas Spark 工作方式 单机single machine tool,没有并行机制parallelism不支持Hadoop,处理大量数据有瓶颈 分布式并行计算框架,内建并行机制paral ...
- 将pandas的DataFrame数据写入MySQL数据库 + sqlalchemy
将pandas的DataFrame数据写入MySQL数据库 + sqlalchemy import pandas as pd from sqlalchemy import create_engine ...
- Python3 Pandas的DataFrame数据的增、删、改、查
Python3 Pandas的DataFrame数据的增.删.改.查 一.DataFrame数据准备 增.删.改.查的方法有很多很多种,这里只展示出常用的几种. 参数inplace默认为False,只 ...
- Pandas中DataFrame修改列名
Pandas中DataFrame修改列名:使用 rename df = pd.read_csv('I:/Papers/consumer/codeandpaper/TmallData/result01- ...
随机推荐
- [bzoj4818][Sdoi2017]序列计数_矩阵乘法_欧拉筛
[Sdoi2017]序列计数 题目大意:https://www.lydsy.com/JudgeOnline/problem.php?id=4818. 题解: 首先列出来一个递推式子 $f[i][0]$ ...
- centos7搭建NFS服务
服务器端 139.155.90.78 客户端 192.168.198.146 先查看自己的系统有没有安装rpcbind 和nfs-utils rpm -qa nfs-utils rpcbind 若使 ...
- (一)C++入门——指针与数组——Expression: _CrtIsValidHeapPointer(Block)
最近在入门c++,在看<c++ Primer Plus>一书.书中P106提到,删除使用New创建的数组时,是将指针重新指到第一个元素后,再进行的删除操作.代码如下: int *ptest ...
- JDBC:JAVA & Oracle
JDBC:JAVA & Oracle 本文中未加标注的资源均来自于PolyU数据库课程的实验材料.仅作为学习使用,如有侵权,请联系删除 JDBC是什么 我之前写过一篇关于数据库和JAVA的博文 ...
- SVN客户端(TortoiseSVN)保存密码自动登录后,如何切换使用其它帐户登录方法
清除SVN客户端(TortoiseSVN)保存的认证信息(用户名和密码) 1.选择TortoiseSVN---->Settings. 2.点"Clear” ,清空Authenticat ...
- 使用webpack + momentjs时, 需要注意的问题
注意开发HTML页面charset, 如是不是utf-8, 比如是shift_jis, 一般会在webpack里用插件EncodingPlugin把开发的utf-8格式转码成shift_jis格式 ...
- Spring AOP的理解和使用
AOP是Spring框架面向切面的编程思想,AOP采用一种称为“横切”的技术,将涉及多业务流程的通用功能抽取并单独封装,形成独立的切面,在合适的时机将这些切面横向切入到业务流程指定的位置中. 掌握AO ...
- ActiveMQ入门操作示例
1. Queue 1.1 Producer 生产者:生产消息,发送端. 把jar包添加到工程中. 第一步:创建ConnectionFactory对象,需要指定服务端ip及端口号. 第二步:使用Conn ...
- 第四篇.python的基础
目录 第四篇.python基础01 1. 变量 2. 常量 3. python变量内存管理 4. 变量的三个特征 5. 花式赋值 6. 注释 7. 数据类型基础 8. 数字类型 9. 字符串类型 10 ...
- 终端复用工具-tmux
目录 终端复用工具--Tmux 一.为什么要用Tmux? 二.tmux是什么? 三.Tmux基本概念 四.Tmux使用规则 1.安装Tmux 2.基本使用 3.自定义配置文件 五.补充 1.tmux ...