
deep_learning_Activate_method
常见的激活函数有sigmoid、tanh和relu三种非线性函数,其数学表达式分别为:
- sigmoid: y = 1/(1 + e-x)
- tanh: y = (ex - e-x)/(ex + e-x)
- relu: y = max(0, x)
其代码实现如下:

import numpy as np

import matplotlib.pyplot as plt

def sigmoid(x):

    return 1 / (1 + np.exp(-x))

def tanh(x):

    return (np.exp(x) - np.exp(-x)) / (np.exp(x) + np.exp(-x))

def relu(x):

    return np.maximum(0, x)

x = np.arange(-5, 5, 0.1)

p1 = plt.subplot(311)

y = tanh(x)

p1.plot(x, y)

p1.set_title('tanh')

p1.axhline(ls='--', color='r')

p1.axvline(ls='--', color='r')

p2 = plt.subplot(312)

y = sigmoid(x)

p2.plot(x, y)

p2.set_title('sigmoid')

p2.axhline(0.5, ls='--', color='r')

p2.axvline(ls='--', color='r')

p3 = plt.subplot(313)

y = relu(x)

p3.plot(x, y)

p3.set_title('relu')

p3.axvline(ls='--', color='r')

plt.subplots_adjust(hspace=1)

plt.show()
其图形解释如下:
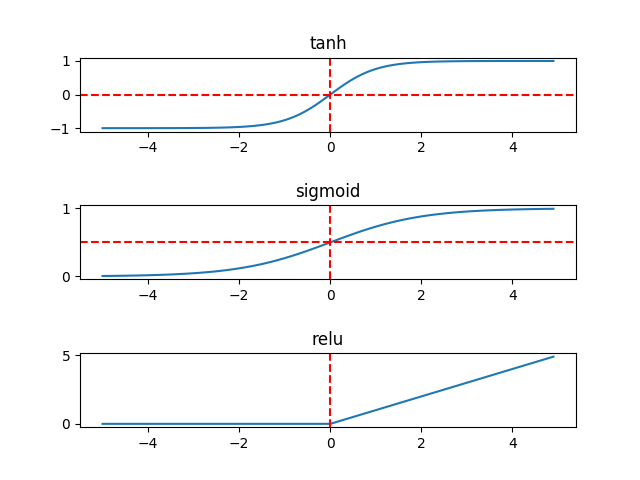
相较而言,在隐藏层,tanh函数要优于sigmoid函数,可以认为是sigmoid的平移版本,优势在于其取值范围介于-1 ~ 1之间,数据的平均值为0,而不像sigmoid为0.5,有类似数据中心化的效果。
但在输出层,sigmoid也许会优于tanh函数,原因在于你希望输出结果的概率落在0 ~ 1 之间,比如二元分类,sigmoid可作为输出层的激活函数。
但实际应用中,特别是深层网络在训练时,tanh和sigmoid会在端值趋于饱和,造成训练速度减慢,故深层网络的激活函数默认大多采用relu函数,浅层网络可以采用sigmoid和tanh函数。
另外有必要了解激活函数的求导公式,在反向传播中才知道是如何进行梯度下降。三个函数的求导结果及推理过程如下:
1. sigmoid求导函数:
其中,sigmoid函数定义为 y = 1/(1 + e-x) = (1 + e-x)-1
与此相关的基础求导公式:(xn)' = n * xn-1 和 (ex)' = ex
应用链式法则,其求导过程为:dy/dx = -1 * (1 + e-x)-2 * e-x * (-1)
= e-x * (1 + e-x)-2
= (1 + e-x - 1) / (1 + e-x)2
= (1 + e-x)-1 - (1 + e-x)-2
= y - y2
= y(1 -y)
2. tanh求导函数:
其中,tanh函数定义为 y = (ex - e-x)/(ex + e-x)
与此相关的基础求导公式:(u/v)' = (u' v - uv') / v2
同样应用链式法则,其求导过程为:dy/dx = ( (ex - e-x)' * (ex + e-x) - (ex - e-x) * (ex + e-x)' ) / (ex + e-x)2
= ( (ex - (-1) * e-x) * (ex + e-x) - (ex - e-x) * (ex + (-1) * e-x) ) / (ex + e-x)2
= ( (ex + e-x)2 - (ex - e-x)2 ) / (ex + e-x)2
= 1 - ( (ex - e-x)/(ex + e-x) )2
= 1 - y2
3. relu求导函数:
其中,relu函数定义为 y = max(0, x)
可以简单推理出 当x <0 时,dy/dx = 0; 当 x >= 0时,dy/dx = 1
转自:https://www.cnblogs.com/hutao722/p/9732223.html
deep_learning_Activate_method的更多相关文章
随机推荐
- Python之网络模型与图形绘制工具networkx
笔记 # https://www.jianshu.com/p/e543dc63454f import networkx as nx import matplotlib.pyplot as plt ## ...
- JavaScript 3种内置对象
前面我们学了对象,如何创建对象及使用对象. 内置对象不需要实例化,就可以使用. 可以通俗地理解,在内存里的东东是对象,也就是实例化好的.在磁盘里的东东是类,需要实例化才能使用.实例化后的东东在内存里. ...
- mysql数据库之视图、触发器
视图 概念:通过查询得到的一张虚拟表,然后保存下来就是视图 视图的好处:如果要频繁使用某张虚拟表,那么就可以保存为视图,以后查找就直接拿这个视图就会非常方便 视图语法规则: create view t ...
- MySQL中的聚集索引和辅助索引
MySQL中的聚集索引和辅助索引 当你定义一个主键时,innodb存储引擎就把他当做聚集索引 如果你没有定义一个主键,则innodb定位到第一个唯一索引,且改索引的所有列值均为非空,就将其当做聚集索引 ...
- Min swaps to sort array
Given an array with distinct numbers, return an integer indicating the minimum number of swap operat ...
- sql server凭据
转自:https://blog.csdn.net/kk185800961/article/details/52469170 凭据是包含连接到 SQL Server 外部资源所需的身份验证信息(凭据)的 ...
- Hadoop-(Flume)
Hadoop-(Flume) 1. Flume 介绍 1.1. 概述 Flume是一个分布式.可靠.和高可用的海量日志采集.聚合和传输的系统. Flume可以采集文件,socket数据包.文件.文件夹 ...
- spring-boot 几个工具类(七)
环境 jdk 6 tomcat 6.0.53 sts 4.4.2 maven 3.2.5 mysql 5.7 SpringContextHolder SpringContextHolder 可以很方便 ...
- C++多线程基础学习笔记(九)
一.std::atomic续谈 上一章说到std::atomic是针对一个变量的,这里补充一下针对的变量操作一般是++,+=,--,&=等等运算 .以下这种不可取:a=a+1; 二.std:: ...
- Educational Codeforces Round 68 (Rated for Div. 2)补题
A. Remove a Progression 签到题,易知删去的为奇数,剩下的是正偶数数列. #include<iostream> using namespace std; int T; ...