
【lucene系列学习四】使用IKAnalyzer分词器实现敏感词和停用词过滤
Lucene自带的中文分词器SmartChineseAnalyzer不太好扩展,于是我用了IKAnalyzer来进行敏感词和停用词的过滤。
首先,下载IKAnalyzer,我下载了

然后,由于IKAnalyzer已经很久不更新了,不兼容现在的Lucene6版本,所以我参考网上的资料,重写了IKTokenizer和IKAnalyzer两个类。
 package kidsearch;

 import java.io.IOException;

 import java.io.Reader;

 import org.apache.lucene.analysis.Tokenizer;

 import org.apache.lucene.analysis.tokenattributes.CharTermAttribute;

 import org.apache.lucene.analysis.tokenattributes.OffsetAttribute;

 import org.apache.lucene.analysis.tokenattributes.TypeAttribute;

 import org.wltea.analyzer.core.IKSegmenter;

 import org.wltea.analyzer.core.Lexeme;

 public class MyIKTokenizer extends Tokenizer {

     // IK分词器实现

     private IKSegmenter _IKImplement;

     // 词元文本属性

     private final CharTermAttribute termAtt;

     // 词元位移属性

     private final OffsetAttribute offsetAtt;

     // 词元分类属性(该属性分类参考org.wltea.analyzer.core.Lexeme中的分类常量)

     private final TypeAttribute typeAtt;

     // 记录最后一个词元的结束位置

     private int endPosition;

     public MyIKTokenizer(Reader in) {

         this(in, true);

     }

     public MyIKTokenizer(Reader in, boolean useSmart) {

         offsetAtt = addAttribute(OffsetAttribute.class);

         termAtt = addAttribute(CharTermAttribute.class);

         typeAtt = addAttribute(TypeAttribute.class);

         _IKImplement = new IKSegmenter(input, useSmart);

     }

     @Override

     public boolean incrementToken() throws IOException {

         // 清除所有的词元属性

         clearAttributes();

         Lexeme nextLexeme = _IKImplement.next();

         if (nextLexeme != null) {

             // 将Lexeme转成Attributes

             // 设置词元文本

             termAtt.append(nextLexeme.getLexemeText());

             // 设置词元长度

             termAtt.setLength(nextLexeme.getLength());

             // 设置词元位移

             offsetAtt.setOffset(nextLexeme.getBeginPosition(),

                     nextLexeme.getEndPosition());

             // 记录分词的最后位置

             endPosition = nextLexeme.getEndPosition();

             // 记录词元分类

             typeAtt.setType(String.valueOf(nextLexeme.getLexemeType()));

             // 返会true告知还有下个词元

             return true;

         }

         // 返会false告知词元输出完毕

         return false;

     }

     public void reset() throws IOException {

         super.reset();

         _IKImplement.reset(input);

     }

     @Override

     public final void end() {

         // set final offset

         int finalOffset = correctOffset(this.endPosition);

         offsetAtt.setOffset(finalOffset, finalOffset);

     }

 }
MyIKTokenizer
 package kidsearch;

 import java.io.Reader;

 import java.io.StringReader;

 import org.apache.lucene.analysis.Analyzer;

 import org.apache.lucene.util.IOUtils;

 import kidsearch.MyIKTokenizer;

 public class MyIkAnalyzer extends Analyzer {

     @Override

     protected TokenStreamComponents createComponents(String arg0) {

         Reader reader=null;

         try{

             reader=new StringReader(arg0);

             MyIKTokenizer it = new MyIKTokenizer(reader);

             return new Analyzer.TokenStreamComponents(it);

         }finally {

             IOUtils.closeWhileHandlingException(reader);

         }

     }

 }
MyIKAnalyzer
参考的博客里有一部分是错误的

于是我又下载了IKAnalyzer的源码,仔细看了一下Lexeme.java,发现没有这个方法,只有getLexemeType,而且返回值是int,于是自己做了点小改动,终于编译通过了!
值得注意的是,MyIKTokenizer里
 public MyIKTokenizer(Reader in) {

         this(in, true);

     }
true为选择智能划分(北京师范大学),而false为最细粒度划分(北京师范大学,北京,京师,师范大学,师范,大学)。
最后,要配置自己的停用词和敏感词。
自定义词典一定要使用UTF-8无BOM编码,否则不能实现过滤功能。
然后,在配置文件IKAnalyzer.cfg.xml里配置自定义词典
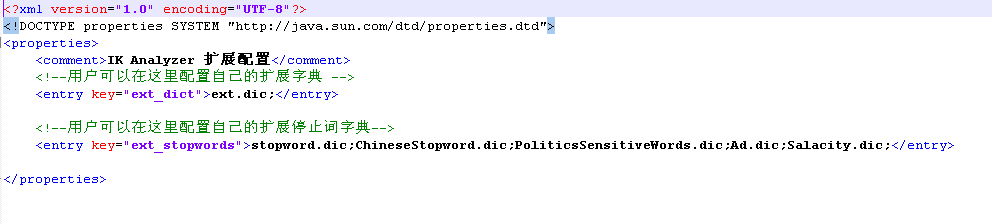
最后,分别把所有的自定义词典和IKAnalyzer.cfg.xml加到工程里的src(为了保险起见,我又把他们加到了bin里,IK的jar包里也加了)。
为了测试停用词的效果,可以自己写几个小程序。
 import java.io.IOException;

 import java.io.StringReader;

 import org.apache.lucene.analysis.Analyzer;

 import org.apache.lucene.analysis.TokenStream;

 import org.apache.lucene.analysis.tokenattributes.CharTermAttribute;

 import org.wltea.analyzer.cfg.Configuration;

 import org.wltea.analyzer.cfg.DefaultConfig;

 import org.wltea.analyzer.core.IKSegmenter;

 import org.wltea.analyzer.core.Lexeme;

 import org.wltea.analyzer.lucene.IKAnalyzer;

 public class OwnIKAnalyzer {

     public static void main(String[] args) throws IOException {

         String text="我有一个红红的苹果";

         StringReader sr=new StringReader(text);

     //    IKSegmenter ik=new IKSegmenter(sr, true);

         IKSegmenter ik=new IKSegmenter(sr,true);

         Lexeme lex=null;

         while((lex=ik.next())!=null){

             System.out.print(lex.getLexemeText()+",");

         }

 //        String text = "这是一个红红的苹果";

 //        Configuration configuration = DefaultConfig.getInstance();

 //        configuration.setUseSmart(true);

 //        IKSegmenter ik = new IKSegmenter(new StringReader(text), configuration);

 //        Lexeme lexeme = null;

 //        while ((lexeme = ik.next()) != null) {

 //            System.out.println(lexeme.getLexemeText());

         }

     }
测试结果为:(词典里并没有过滤“我”)
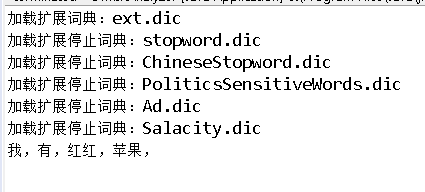
另外,IKAnalyzer可以配置自己的扩展词典,比如“你的名字”本来会被分词为“你,的,名字”,但是在ext.dic里加入“你的名字”后就是一个完整的整体,不会被切分了!
关于IKAnalyzer词语过滤的功能今天就做了多,以后还会继续补充~
【lucene系列学习四】使用IKAnalyzer分词器实现敏感词和停用词过滤的更多相关文章
- lucene全文搜索之二:创建索引器(创建IKAnalyzer分词器和索引目录管理)基于lucene5.5.3
前言: lucene全文搜索之一中讲解了lucene开发搜索服务的基本结构,本章将会讲解如何创建索引器.管理索引目录和中文分词器的使用. 包括标准分词器,IKAnalyzer分词器以及两种索引目录的创 ...
- lucene内存索引库、分词器
内存索引库 特点 在内存中开辟一块空间,专门为索引库存放.这样有以下几个特征: 1) 因为索引库在内存中,所以访问速度更快. 2) 在程序退出时,索引库中的文件也相应的消失了. 3) ...
- Solr配置Ikanalyzer分词器
上一篇文章讲解在win系统中如何安装solr并创建一个名为test_core的Core,接下为text_core配置Ikanalyzer 分词器 1.打开text_core的instanceDir目录 ...
- lucene全文搜索之四:创建索引搜索器、6种文档搜索器实现以及搜索结果分析(结合IKAnalyzer分词器的搜索器)基于lucene5.5.3
前言: 前面几章已经很详细的讲解了如何创建索引器对索引进行增删查(没有更新操作).如何管理索引目录以及如何使用分词器,上一章讲解了如何生成索引字段和创建索引文档,并把创建的索引文档保存到索引目录,到这 ...
- Lucene.Net3.0.3+盘古分词器学习使用
一.Lucene.Net介绍 Lucene.net是Lucene的.net移植版本,是一个开源的全文检索引擎开发包,即它不是一个完整的全文检索引擎,而是一个全文检索引擎的架构,提供了完整的查询引擎和索 ...
- python调用jieba(结巴)分词 加入自定义词典和去停用词功能
把语料从数据库提取出来以后就要进行分词啦,我是在linux环境下做的,先把jieba安装好,然后找到内容是build jieba PKG-INFO setup.py test的那个文件夹(我这边是ji ...
- IKanalyzer分词器分词并且统计词频
<dependency> <groupId>com.janeluo</groupId> <artifactId>ikanalyzer</artif ...
- 【lucene系列学习四】log4j日志文件实现多线程的测试
参考资料:http://nudtgk2000.iteye.com/blog/1716379 首先,在http://www.apache.org/dyn/closer.cgi/logging/log4j ...
- Lucene系列四:Lucene提供的分词器、IKAnalyze中文分词器集成、扩展 IKAnalyzer的停用词和新词
一.Lucene提供的分词器StandardAnalyzer和SmartChineseAnalyzer 1.新建一个测试Lucene提供的分词器的maven项目LuceneAnalyzer 2. 在p ...
随机推荐
- 小故事理解TCP/IP连接时的三次握手
在TCP/IP协议中,TCP协议通过三次握手建立一个可靠的连接,示意图如下: 下面通过一个小故事简单理解一下这三次握手的具体含义: 一天,快递员小客(客户端)准备去小服(服务器)家去送快递(准备与服务 ...
- jQuery kxbdMarquee 无缝滚动
转:http://code.ciaoca.com/jquery/kxbdmarquee/ <marquee> 曾是 IE 下独有的一个走马灯效果的标签,其他浏览器并不兼容,于是出现了使用 ...
- 【转】Objective-C Runtime
之前在找Runtime资料,这篇条理是相对比较清晰,对我最有启发的一篇,转载以作记录. 对于iOS小白,值得多看几遍,会有不少收获. --------------------------------- ...
- windows phone 8.1开发:文件选择器FileSavePicker
上一篇文章小梦分享了文件选择器FileOpenPicker的用法,这篇文章我们继续分享FileSavePicker的用法,FileSavePicker的用法几乎和FileOpenPicker用法一模一 ...
- flex中为控件添加监听器并计算
1.添加监听器: public function moduleCreationComplete():void { this.D601_29a.addEventListener(FlexEvent.SE ...
- iOS开发之MapKit
1.概述 MapKit框架使用前提: 导入框架: 导入主头文件: #import <MapKit/MapKit.h> MapKit框架使用须知: MapKit框架中所有数据类型的前缀都是M ...
- iOS开发之计算文字尺寸
/** * 计算文字尺寸 * * @param text 需要计算尺寸的文字 * @param font 文字的字体 * @param maxSize 文字的最大尺寸 */ - ( ...
- 配置linux实现路由功能
说明: 主机1是内网的数据存储服务器,只有一块网卡10.0.0.2: 主机2是web服务器,有两块网卡,一块面向内网10.0.0.3,一块面向外网192.168.220.136: (因为是在虚拟机的环 ...
- salesforce中soql及sosl的伪‘Like’模糊检索
salesforce里有soql.sosl两种查询语法,soql针对模糊搜索也有‘like’关键字,然而只能针对其自带字段如:Name.Id:对于自定义添加的字段如:Message__c.Note__ ...
- 【机器学习】代价函数(cost function)
注:代价函数(有的地方也叫损失函数,Loss Function)在机器学习中的每一种算法中都很重要,因为训练模型的过程就是优化代价函数的过程,代价函数对每个参数的偏导数就是梯度下降中提到的梯度,防止过 ...