
Java刷题常用API
输入输出
Scanner sc = new Scanner(System.in);

String s = sc.next();//字符串

double t = sc.nextDouble(); //浮点数

String s = sc.nextLine();//一行
判断是否有下一个输入,用sc.hasNext()或sc.hasNextInt()或sc.hasNextDouble()或sc.hasNextLine()
//循环输入整数

while(in.hasNextInt()){

	int n = sc.nextInt();

}

//循环输入字符

while(in.hasNext()){

}
注意,如果使用nextInt()或next()之后,要用nextLine(),需手动调用.nextLine()吸收掉回车符或空格。但是如果不是交叉使用,比如连续使用next()或next()是可以自动吸收掉空格或回车符的。
nextInt() 只读取整数类型数据,读取完输入后把光标放在同一行该数据的后面。
next() 只读取到空格,不能读取被空格分开的两个单词,读取完后把光标位置同上。
nextLine() 读取整行的数据包括单词间的空格和结束的回车符,读取结束后把光标放在下一行开头。
import java.util.ArrayList;

import java.util.List;

import java.util.Scanner;

/**

input:

2 3

1 2 3

4 5 6

avd

dvd

abcdf fsfd

output:

123

456

avd

dvd

abcdf fsfd

*/

public class Main {

    public static void main(String[] args) {

        Scanner sc = new Scanner(System.in);

        int n = sc.nextInt();

        int m = sc.nextInt();

        List<List<Integer>> lists = new ArrayList<>();

        for(int i=0; i<n; i++){

            List<Integer> list = new ArrayList<>();

            for(int j=0; j<m; j++){

                list.add(sc.nextInt());

            }

            lists.add(list);

        }

        String s1 = sc.next();

        char[] c = sc.next().toCharArray();

        sc.nextLine();//手动 调用.nextLine()越过“/n“

        String s2 = sc.nextLine();

        //output

        for(List<Integer> list:lists){

            for(Integer a: list){

                System.out.print(a);

            }

            System.out.println();

        }

        System.out.println(s1);

        System.out.println(c);

        System.out.println(s2);

    }

}
循环中hasNext()无法结束, 可以在循环中加入break条件,也可以手动设置终止符
//例:以“0”作为终止符

Scanner in = new Scanner(System.in);

while (!in.hasNext("0")) {

System.out.println(in.next());

}
输出
System.out.println();

System.out.printf();
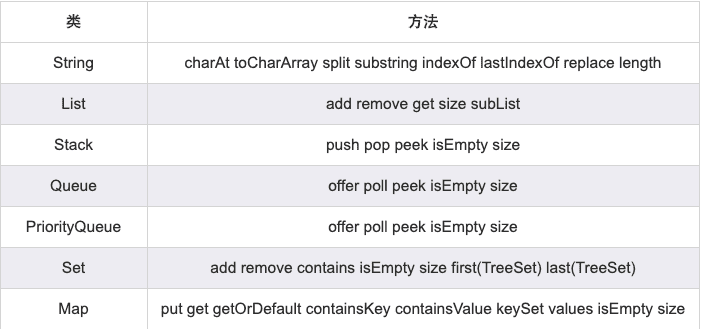
快速查看
最大最小值
fmax = Float.MAX_VALUE;
fmin = Float.MIN_VALUE;
dmax = Double.MAX_VALUE;
dmin = Double.MIN_VALUE;
bmax = Byte.MAX_VALUE;
bmin = Byte.MIN_VALUE;
cmax = Character.MAX_VALUE;
cmin = Character.MIN_VALUE;
shmax = Short.MAX_VALUE;
shmin = Short.MIN_VALUE;
imax = Integer.MAX_VALUE;
imin = Integer.MIN_VALUE;
lmax = Long.MAX_VALUE;
lmin = Long.MIN_VALUE;
string
不可变量, 每个位置元素是个char
初始化
String s = "abc";

s = "abc"

String s2 = new String(s);

s = "abc";

char[] c = s.toCharArray();

String s3 = new String(c);

String s4 = new String(c, 1, 3);    // [offset, offset + count) [)
String.valueOf( 一个参数Object/基本数据类型 ) 返回传入参数obj的toString(),若为空返回字符串"null"。 若为基本类型调用其 包装类的toString方法(Integer.toString(i))
char[] ch = {'a', 'b', 'c'};

String s5 = String.valueOf(ch);//char数组转换成string
方法: charAt, length, substring, equals, indexOf, lastIndexOf, replace, toCharArray, trim, split, toLowerCase, toUpperCase
.substring(int beginIndex, int endIndex);    // 返回字符片段[beginIndex, endIndex) --- O(n)

.substring(int beginIndex);    // 返回字符片段[beginIndex, end_of_String) 就是从beginIndex开始后面的 ---- O(n)

//indexOf 是(暴力查找字符串,不是KMP)

.indexOf(String str)    // 返回str第一个出现的位置(int),没找到则返回-1。 --- O(m * n) m为原串长度, n为str长度

s.indexOf(String str, int fromIndex);    // 同上,但从fromIndex开始找 --- O(m * n)

.lastIndexOf(String str);    // 返回str最后出现的位置(int),没找到则返回-1。 --- O(m * n) m为原串长度, n为str长度

// (假如要找一个字符char c,str可以表示成String.valueOf(c),然后作为参数传进去.

.lastIndexOf(String str, int fromIndex);    //从fromIndex开始从后往前找 [0 <- fromIndex] --- O(m * n)

.replace(char oldChar, char newChar);    // 返回一个新字符串String,其oldChar全部变成newChar --- O(n)

replaceAll(String s1,String s2);//用s2替换目标字符串中出现的所有s1

replaceFirst(String s1,String s2);//用s2替换目标字符串中出现的第一个s1

.toCharArray();    // 返回char[] 数组。 把String转换成字符数组 --- O(n)

.trim();    // 返回去除前后空格的新字符串 --- O(n)

.split(String regex);    // 返回 String[],以regex(正则表达式)拆分 ---- O(n)

// 从非"/"算起 若"/a/c" -> 会变成"" "a" "c"

String[] date = str.split("/");     // date[0]:1995 date[1]:12 date[2]:18 --- O(n)

//转换大小写

s = s.toLowerCase();    // 返回一个新的字符串全部转成小写 --- O(n)

s = s.toUpperCase();    // 返回一个新的字符串全部转成大写 --- O(n)
string的比较
compareTo(String anotherString)//按字典顺序比较两个字符串

compareToIgnoreCase(String anotherString)//按字典顺序且不区分大小写比较两个字符串

equals(String anotherString)//判断两个字符串是否相等,相等返回true否则返回false

equalsIgnoreCase(String str)//同上,不区分大小写。
如果a > b 返回大于0的整数, 如果a == b 返回0, 如果a < b 返回小于0的整数
其实是返回a和b第一个不同字符的差值。
搜索子串
indexOf(String str);//返回子串在此字符串中第一次出现的索引

indexOf(String str, int fromindex);//同上,从指定索引开始搜索

lastIndexOf(int ch);//返回指定字符在此字符串最后一次出现的索引

lastIndexOf(int ch, int fromindex);//同上, 从指定索引开始搜索

lastIndexOf(String str);//返回子串在此字符串最后一次出现的索引

lastIndexOf(String str, int fromindex);//同上, 从指定索引开始搜索

startsWith(String prefix);// 检查是否以某一前缀开始
其他类型转换为string
String.valueOf(char[] data);//返回 char数组的字符串表示形式

String.valueOf(char[] data,int offset, int count)//返回 char 数组参数的特定子数组的字符串表示形式

String.valueOf(int i);//返回 int 参数的字符串表示形式
string转换为其他类型
String sInt = "123";

int s = Integer.parseInt(sInt);

long ls = Long.parseLong(sInt);

char[] c = s.toCharArray();
stringbuilder
非线程安全
方法: append, charAt, length, setCharAt, insert, deleteCharAt, delete, reverse, toString
StringBuilder sb = new StringBuilder();

StringBuilder sb = StringBuilder(String str);//构建一个值为str的可变字符串。

.setCharAt(int index, char ch);    // 设置index位置的char为ch --- O(1)

.insert(int offset, String str);    // 在offer位置的插入字符串str--- O(m + n)

.deleteCharAt(int index);    // 删除index位置的char --- O(n)

.deleteCharAt(sb.length() - 1);    // 删除最后一个char --- O(1)

.delete(int start, int end);    // 删除[start, end)位置的char --- O(n)

.delete(int start, int end);//移除此序列从start到end-1的字符串

.reverse();    // 反转缓存字符串 --- O(n)

.toString();    // 返回一个与构建起或缓冲器内容相同的字符串 --- O(n)

append(String str);//在此字符串追加str。

append(StringBuilder str);//在此字符串追加str。

append(char[] str, int offset, int len);//将char的子数组追加到此字符串
查找
indexOf(String str);//返回子字符串第一次出现的索引

indexOf(String str, int fromIndex);//同上,从指定位置查找

lastIndexOf(String str);//返回子字符串最后一次出现的索引

lastIndexOf(String str, int fromIndex);//同上,从指定位置查找
集合
map
方法:put, get, getOrDefault, containsKey, containsValue, keySet, values, isEmpty, size
import java.util.HashMap;

import java.util.Iterator;

import java.util.Map;

public class TestMap {

        public static void main(String[] args) {

                Map<String, String> map = new HashMap<String, String>();

                map.put("1", "a");

                map.put("2", "b");

                map.put("3", "c");

                //最简洁、最通用的遍历方式

                for (Map.Entry<String, String> entry : map.entrySet()) {

                        System.out.println(entry.getKey() + " = " + entry.getValue());

                }

          //.keySet();    // 返回一个Set,这个Set中包含Map中所有的Key --- O(1)

          for (Character key : map.keySet()) {

    			// Operate with each key

					}

          //.values();    // 返回一个Collection<v>,里面全是对应的每一个value --- O(1)

          for (Integer value : map.values()) {

    			// Operate with each values

					}

        }

}
queue
方法:offer, poll, peek, isEmpty, size
import java.util.Queue;

import java.util.concurrent.LinkedBlockingQueue;

public class TestQueue {

        public static void main(String[] args) {

                Queue<Integer> q = new LinkedBlockingQueue<Integer>(); //初始化

          			//把把集合如Stack、Set、List等Collection作为参数

          			Set<Integer> s = new HashSet<>();

								Queue<Integer> q = new LinkedList<>(s);

                //初始化队列

                for (int i = 0; i < 5; i++) {

                        q.offer(i); //入队

                }

                System.out.println("-------1-----");

                //集合方式遍历,元素不会被移除

                for (Integer x : q) {

                        System.out.println(x);

                }

                System.out.println("-------2-----");

                //队列方式遍历,元素逐个被移除

                while (q.peek() != null) {

                        System.out.println(q.poll()); //出队

                }

        }

}
stack
方法:push, pop, peek, isEmpty, size
import java.util.Stack;

public class TestStack {

        public static void main(String[] args) {

                Stack<Integer> s = new Stack<Integer>();//初始化

                for (int i = 0; i < 10; i++) {

                        s.push(i); //入栈

                }

                //集合遍历方式

                for (Integer x : s) {

                        System.out.println(x);

                }

                System.out.println("------1-----");

                //栈弹出遍历方式

//                while (s.peek()!=null) {     //不健壮的判断方式,容易抛异常,正确写法是下面的

                while (!s.isEmpty()) {

                        System.out.println(s.pop()); //出栈

                }

                System.out.println("------2-----");

                //错误的遍历方式

//                for (Integer x : s) {

//                        System.out.println(s.pop());

//                }

        }

}
set
初始化
Set<Integer> set = new HashSet<>();

//把集合如Stack、Queue、List等Collection作为参数

List<Integer> list = new ArrayList<>....;

Set<Integer> set = new HashSet<>(list);
方法:add, remove, contains, isEmpty, size
优先队列 PriorityQueue (Heap)
底层是一颗数, 以小根堆为例
初始化
//小根堆

Queue<Integer> minH = new PriorityQueue<>();    // 小根堆,默认大小为11 相当于  new PriorityQueue<>(11)

Queue<Integer> minH = new PriorityQueue<>(100);  // 定义一个默认容量有100的小根堆。在当中增加元素会扩容,只是开始指定大小。不是size,是capacity

//大根堆

Queue<Integer> maxH = new PriorityQueue<>((i1, i2) -> i2 - i1);    // 大根堆,默认大小为11 相当于  new PriorityQueue<>(11, (i1, i2) -> i2 - i1)

Queue<Integer> maxH = new PriorityQueue<>(100, (i1, i2) -> i2 - i1);    // 定义一个默认容量有100的大根堆。在当中增加元素会扩容,只是开始指定大小
方法:offer, poll, peek, isEmpty, size
数组
静态数组
//一维

String[] s = new String[3];

char[] b = new char[]{'a', 'b'};

//二维

// 二维

int[][] c = new int[10][10];
.length 记得是属性而不是方法 arr.length 没有()
Arrays.sort从小到大排序
Arrays.sort(int[] arr)	//从小到大排序

Arrays.sort(int[] arr, int fromIndex, int toIndex) // [)

Arrays.sort(int[] arr, int fromIndex, int toIndex, 比较器); //一定是需要泛型

Arrays.sort(arr, (o1, o2) -> o2 - o1); //数组全部 从大到小排序 跟Collections.sort()一样

Arrays.sort(arr, 0, 3, (o1, o2) -> o2 - o1); //从大到小排序,只排序[0, 3)
Arrays.fill填满一个数组
int[] a = new int[5];

Arrays.fill(a, 1);
Arrays.copyOf / arr.clone()复制一个数组(二维数组也可以)
int [] a =  new int [ 5 ];

int [] newA = Array.copyOf(a,  5 );

// or

int [][] a = {{ 1 }, { 1 , 2 }, { 1 , 2 , 3 }, { 1 , 2 , 3 , 4 }, { 1 , 2 , 3 , 4 , 5 }};  // 不是5*5,第一维1 2 3 4 5

int [][] newa = a.clone();  // 不是5*5矩阵
相等比较
System.out.println(Arrays.equals(arr1,arr2))
arr1.equals(arr2)比较的是两个对象的地址,不是里面的数,而Arrays.equals重写了equals,所以,这里能比较元素是否相等。
二分查找法找指定元素的索引值(下标)
int []arr = {10,20,30,40,50};

System.out.println(Arrays.binarySearch(arr, 20));//找不到的话返回-x
截取数组:copeOf和copeOfRange
int []arr = {10,20,30,40,50};

int []arr1 = Arrays.copyOf(arr, 3);//截取arr数组的3个元素赋值给姓数组arr1  10 20 30

int []arr = {10,20,30,40,50};

int []arr1 = Arrays.copyOfRange(arr,1,3);// [) 10 20
动态数组
List<Integer> array = new ArrayList<>();    // 数组

List<Integer> list = new LinkedList<>();    // 链表

List<List<Integer>> = new ArrayList<>();	//二维数组
List接口方法:get, size, add, remove, subList
.get(int index)

.size()

.add(E e)    // 在尾部添加一个元素e --- O(1)

.add(int index, E e)    // 在index位置插一个元素e --- O(n)

.remove(int index)    // 删除位于index的元素,并返回删除元素e

list.remove(list.size() - 1);

.subList(int from, int to)    // 相当于返回原数组的一个片段,但不要对其进行改动,改动会影响原数组
Collections.sort(list); 从小到大排序
Collections.sort(list, (o1, o2) -> o2 - o1); 从大到小排序, 第二个参数为一个比较器
Math
Math.max(long a, long b)

Math.sqrt(double a)

Math.abs(double a) //返回一个类型和参数类型一致的绝对值

Math.pow(double a, double b)
取整
Math.ceil(double x);//向上取整

Math.floor(double x);//向下取整

Math.round(double x);//四舍五入
随机数,生成一个[0,1)之间的double类型的伪随机数
Math.random()

int a = (int)(Math.random()*b + 1); // [1, b]

int a = (int)(Math.random()*(b - a + 1) + a);	//[a, b]
Java刷题常用API的更多相关文章
- 牛客网Java刷题知识点之Map的两种取值方式keySet和entrySet、HashMap 、Hashtable、TreeMap、LinkedHashMap、ConcurrentHashMap 、WeakHashMap
不多说,直接上干货! 这篇我是从整体出发去写的. 牛客网Java刷题知识点之Java 集合框架的构成.集合框架中的迭代器Iterator.集合框架中的集合接口Collection(List和Set). ...
- 牛客网Java刷题知识点之ArrayList 、LinkedList 、Vector 的底层实现和区别
不多说,直接上干货! 这篇我是从整体出发去写的. 牛客网Java刷题知识点之Java 集合框架的构成.集合框架中的迭代器Iterator.集合框架中的集合接口Collection(List和Set). ...
- 牛客网Java刷题知识点之TCP、UDP、TCP和UDP的区别、socket、TCP编程的客户端一般步骤、TCP编程的服务器端一般步骤、UDP编程的客户端一般步骤、UDP编程的服务器端一般步骤
福利 => 每天都推送 欢迎大家,关注微信扫码并加入我的4个微信公众号: 大数据躺过的坑 Java从入门到架构师 人工智能躺过的坑 Java全栈大联盟 ...
- 牛客网Java刷题知识点之Java 集合框架的构成、集合框架中的迭代器Iterator、集合框架中的集合接口Collection(List和Set)、集合框架中的Map集合
不多说,直接上干货! 集合框架中包含了大量集合接口.这些接口的实现类和操作它们的算法. 集合容器因为内部的数据结构不同,有多种具体容器. 不断的向上抽取,就形成了集合框架. Map是一次添加一对元素. ...
- JS、JAVA刷题和C刷题的一个很重要的区别
就是最近在做树方面的题时,发现JS和JAVA刷题和C刷题的一个很重要的区别就是传入null的区别 当遍历的时候,C传参数时可以传进去null的指针,因为递归进去,出来时,指针还是指着那个地方 但是JS ...
- 牛客网Java刷题知识点之为什么HashMap和HashSet区别
不多说,直接上干货! HashMap 和 HashSet的区别是Java面试中最常被问到的问题.如果没有涉及到Collection框架以及多线程的面试,可以说是不完整.而Collection框架的 ...
- 牛客网Java刷题知识点之为什么HashMap不支持线程的同步,不是线程安全的?如何实现HashMap的同步?
不多说,直接上干货! 这篇我是从整体出发去写的. 牛客网Java刷题知识点之Java 集合框架的构成.集合框架中的迭代器Iterator.集合框架中的集合接口Collection(List和Set). ...
- 牛客网Java刷题知识点之垃圾回收算法过程、哪些内存需要回收、被标记需要清除对象的自我救赎、对象将根据存活的时间被分为:年轻代、年老代(Old Generation)、永久代、垃圾回收器的分类
不多说,直接上干货! 首先,大家要搞清楚,java里的内存是怎么分配的.详细见 牛客网Java刷题知识点之内存的划分(寄存器.本地方法区.方法区.栈内存和堆内存) 哪些内存需要回收 其实,一般是对堆内 ...
- 牛客网Java刷题知识点之HashMap的实现原理、HashMap的存储结构、HashMap在JDK1.6、JDK1.7、JDK1.8之间的差异以及带来的性能影响
不多说,直接上干货! 福利 => 每天都推送 欢迎大家,关注微信扫码并加入我的4个微信公众号: 大数据躺过的坑 Java从入门到架构师 人工智能躺过的坑 ...
随机推荐
- HTML的一些标签以及表单
HTML的一些标签以及表单 图片标签 属性 说明 src 图像的路径 alt 图像不能显示时的替换文字 title 鼠标悬停时显示的内容 border 设置图像边框的宽度 align 对齐方式 相对路 ...
- docker部署安装流程第一版
docker部署安装流程第一版 1.以Dockerfile的方式进行构建docker 以cloud 新联盟为例 dockerfile from hub.c.163.com/library/maven ...
- nginx的请求处理
nginx的请求处理¶ nginx使用一个多进程模型来对外提供服务,其中一个master进程,多个worker进程.master进程负责管理nginx本身和其他worker进程. 所有实际上的业务 ...
- ngx_lua模块
ngx_lua模块的原理: 1.每个worker(工作进程)创建一个Lua VM,worker内所有协程共享VM:2.将Nginx I/O原语封装后注入 Lua VM,允许Lua代码直接访问:3.每个 ...
- MegEngine推理性能优化
MegEngine推理性能优化 MegEngine「训练推理一体化」的独特范式,通过静态图优化保证模型精度与训练时一致,无缝导入推理侧,再借助工业验证的高效卷积优化技术,打造深度学习推理侧极致加速方案 ...
- 嵌入式Linux设备驱动程序:编写内核设备驱动程序
嵌入式Linux设备驱动程序:编写内核设备驱动程序 Embedded Linux device drivers: Writing a kernel device driver 编写内核设备驱动程序 最 ...
- JVM中的堆的新生代、老年代、永久代详解
JVM中的堆一般分为三大部分:新生代.老年代.永久代,其大致的占比如下: 一.新生代 新生代主要用来存放新生的对象.一般占据堆空间的1/3.在新生代中,保存着大量的刚刚创建的对象,但是大部分的对象都 ...
- 72 个网络应用安全实操要点,全方位保护 Web 应用的安全
原文地址:Web Application Security Checklist 原文作者:Teo Selenius(已授权) 译者 & 校正:HelloGitHub-小熊熊 & 卤蛋 ...
- Centos flock 防止脚本重复运行
如果crontab设定任务每分钟执行一次,但执行的任务需要花费5分钟,这时系统会再执行导致两个相同的任务在执行.发生这种情况下可能会出现一些并发问题,严重时会导致出现脏数据性能瓶颈等恶性循环.为了防止 ...
- 基于redis实现的四种常见的限流策略
引言 在web开发中功能是基石,除了功能以外运维和防护就是重头菜了.因为在网站运行期间可能会因为突然的访问量导致业务异常.也有可能遭受别人恶意攻击 所以我们的接口需要对流量进行限制.俗称的QPS也是对 ...