
Python爬虫-换行的匹配
之前在学习爬虫的时候遇到了匹配内容时发现存在换行,这时没法匹配了,后来在网上找到了一种方法,当时懒得记录,今天突然有遇到了这种情况,想想还是在这里记录一下吧。
当时爬取的时csdn首页博客,如下图
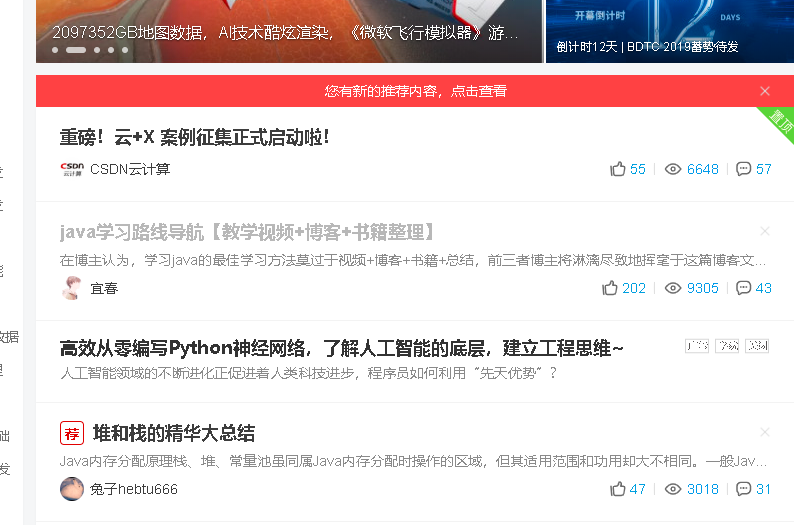
看了源代码,发现如果使用<a href="....来爬取的话,这样得到的会有许多其他的网址,并不全是我需要得博文,但是用<div class="title">去匹配后面的又出现了换行,但是换行匹配我又不会。。。。
re.compile()函数的一个标志参数叫re.DOTALL,它可以让正则表达式中的点(.)匹配包括换行符在内的任意字符。
pat = ' <div class="title">.*?<h2>.*?<a href="(.*?)" target="_blank"'   # 此时的.就可以匹配包括换行在内的任意字符

rst1 = re.compile(pat, re.DOTALL).findall(data)

import urllib.request

import re


url = "http://www.csdn.net/"

data = urllib.request.urlopen(url).read().decode("utf-8")

print(len(data))

pat = ' <div class="title">.*?<h2>.*?<a href="(.*?)" target="_blank"'

rst1 = re.compile(pat, re.DOTALL).findall(data)

print(len(rst1))

for i in range(0, len(rst1)):

    print(rst1[i])

    data = urllib.request.urlopen(rst1[i]).read().decode("utf-8", "ignore")

    urllib.request.urlretrieve(rst1[i], "D:\\python\\studyPython\\爬虫学习\\学习urllib\\blog\\"+str(i+1)+".html")

    print("爬取第:", i+1, "篇博客成功")

print("首页所有博客爬取结束")
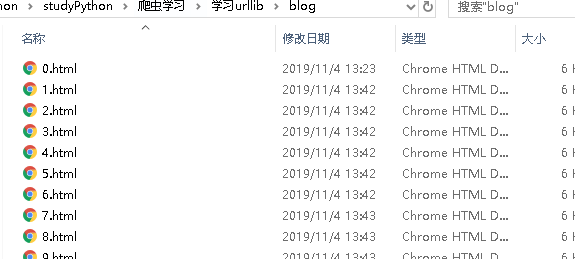
此时则爬取成功
Python爬虫-换行的匹配的更多相关文章
- Python正则表达式-换行的匹配
找到了之前参考的博文,用来记录一下https://www.cnblogs.com/baxianhua/p/8572805.html 平常 点 (.)去匹配任意字符的时候,是不能匹配换行符的 匹配换行: ...
- python爬虫成长之路(一):抓取证券之星的股票数据
获取数据是数据分析中必不可少的一部分,而网络爬虫是是获取数据的一个重要渠道之一.鉴于此,我拾起了Python这把利器,开启了网络爬虫之路. 本篇使用的版本为python3.5,意在抓取证券之星上当天所 ...
- 【Python爬虫】入门知识
爬虫基本知识 这阵子需要用爬虫做点事情,于是系统的学习了一下python爬虫,觉得还挺有意思的,比我想象中的能干更多的事情,这里记录下学习的经历. 网上有关爬虫的资料特别多,写的都挺复杂的,我这里不打 ...
- Python实战:Python爬虫学习教程,获取电影排行榜
Python应用现在如火如荼,应用范围很广.因其效率高开发迅速的优势,快速进入编程语言排行榜前几名.本系列文章致力于可以全面系统的介绍Python语言开发知识和相关知识总结.希望大家能够快速入门并学习 ...
- python爬虫之re正则表达式库
python爬虫之re正则表达式库 正则表达式是用来简洁表达一组字符串的表达式. 编译:将符合正则表达式语法的字符串转换成正则表达式特征 操作符 说明 实例 . 表示任何单个字符 [ ] 字符集,对单 ...
- Python爬虫初学(二)—— 爬百度贴吧
Python爬虫初学(二)-- 爬百度贴吧 昨天初步接触了爬虫,实现了爬取网络段子并逐条阅读等功能,详见Python爬虫初学(一). 今天准备对百度贴吧下手了,嘿嘿.依然是跟着这个博客学习的,这次仿照 ...
- 【转】Python爬虫:抓取新浪新闻数据
案例一 抓取对象: 新浪国内新闻(http://news.sina.com.cn/china/),该列表中的标题名称.时间.链接. 完整代码: from bs4 import BeautifulSou ...
- Python爬虫与数据分析之模块:内置模块、开源模块、自定义模块
专栏目录: Python爬虫与数据分析之python教学视频.python源码分享,python Python爬虫与数据分析之基础教程:Python的语法.字典.元组.列表 Python爬虫与数据分析 ...
- python爬虫之Beautiful Soup的基本使用
1.简介 简单来说,Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据.官方解释如下: Beautiful Soup提供一些简单的.python式的函数用来处理导航.搜索 ...
随机推荐
- WebStrom配置TypeScript开发环境
安装NodeJS node.js下载地址:https://nodejs.org/en/download/ 安装TypeScript npm install typescripot -g 新建tscon ...
- Vim最强调试插件:vimspector
最近看到了韦大在知乎的回答后,想去试用一下vimspector,却发现vimspector诞生两年了却没有介绍它的中文资料.我查阅官方文档遇到不少困难,在这里记录折腾出来的结果,与大家分享. vims ...
- 自定义Antd Pro 默认元素
概要 通用元素 修改的方式 主页面 标签上的图标 logo 和 系统名称 footer 的配置 loading 页面 最终效果 概要 使用 Antd Pro 来开发前端项目时, 生成的项目模板中, 一 ...
- 利用Python求解二元一次方程
本程序流程如下: (1)输入A.B.C (2)计算△ (3)判断解的个数 (4)计算解 (5)输出解 求:x2-3x+2=0的解 #输入A.B.C A=float(input("输入A:&q ...
- python 读取文件时报错UnicodeDecodeError
python 读取文件时报错UnicodeDecodeError: 'gbk' codec can't decode byte 0x80 in position 205: illegal multib ...
- spring boot:使用多个线程池实现实现任务的线程池隔离(spring boot 2.3.2)
一,为什么要使用多个线程池? 使用多个线程池,把相同的任务放到同一个线程池中,可以起到隔离的作用,避免有线程出错时影响到其他线程池,例如只有一个线程池时,有两种任务,下单,处理图片,如果线程池被处理图 ...
- centos8平台使用pidstat监控cpu/内存/io
一,安装pidstat: 1,安装 [root@localhost yum.repos.d]# yum install sysstat 2,查看版本: [root@localhost ~]# pids ...
- onedrive同步其他任意文件夹
经过多次尝试,成功同步其他文件夹内容到onedrive,最后那次尝试是成功的,前面是可能犯的错误.注意3点:1. 用管理员身份运行cmd:2. 路径有空格时用双引号括起来:3. /d后面接的第一个路径 ...
- 如何实现一个FormData
一.前言 最近项目中遇到一个问题,我们需要在cocos项目里去上传音频文件,而cocos原生环境和平时我们开发所在的浏览器环境和Node环境有很多差异,而cocos环境只提供了基础类,没有提供Form ...
- 【2】TensorFlow光速入门-数据预处理(得到数据集)
本文地址:https://www.cnblogs.com/tujia/p/13862351.html 系列文章: [0]TensorFlow光速入门-序 [1]TensorFlow光速入门-tenso ...