
oracle全文检索【转】【补】
全文检索
oracle对使用几十万以上的数据进行like模糊查询速度极差,包括 like 'AAA%' ,like '%AAA',like '%AAA%',like '%A%A%'的那些模糊查询。网上有很多文章讲到如何提高like查询,提到 like 'AAA%'能够使用到索引,而like '%AAA' ,使用创建反向函数的索引来提高查询效率。
为了解决大数据情况下的模糊查询速度慢的问题,oracle创建了全文检索技术.
即通过Oracle专利的词法分析器(lexer),将文章中所有的表意单元(Oracle称为term)找出来,记录在一组以dr$开头的表中,同时记下该term出现的位置、次数、hash值等信息。检索时,Oracle从这组表中查找相应的term,并计算其出现频率,根据某个算法来计算每个文档的得分(score),即所谓的‘匹配率’。而lexer则是该机制的核心,它决定了全文检索的效率。
oracle有三个基本的分词器
-- basic_lexer 针对英文,因为英文都用空格和标点分词,纯英文时建议用它
-- chinese_vgram_lexer 针对中文,支持所有汉字字符集,以字词为单元,分词较机械
-- chinese_lexer 针对中文,只支持utf8字符集,只认高频常用字词,效率更高,中文时建议用它.
数数据量达到百万级别以上时,在单列上建立的全文索引相比普通索引的查询速度那将是天差地别的.
准备工作
在使用前如果以下语句不能正常执行,那定是DBA没有给该User赋权限.
1检查和设置数据库角色
首先检查数据库中是否有CTXSYS用户和CTXAPP脚色。如果没有这个用户和角色,意味着你的数据库创建时未安装intermedia功能。你必须修改数据库以安装这项功能。默认安装情况下,ctxsys用户是被锁定的,因此要先启用ctxsys的用户。
ctxsys用户默认是被锁定的且密码即时失效,所以我们以sys用户进入em,然后修改ctxsys用户的状态和密码。
2赋权
以abc用户下的tbl_my_lex表为例.
先以sys用户DBA身份登录,对abc赋resource,connect权限:
GRANT resource, connect to abc;
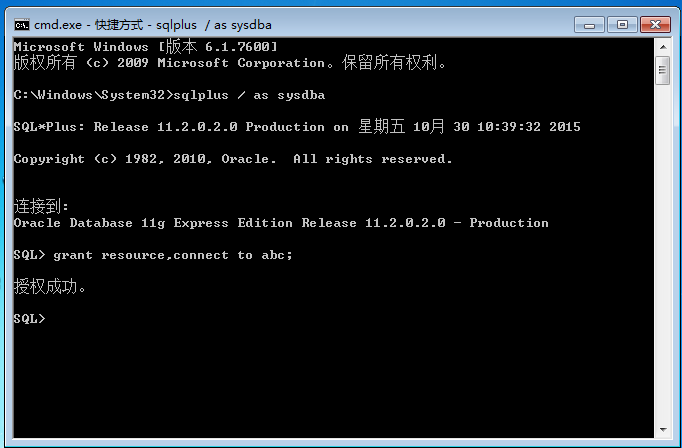
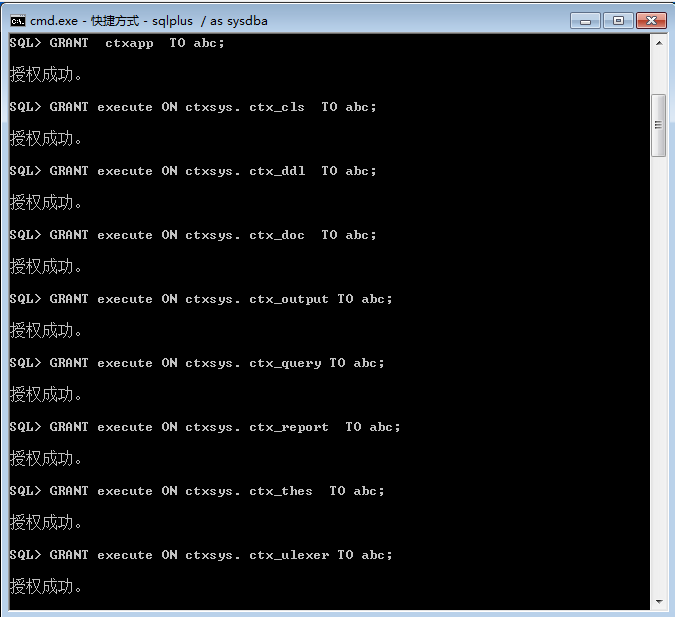
再以ctxsys用户登录并对abc用户赋权
GRANT  ctxapp  to  abc;

GRANT execute ON ctxsys. ctx_cls  TO abc;

GRANT execute ON ctxsys. ctx_ddl  TO abc;

GRANT execute ON ctxsys. ctx_doc  TO abc;

GRANT execute ON ctxsys. ctx_output TO abc;

GRANT execute ON ctxsys. ctx_query TO abc;

GRANT execute ON ctxsys. ctx_report  TO abc;

GRANT execute ON ctxsys. ctx_thes  TO abc;

GRANT execute ON ctxsys. ctx_ulexer TO abc;
基本语法
然后以abc用户登录 :
conn abc/abc;
--------------------------------------------------------------------------------------
-- 建表

Create table tbl_my_lex (id number primary key, info varchar2(1000));

Insert into tbl_my_lex values (1, 'this is a example for the basic_lexer');

Insert into tbl_my_lex values (2, 'he following example sets Printjoin characters ');

Insert into tbl_my_lex values (3, 'To create the INDEX with no_theme indexing ');

Insert into tbl_my_lex values (4, '中华人民共和国');

Insert into tbl_my_lex values (5, '中国淘宝软件');

Insert into tbl_my_lex values (6, '测试basic_lexer 是否支持中文');

Commit;
--------------------------------------------------------------------------------------
-- 创建一个名为my_chinese_lexer的chinese_lexer格式的分词器

Begin

ctx_ddl.create_preference('my_chinese_lexer', 'chinese_lexer');

End;

/
--------------------------------------------------------------------------------------
-- 对tbl_my_lex这张表的info列的信息建立一个名为IDX_TBL_COL的索引

Create index IDX_TBL_COL on tbl_my_lex (info) indextype is ctxsys.context parameters ('lexer my_chinese_lexer');
--------------------------------------------------------------------------------------
-- 以刚才建立的全文索引方式进行查询

Select * from tbl_my_lex where contains(info, '中国') > 0;

--------------------------------------------------------------------------------------
↑↑↑↑↑↑↑↑↑↑↑↑↑↑↑如果表是死的不会增删,那么到此为止就够了↑↑↑↑↑↑↑↑↑↑↑↑↑↑↑↑↑↑↑↑↑↑↑
↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓如果表是活的,会动态增加,那么继续往下看↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓
-- 存过1,同步索引,即把新增的记录,添加到索引的检索范围

begin

ctx_ddl.sync_index('IDX_TBL_COL');

end;

/

-- 意为如果新增一行记录,不用ctx_ddl .sync_index,

-- 直接 Select * from tbl_my_lex where contains(info, '中国') > 0;查到的结果是不会改变的
--------------------------------------------------------------------------------------
-- 存过2,同步索引,即把删除的记录,踢出索引的检索范围

begin

ctx_ddl.optimize_index('INX_CUSTOMINFO_ADDR_DOCS', 'FAST');

end;

/

-- 意为如果删除一行记录,不用ctx_ddl .sync_index,

-- 直接 Select * from tbl_my_lex where contains(info, '中国') > 0;查到的结果是不会改变的
--------------------------------------------------------------------------------------
-- 网上文章说: 65万记录的一个表建立索引只需要20分钟,同步一次约1分钟

-- 所以对存过1和存过2作job定时是很有必要的.
-- 其它语句
--------------------------------------------------------------------------------------
-- 删除一个名为my_chinese_lexer的chinese_lexer格式的分词器

Begin

ctx_ddl.drop_preference('my_chinese_lexer');

End;

/
--------------------------------------------------------------------------------------
DROP INDEX IDX_TBL_COL FORCE; -- 强行删除索引
--------------------------------------------------------------------------------------
参考
http://chaoji-liangbin.blog.163.com/blog/static/252392122010915101351354/
http://blog.chinaunix.net/uid-14107-id-2844042.html
http://blog.itpub.net/15962/viewspace-1005675/
oracle全文检索【转】【补】的更多相关文章
- oracle 全文检索
一.使用 sys 用户登录oracle (1)运行—cmd—sqlplus — sys/密码 @连接字符 as sysdba 二.授权 1.grant ctxapp to 全文检索使用用户: 2.gr ...
- 找到一篇关于 Oracle 全文检索实践 的文章
http://www.iteye.com/topic/1118055 有详细的例子记录了Oracle 全文检索的使用.
- oracle 全文检索创建脚本示例
--创建全文索引 grant execute on ctx_ddl to username;--使用其他帐号对username授权exec ctx_ddl.create_preference('my_ ...
- oracle全文检索
全文检索 oracle对使用几十万以上的数据进行like模糊查询速度极差,包括 like 'AAA%' ,like '%AAA',like '%AAA%',like '%A%A%'的那些模糊查询.网上 ...
- ORACLE SQL前端补0的三种方式。
前端补0的三种方式. select lpad(sal,8,'0') from emp;select to_char(sal,'00000000') from emp;select substr('00 ...
- oracle 全文检索技术
1.查看用户: select * from dba_users WHERE username='CTXSYS';select * from dba_users WHERE username='CTXS ...
- 转 Oracle全文检索http://docs.oracle.com/cd/E11882_01/text.112/e24436/toc.htm
SQL > exec ctx_ddl.create_preference ('my_test_lexer','chinese_lexer') : PL/SQL 过程成功完成 SQL > E ...
- Oracle 给字符串补空格、补0
利用lpad().RPAD()函数来实现给字符串补空格或补0的功能: 一.lpad()lpad函数将左边的字符串填充一些特定的字符其语法格式如下:lpad(string,n,[pad_string]) ...
- oracle不足位数补零的实现sql语句
select rpad('AAA',5,'0') from dual; 这样就可以了 [注意] 1.'AAA'为待补字符:5表示补齐后的总字符长度:0表示不足时补什么字符 2.rpad是右侧补0,左侧 ...
随机推荐
- 在WIN10打造成能运行Oracle的JDK的Linux
1.开发WindowsFeature(程序)里的Linux扩展接口(其实从Windows2008发布前试用时,就发现悄悄藏着一个Unix接口选项). 2.在windows应用商店可以下载到Ubuntu ...
- Maven2查看源码
- 【转帖】2018年Windows漏洞年度盘点
2018年Windows漏洞年度盘点丨老漏洞经久不衰,新0day层出不穷 腾讯电脑管家2019-02-12共17875人围观 ,发现 1 个不明物体网络安全资讯 https://www.freebuf ...
- [转帖]召冠总的 SQLSERVER常用的性能诊断语句. --保存学习备查
CopyFrom https://www.cnblogs.com/zhaoguan_wang /*常规服务器动态管理对象包括:dm_db_*:数据库和数据库对象dm_exec_*:执行用户代码和关联的 ...
- XHTML 簡介
XTML是可擴展的超文本標記語言. XHTML是比HTML更加嚴謹的HTML語言. 所有的瀏覽器都能識別XHTML. XHTML符合W3C標準,是為了替代HTML的.
- 修改maven的默认jdk版本
问题: 创建maven项目的时候,jdk版本默认使用的是1.5版本. 解决: 1.修改maven的settings.xml文件,添加如下: <profile> <id>jdk- ...
- linux 环境下 firefox乱码问题解决
https://blog.csdn.net/wlwlwlwl015/article/details/51482065
- BZOJ2069 POI2004ZAW(最短路)
显然这样的路径一定是选择了与1相邻的不同的两点分别作为起点和终点(除1本身).如果能将每一组起点终点都计算到就可以得出最优解了.暴力显然不行.注意到我们每次求出的是单源最短路径,考虑如何充分利用信息. ...
- window.onload和document.ready
浏览器解析大致有以下几个步骤: (1) 解析HTML结构 (2) 加载外部脚本和样式 (3) 解析并执行脚本代码 (4) 构造HTML DOM 模型 (5) ...
- Educational Codeforces Round 26 B,C
B. Flag of Berland 链接:http://codeforces.com/contest/837/problem/B 思路:题目要求判断三个字母是否是条纹型的,而且宽和高相同,那么先求出 ...