
尝试解决cifar10问题
我理解这个问题和猫狗的不同,在于将2类扩展为10类,其它的地方我准备采用相同的方法。
df=pd.read_csv('trainLabels.csv',header=0,sep=',')
#filename可以直接从盘符开始,标明每一级的文件夹直到csv文件,header=0表示头部为空第一行为标题
#sep=','表示数据间分隔符是逗号
print df.head()
print df.tail()
TRAIN_DIR = './train/'
TEST_DIR = './test/'

tmp = df[(df.label=="airplane ")]
train_airplane  =  [TRAIN_DIR+str(i)+'.png' for i in a.id]
print("train_airplane",len(train_airplane))
tmp = df[(df.label=="automobile ")]
train_automobile  =  [TRAIN_DIR+str(i)+'.png' for i in a.id]
print("train_automobile",len(train_automobile))
tmp = df[(df.label=="bird ")]
train_bird  =  [TRAIN_DIR+str(i)+'.png' for i in a.id]
print("train_bird",len(train_bird))
tmp = df[(df.label=="cat")]
train_cat =  [TRAIN_DIR+str(i)+'.png' for i in a.id]
print("train_cat",len(train_cat))
tmp = df[(df.label=="deer")]
train_deer =  [TRAIN_DIR+str(i)+'.png' for i in a.id]
print("train_deer",len(train_deer))
tmp = df[(df.label=="dog")]
train_dog  =  [TRAIN_DIR+str(i)+'.png' for i in a.id]
print("train_dog",len(train_dog))
tmp = df[(df.label=="frog")]
train_frog =  [TRAIN_DIR+str(i)+'.png' for i in a.id]
print("train_frog",len(train_frog))
tmp = df[(df.label=="horse")]
train_horse =  [TRAIN_DIR+str(i)+'.png' for i in a.id]
print("train_horse",len(train_horse))
tmp = df[(df.label=="ship")]
train_ship =  [TRAIN_DIR+str(i)+'.png' for i in a.id]
print("train_ship",len(train_ship))
tmp = df[(df.label=="truck")]
train_truck =  [TRAIN_DIR+str(i)+'.png' for i in a.id]
print("train_truck",len(train_truck))

test_images =  [TEST_DIR+str(i)+'.png' for i in os.listdir(TEST_DIR)]
print("test_images",len(test_images))
df=pd.read_csv('trainLabels.csv',header=0,sep=',')
train_airplane  =  [str(i)+'.png' for i in df[(df.label=="airplane")].id]
def show_cifar10(idx):
    airplane    = read_image(train_airplane[idx])
    automobile  = read_image(train_automobile[idx])
    bird        = read_image(train_bird[idx])
    cat         = read_image(train_cat[idx])
    deer        = read_image(train_deer[idx])
    dog         = read_image(train_dog[idx])
    frog        = read_image(train_frog[idx])
    horse       = read_image(train_horse[idx])
    ship        = read_image(train_ship[idx])
    truck       = read_image(train_truck[idx])
    pair = np.concatenate((airplane, automobile,bird,cat,deer,dog,frog,horse,ship,truck), axis=1)
    plt.figure(figsize=(10,5))
    plt.imshow(pair)
    plt.show()

for idx in range(0,5):
    show_cifar10(idx)

for filename in train_truck[:TESTNUM]:
    if(os.path.exists(TRAIN_DIR+filename)):
        os.symlink(TRAIN_DIR+filename,'./train2/truck/'+filename);
Unable to create link (Name already exists)
os.listdir(TEST_DIR)
/home/helu/cifar10/test/203688.png
/home/helu/cifar10/test/221824.png
/home/helu/cifar10/test/289334.png
/home/helu/cifar10/test/104194.png
/home/helu/cifar10/test/30977.png
os.path.exists(dirname):
os.listdir() #不给参数默认输出当前路径下所有文件
os.listdir('/home/python') #可以指定目录
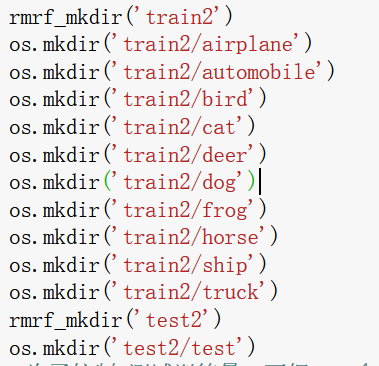
os.mkdir('test2/test')
os.symlink(TRAIN_DIR+filename, './train2/airplane/'+filename)
shutil.rmtree(dirname)
def rmrf_mkdir(dirname):
    if os.path.exists(dirname):
        shutil.rmtree(dirname)
    os.mkdir(dirname)
def show_cifar10(idx):
    airplane    = read_image(TRAIN_DIR+train_airplane[idx])
    automobile  = read_image(TRAIN_DIR+train_automobile[idx])
    bird        = read_image(TRAIN_DIR+train_bird[idx])
    cat         = read_image(TRAIN_DIR+train_cat[idx])
    deer        = read_image(TRAIN_DIR+train_deer[idx])
    dog         = read_image(TRAIN_DIR+train_dog[idx])
    frog        = read_image(TRAIN_DIR+train_frog[idx])
    horse       = read_image(TRAIN_DIR+train_horse[idx])
    ship        = read_image(TRAIN_DIR+train_ship[idx])
    truck       = read_image(TRAIN_DIR+train_truck[idx])
    pair = np.concatenate((airplane, automobile,bird,cat,deer,dog,frog,horse,ship,truck), axis=1)
    plt.figure(figsize=(10,5))
    plt.imshow(pair)
    plt.show()

for idx in range(0,5):
    show_cifar10(idx)

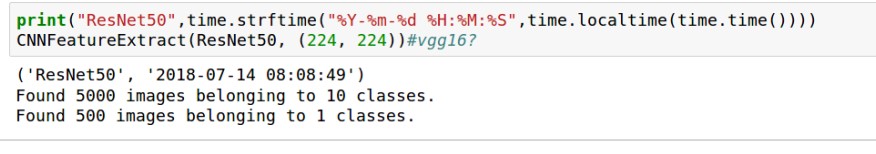
def CNNFeatureExtract(MODEL, image_size, lambda_func=None):
    width = image_size[0]                         #图像宽
    height = image_size[1]                        #图像高
    input_tensor = Input((height, width, 3))
    x = input_tensor
    if lambda_func:
        x = Lambda(lambda_func)(x)
    base_model = MODEL(input_tensor=x, weights='imagenet', include_top=False)     #这里全部使用no_top模型
    model = Model(base_model.input, GlobalAveragePooling2D()(base_model.output))

    gen = ImageDataGenerator()#使用了generate,并且使用的是文件夹模式
    train_generator = gen.flow_from_directory("train2", image_size, shuffle=False, batch_size=16)
    test_generator  = gen.flow_from_directory("test2", image_size, shuffle=False, batch_size=16, class_mode=None)

    train = model.predict_generator(train_generator)
    test = model.predict_generator(test_generator)

    with h5py.File("GoCifar10_%s.h5"%MODEL.func_name) as h:
        h.create_dataset("train", data=train)
        h.create_dataset("test", data=test)
        h.create_dataset("label", data=train_generator.classes)
尝试解决cifar10问题的更多相关文章
- 尝试解决在构造函数中同步调用Dns.GetHostAddressesAsync()引起的线程死锁
(最终采用的是方法4) 问题详情见:.NET Core中遇到奇怪的线程死锁问题:内存与线程数不停地增长 看看在 Linux 与 Windows 上发生线程死锁的后果. Linux: Microsoft ...
- 尝试解决IIS问题一些方法
尝试解决IIS问题一些方法 在控制面板中安装相关功能.添加相关角色 Win下注册IIS: C:\WINDOWS\Microsoft.NET\Framework\v4.0.30319\aspnet_re ...
- 卷积网络训练太慢?Yann LeCun:已解决CIFAR-10,目标 ImageNet
原文连接:http://blog.kaggle.com/2014/12/22/convolutional-nets-and-cifar-10-an-interview-with-yan-lecun/ ...
- 尝试解决IDea 启动项目后,后台疯狂输出日志。
今天启动项目的时候,昨天下班前还好好,然后今天就炸了.后台疯狂输出日志.. 就类似这种,大批量的刷.其实项目已经正常启动了,就是疯狂的刷日志. 2019-03-29 08:42:53 [DEBUG] ...
- MYSQL无法连接,提示10055错误尝试解决
解决方法:(以下内容为本人亲自实践原创)总结一下,应该是连接数的问题,那么服务器上有些什么连接数:1.IIS网站服务器中各个网站中有“连接超时时间”,“会话超时时间”:2.其它程序占用的服务器连接数( ...
- django在启动时抛出Error: [WinError 10013] 以一种访问权限不允许的方式做了一个访问套接字的尝试 解决办法
1.适用场景 在启动某个服务的时候,比如python中django启动的时候8000端口被占用,导致无法启动服务. 2.解决办法 通过命令行找出端口对应的PID进程 C:\Users\micha> ...
- [转][Java]尝试解决Java多行字符串的编辑问题
转自:https://blog.csdn.net/jiuwuerliu/article/details/51207045 参考了:https://www.v2ex.com/amp/t/445522 除 ...
- 尝试解决nginx的499错误1
- 当安装了ubuntu操作系统怎么也调用不出中文输入法时,可以用以下方式尝试解决。
卸载 fcitx sudo apt-get remove fcitx 重启 sudo reboot 重新安装 fcitxsudo apt-get isntall fcitx 安装拼音输入法sudo a ...
随机推荐
- Serveral effective linux commands
1. 统计当前文件夹下文件个数(不包括子目录下文件): $ ls -l | grep "^-" | wc -l 2. 统计当前文件夹下文件个数(包括子目录下文件): $ ls -l ...
- theos第一次编译成功,记录一下
theos 是github 90444af分支上的,下载设置环境变量 vi /etc/profile. 将/opt/theos/bin加入环境变量 运行nic.pl f 输入11生成工程,一路跳过 最 ...
- vue打包后404,webpack配置问题
首先声明这是基于vue2.x的 1. 将其中build的配置项assetsPublicPath进行修改,改为上图-->目的是将资源文件的引入路径,改为相对地址(相对index.html) 2.h ...
- ECC
素数 prime,又称为质数,是指,除了1和它本身,没有其他因数的数. 素数的定理: 1)在一个大于1的数a和它的2倍之间必定存在至少一个素数: 素数的性质: 1)在所有的大于10的质数中,个位数,只 ...
- 参数化define
SV中的define,可以是对var类型,也可以是对function类型的,或者其他任何可以直接替换的字符. `define wordsize 8 应用 logic [1 :·wordsize] ...
- html5-移动端布局模板
<!DOCTYPE html><html lang="en"><head> <meta charset="UTF-8&qu ...
- .net 缓存
缓存有很多实现方法,所有这些可以被分为两类,基于内存的缓存和基于磁盘的缓存: 1. 内存驻留缓存——包含在内存中临时存储数据的所有实现方法,通常在以下情况下使用: a) 应用程序频繁使用 ...
- HashMap集合存储自定义类
第一种情况,key为String,value为自定义类person类: 输出结果,key重复的被去掉了,key重复的那个value值之前的被最后一个覆盖了: 第二种情况,key为自定义类person类 ...
- HashMap 和 ConcurrentHashMap比较
基础知识: 1. ConcurrentHashMap: (JDK1.7) segment数组,分段锁:segment 内部是 HashEnty数组,类似HashMap: 统计长度的方法,先不加锁统计两 ...
- Codeforce 270A - Fancy Fence (正多边形)
Emuskald needs a fence around his farm, but he is too lazy to build it himself. So he purchased a fe ...